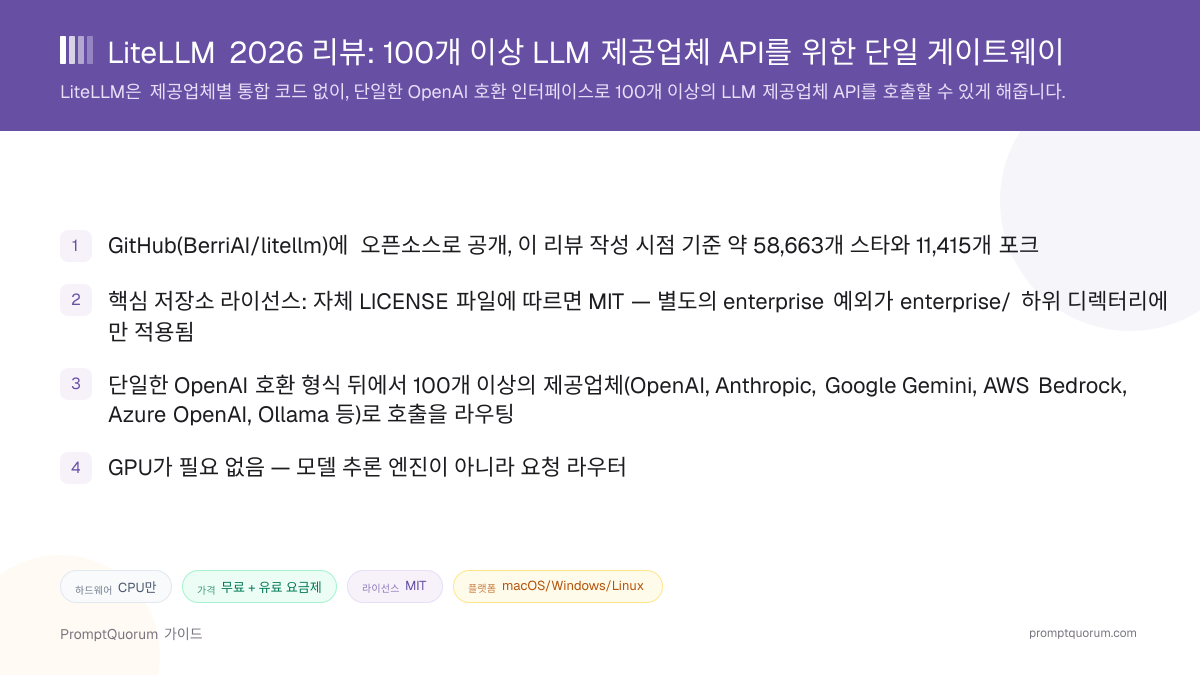
LiteLLM이란?
LiteLLM은 단일한 OpenAI 호환 요청 형식을 100개 이상의 서로 다른 LLM 제공업체 API 호출로 변환해주는 게이트웨이입니다. 자체 GitHub 저장소 설명에서는 스스로를 "가장 빠르고 가벼운 AI 게이트웨이"라고 설명하며, Rust 코어 위에 Python SDK를 얹은 구조로 되어 있습니다 — 이는 프로젝트 초기의 순수 Python 구현에서 벗어난 변화입니다. OpenAI API, Anthropic API, 로컬 Ollama 서버 각각에 대해 별도의 클라이언트 코드를 작성하는 대신, 애플리케이션은 LiteLLM을 한 번 호출하면 되고 LiteLLM이 해당 모델 이름에 설정된 제공업체로 요청을 전달합니다.
- 핵심 기능: OpenAI의
chat/completions형식(또는 대상 제공업체의 네이티브 형식)으로 요청을 받아, 설정된 제공업체로 전달하고, 정규화된 응답을 반환 - 두 가지 접근 방식: 애플리케이션 코드에 직접 가져다 쓰는 Python SDK
litellm, 그리고 다른 애플리케이션이 HTTP로 호출하는 독립 서비스인 LiteLLM Proxy Server - 개발사: github.com/BerriAI/litellm 저장소를 운영하는 조직 BerriAI
- 모델 런타임이 아님: LiteLLM 자체는 모델 가중치를 불러오거나 추론을 수행하지 않으며, 클라우드 API와 Ollama·vLLM 같은 로컬 서버를 포함해 실제로 그 작업을 수행하는 제공업체로 요청을 라우팅함
- 문서에 따른 프로덕션급 프록시 기능: 가상 API 키, 키별·사용자별 지출 예산, 속도 제한, 동일 모델의 여러 배포 간 로드 밸런싱, 제공업체 오류 시 자동 폴백
LiteLLM으로 무엇을 할 수 있나?
LiteLLM의 기능 세트는 요청 라우팅, 비용 통제, 신뢰성을 아우르며, 이는 LiteLLM 자체 문서에 따르면 제공업체와 사용자가 늘어날수록 더 어려워지는 LLM 기반 애플리케이션 운영의 영역들입니다.
- 통합된 API 표면 — OpenAI 형식으로 요청을 보내면 LiteLLM이 대상 모델의 제공업체가 요구하는 네이티브 형식으로 변환하고, 응답을 다시 정규화해 반환
- 라우팅과 로드 밸런싱 — 단일 장애 지점이나 속도 제한 상한을 피하기 위해 동일 모델의 여러 배포(예: 여러 Azure OpenAI 리전)에 트래픽을 분산
- 폴백 및 재시도 로직 — 실패한 요청을 최종 사용자에게 오류로 보여주는 대신 다른 제공업체나 모델 배포로 자동 재시도
- 비용 추적 및 예산 — API 키, 사용자, 팀 단위로 지출을 기록하고, 초과 시 추가 요청을 차단하는 엄격한 예산 한도를 설정
- 속도 제한 — 키 또는 사용자별로 분당 요청 수/토큰 수를 제한하며, Redis를 통해 여러 프록시 인스턴스에 걸쳐 일관되게 적용
- 가드레일과 로깅 — 콘텐츠 조정 및 관측 가능성 통합을 위한 훅, 그리고 감사용 구조화된 요청/응답 로깅
- 관리 대시보드 — 설정 파일을 직접 편집하지 않고도 가상 키를 관리하고, 지출을 확인하고, 모델을 구성할 수 있는 웹 UI(프록시의
/ui에서 제공) - 로컬 런타임과도 함께 작동 — OpenAI나 Anthropic을 호출하는 것과 동일한 라우팅 계층이 로컬 Ollama나 vLLM 엔드포인트도 똑같이 가리킬 수 있어, 하나의 게이트웨이로 클라우드 모델과 로컬 모델을 섞어 쓸 수 있음
사용 예시: LiteLLM을 쓰는 두 가지 방법
아래는 위에서 설명한 LiteLLM의 문서화된 설치 경로를 바탕으로 한 구체적인 워크플로우이며, 가상의 사용 사례가 아닙니다.
Python 스크립트 하나에서 여러 제공업체 호출하기
SDK를 설치(pip install litellm)한 뒤, openai, anthropic 또는 특정 제공업체 클라이언트에 대한 직접 호출을 `litellm.completion(model="gpt-4o", messages=[...]) 또는 litellm.completion(model="claude-opus-4", messages=[...])`로 대체합니다. 두 호출 모두 동일한 정규화된 응답 형태를 반환하므로, 제공업체를 바꾸는 것은 모델 이름 한 줄만 바꾸면 되는 일이지 전체 재작성이 아닙니다.
팀을 위한 셀프호스팅 게이트웨이 운영하기
LiteLLM Proxy Server(Docker 또는 Helm)를 배포하고, 이해하기 쉬운 모델 이름을 실제 제공업체 배포에 매핑하는 model_list가 담긴 config.yaml을 정의한 뒤, 개발자별 또는 앱별로 가상 API 키를 발급합니다. 이제 각 앱은 자체 OpenAI/Anthropic 키를 보관하는 대신 하나의 내부 엔드포인트를 호출하며, 지출은 관리 UI에서 중앙 집중적으로 추적됩니다.
하나의 엔드포인트 뒤에서 클라우드와 로컬 모델 섞기
config.yaml의 동일한 model_list에 클라우드 모델(예: openai/gpt-4o)과 Ollama 또는 vLLM으로 서빙되는 로컬 모델을 함께 추가합니다. 일상적이거나 개인정보에 민감한 트래픽은 로컬 모델로 라우팅하고, 필요할 때만 클라우드 모델로 확대하며, 호출하는 애플리케이션이 게이트웨이와 통신하는 방식은 바꿀 필요가 없습니다.
LiteLLM 설치: SDK, 프록시, Docker
LiteLLM은 프레임워크이자 셀프호스팅 게이트웨이이지, 최종 사용자용으로 다운로드하는 앱이 아닙니다 — 앱 스토어에서 "받아올" 설치 프로그램은 없습니다. 아래는 LiteLLM 자체 문서와 Docker 빠른 시작 가이드에 따른 실제 설치 및 빠른 시작 명령입니다. 정확한 플래그와 이미지 태그는 릴리스마다 바뀔 수 있으므로 배포 전에는 항상 문서를 직접 확인하세요.
Python SDK
- 명령어:
pip install litellm(또는uv add litellm)
Proxy Server(pip)
- 명령어:
- `pip install 'litellm[proxy]'
후litellm --model gpt-4o`
Proxy Server(Docker)
- 명령어:
docker run -v $(pwd)/config.yaml:/app/config.yaml -e OPENAI_API_KEY=<key> -e LITELLM_MASTER_KEY=sk-1234 -p 4000:4000 docker.litellm.ai/berriai/litellm:latest --config /app/config.yaml
Helm(Kubernetes)
- 명령어:
helm install litellm oci://ghcr.io/berriai/litellm-helm -f values.yaml
AWS ECS Fargate
- 명령어:
- 공식 Terraform 모듈
BerriAI/litellm/aws(VPC, Aurora PostgreSQL, ElastiCache Redis, ALB, ECS 프로비저닝)
Google Cloud Run
- 명령어:
- 공식 Terraform 모듈
BerriAI/litellm/google(Cloud SQL, Memorystore Redis, GCS, HTTPS 로드 밸런서 프로비저닝)
프록시는 기본적으로 4000번 포트를 사용하며, 관리 대시보드는 http://localhost:4000/ui에 있습니다(기본 로그인: 사용자 이름 admin, 비밀번호는 LITELLM_MASTER_KEY와 동일). 최소한의 config.yaml에는 model_name을 litellm_params(실제 제공업체 모델 문자열과 해당 API 키)에 매핑하는 model_list 배열이 필요합니다 — 전체 예시는 프록시 빠른 시작을 참고하세요. LiteLLM 배포 문서에 따르면 Render와 Railway도 프록시용 원클릭 배포 버튼을 제공합니다.
LiteLLM 가격: 정말 무료인가?
오픈소스 SDK와 Proxy Server는 무료입니다 — LiteLLM을 통해 라우팅하는 기본 제공업체 API 호출 비용과 자체 호스팅 비용만 지불하면 됩니다. LiteLLM 자체는 오픈소스 경로에서 요청당 또는 토큰당 요금을 부과하지 않습니다. 프로젝트 자체 사이트에 따르면 litellm.ai/enterprise에는 SSO, 우선 기능 요청, 전담 지원을 포함하는 별도의 유료 LiteLLM Enterprise 등급이 있습니다 — 이 리뷰에서는 공개된 Enterprise 가격을 찾지 못했으며, 견적은 LiteLLM에 직접 문의할 것을 권장합니다.
- 오픈소스 SDK와 Proxy Server: 라이선스 비용 없음, 핵심 저장소는 MIT 라이선스(아래 라이선스 참고 사항 참조)
- 라우팅 대상 제공업체에는 여전히 비용을 지불함 — LiteLLM은 OpenAI, Anthropic, Bedrock의 API 가격을 낮추지 않으며, 이를 통합하고 기록할 뿐임
- 프록시를 셀프호스팅하는 데는 자체 인프라 비용이 있음: 서버 또는 컨테이너 호스트, 그리고 프로덕션 사용을 위한 PostgreSQL과 Redis
- litellm.ai/enterprise에 따르면 LiteLLM Enterprise는 동일한 오픈소스 코어 위에 SSO, 우선 지원, 기타 비즈니스 기능을 추가함 — 가격은 공개되지 않았으며 회사에 문의해야 함
- Enterprise 요금은 연 단위이며 게이트웨이 요청 용량, 배포 구조, 지원 요구에 따라 책정되고 토큰 단위가 아닙니다(litellm.ai/pricing 기준). 30일 Enterprise 체험 키를 제공하며 견적은 영업팀을 통해 받습니다
- LiteLLM SSO 문서에 따르면 v1.76.0부터 SSO는 최대 5명까지 무료이며, 그 이상은 enterprise 라이선스가 필요합니다
LiteLLM vs. vLLM vs. LocalAI
LiteLLM, vLLM, LocalAI는 세 가지 모두 OpenAI 호환 API를 제공하기 때문에 혼동하기 쉽지만, 서로 다른 문제를 해결합니다. LiteLLM은 다른 곳에서 실행 중인 모델로 요청을 라우팅하며, vLLM과 LocalAI는 스스로 모델 가중치를 실행합니다.
항목 | LiteLLM | ||
|---|---|---|---|
| 하는 일 | 제공업체로 요청 라우팅 | 스스로 모델 서빙 | 스스로 모델 서빙 |
| 모델 가중치 실행 | 아니오 | 예 | 예 |
| 라이선스 | MIT(+ enterprise 예외) | Apache-2.0 | MIT |
| GPU 필요 여부 | 불필요(라우터 전용) | 실시간 서빙에는 필요 | 모델에 따라 다름 |
| 가장 적합한 용도 | 다중 제공업체 라우팅 및 지출 추적 | 고처리량 셀프호스팅 서빙 | 단일 셀프호스팅 OpenAI 호환 API |
이 도구들은 서로 대체재라기보다 함께 쓰이는 경우가 흔합니다: LiteLLM은 vLLM이나 LocalAI 배포 앞단에 라우팅 및 비용 추적 계층으로 위치할 수 있고, 실제 모델 추론은 vLLM이나 LocalAI가 수행합니다. 두 도구에 대한 자세한 내용은 전용 문서인 vLLM 설명과 LocalAI 설명을 참고하세요.
LiteLLM은 누구에게 적합한가?
LiteLLM이 적합한지는 애플리케이션이 이미 둘 이상의 LLM 제공업체를 호출하고 있는지, 또는 그럴 계획이 있는지에 달려 있습니다 — 단일 제공업체 앱은 라우팅 계층의 이점을 덜 얻습니다.
다음의 경우 LiteLLM을 사용하세요
- 애플리케이션이 두 개 이상의 LLM 제공업체를 호출하고 있으며(또는 그럴 계획이며), 제공업체별 통합 코드 대신 하나의 코드 경로를 원할 때
- 여러 앱, 팀, 고객에 걸쳐 중앙화된 비용 추적과 키별 또는 사용자별 예산이 필요할 때
- 주 제공업체가 오류를 내거나 속도를 제한할 때 두 번째 제공업체로 자동 폴백하기를 원할 때
- 동일한 엔드포인트 뒤에서 클라우드 모델과 로컬 호스팅 모델(Ollama 또는 vLLM 경유)을 섞고 싶을 때
- 라우팅 계층이 폐쇄형의 호스팅 전용 서비스가 아니라 오픈소스(MIT 코어)이기를 원할 때
다음의 경우 기다리거나 다른 대안을 찾으세요
- 애플리케이션이 하나의 제공업체만 호출하며 두 번째를 추가할 계획이 없는 경우 — 라우팅 계층은 즉각적인 이점 없이 운영 부담(운영해야 할 프록시 또는 SDK 의존성)만 늘림
- 라우터가 아니라 모델 서빙 엔진이 필요한 경우 — 실제로 모델 가중치를 실행하는 무언가가 필요함(vLLM 또는 LocalAI 참조)
- 셀프호스팅 프록시 대신 완전 관리형이고 운영이 필요 없는 라우팅 서비스를 원하는 경우 — OpenRouter 같은 호스팅 라우터는 PostgreSQL/Redis 운영 부담을 없애주지만 제3자를 거쳐야 함
- 라이선스 판단이 특히
enterprise/디렉터리 내부 코드에 좌우되는 경우 — 저장소 전체의 MIT 라이선스가 그곳에도 적용된다고 가정하지 말고enterprise/LICENSE를 직접 읽어보세요
LiteLLM vs. 다른 게이트웨이 및 프레임워크
LiteLLM은 PromptQuorum의 로컬 LLM 소프트웨어 디렉터리 중 라우터/게이트웨이 분야에 속하며, 같은 분야에 전용 리뷰가 세 건 더 있어 아래 목록의 앞부분에 두었습니다. 나머지 비교 대상은 디렉터리의 같은 "Run & Serve" 영역에 있는 인접 도구와 디렉터리 밖의 잘 알려진 호스팅형 대안입니다.
- Plano — 에이전트형 앱을 위한 Envoy 기반 셀프 호스팅 AI 프록시 겸 데이터 플레인으로, LLM 라우팅, 관측성, 가드레일을 제공합니다(Apache-2.0).
- ClawRouter — 에이전트용으로 설계된 셀프 호스팅 LLM 라우터로, 라우팅 결정을 로컬에서 내리며 최신 프런티어 모델과 무료 오픈 웨이트 모델 사이에서 요청을 분배합니다(MIT).
- AIClient2API — Gemini CLI, Codex, Grok, Kiro, Antigravity의 클라이언트 프로토콜을 하나의 OpenAI 호환 API로 변환하는 셀프 호스팅 프록시입니다(GPL-3.0).
- vLLM — 실제로 모델 가중치를 서빙하는 셀프호스팅 추론 엔진(GPU 필요). LiteLLM과 경쟁하기보다 함께 쓰이는 경우가 흔하며, LiteLLM이 하나 이상의 vLLM 배포 앞단에서 라우팅 계층 역할을 함.
- LocalAI — 오픈 모델을 로컬에서 실행하기 위한 셀프호스팅, OpenAI 호환 API 서버. LiteLLM과는 다른 문제(서빙 vs. 라우팅)를 해결하지만 비슷한 OpenAI 형식 API를 제공해 둘 사이에 흔한 혼동을 일으킴.
- LangChain — 체인, 에이전트, 메모리 등 LLM 기반 앱을 만들기 위한 애플리케이션 프레임워크. LiteLLM이 하는 일을 대체하는 대신, 모델 접근 계층으로 LiteLLM(또는 임의의 제공업체를 직접)을 호출할 수 있음.
- OpenRouter(외부, PromptQuorum 디렉터리에는 없음) — LiteLLM 프록시와 비슷한 다중 제공업체 사용 사례를 다루는 호스팅형 관리 라우팅 서비스이지만, 직접 호스팅하는 인프라가 아니라 호출하는 제3자 서비스임. 자체 프록시를 운영하는 대신 운영 부담 없는 라우팅을 원한다면 직접 비교해볼 가치가 있음.
LiteLLM 평가 시 흔한 오해
LiteLLM에 관한 혼동은 대부분 이를 모델 서빙 엔진과 혼동하거나, 라이선스를 지나치게 단순화하는 데서 비롯됩니다.
오해 1: LiteLLM이 모델을 스스로 실행한다고 가정하기
LiteLLM은 라우터입니다 — 당신이 지정한 제공업체 API나 로컬 런타임(Ollama, vLLM 등)으로 요청을 전달합니다. vLLM이나 LocalAI와 달리 스스로 모델 가중치를 불러오거나 추론을 수행하지 않습니다.
오해 2: 저장소 전체를 단순히 MIT로 취급하기
핵심 코드는 저장소 자체 LICENSE 파일에 따르면 MIT 라이선스이지만, enterprise/ 하위 디렉터리 안의 콘텐츠는 enterprise/LICENSE에 따라 별도로 라이선스됩니다. 포괄적인 MIT 조건이 적용된다고 가정하기 전에 실제로 어떤 파일을 사용하고 있는지 확인하세요.
오해 3: PostgreSQL과 Redis를 건너뛴 뒤 지출 데이터 누락이나 일관되지 않은 속도 제한을 겪기
litellm SDK 단독으로는 데이터베이스가 필요하지 않습니다. 셀프호스팅 Proxy Server는 가상 키와 지출 기록을 영구 저장하기 위해 PostgreSQL이, 둘 이상의 프록시 인스턴스에 걸쳐 일관된 속도 제한을 위해 Redis가 필요합니다 — 둘 다 없이 프록시를 운영해도 빠른 테스트에는 문제없지만, 규모가 커지면 이러한 기능을 잃게 됩니다.
오해 4: LiteLLM이 제공업체 API 가격을 낮춰줄 것이라고 기대하기
LiteLLM은 제공업체 간 비용을 추적하고 통합하지만, 이미 지불하고 있는 OpenAI, Anthropic, Bedrock의 기본 가격을 협상하거나 할인해주지 않습니다. 절감 효과는 라우팅/폴백이 낭비되는 재시도와 속도 제한으로 인한 지연을 피하는 데서 오는 것이지, 토큰당 가격이 달라지는 데서 오는 것이 아닙니다.
자주 묻는 질문
LiteLLM이란 무엇인가요?
LiteLLM(github.com/BerriAI/litellm)은 애플리케이션이 단일한 OpenAI 호환 인터페이스로 100개 이상의 LLM 제공업체 API를 호출할 수 있게 해주는 오픈소스 게이트웨이로, Python SDK로 이용하거나 라우팅·비용 추적·속도 제한을 갖춘 셀프호스팅 프록시 서버로 이용할 수 있습니다.
LiteLLM은 무료인가요?
오픈소스 SDK와 Proxy Server는 무료입니다 — 기본 제공업체 API 호출 비용과 자체 호스팅 비용만 지불하면 됩니다. 유료 LiteLLM Enterprise 등급은 5명을 넘는 SSO, 감사 로그, SLA가 포함된 24시간 연중무휴 지원을 추가하며, 영업팀 견적에 따른 연간 요금으로 요청 용량에 맞춰 책정되고 토큰 단위로 과금되지 않습니다. 30일 체험 키를 제공하며 요금은 공개되어 있지 않습니다.
LiteLLM은 기업 환경에서 사용하기에 적합한가요?
네. MIT 라이선스의 코어(enterprise/ 외의 모든 부분)는 상업적으로 사용할 수 있으며, 팀들은 가상 키, 예산, 지출 추적을 갖춘 공용 사내 게이트웨이로 운영합니다. 5명을 넘는 SSO, SCIM, 감사 로그, SLA가 포함된 지원에는 유료 Enterprise 라이선스가 필요하며, 해당 페이지에는 SOC 2 Type 2와 ISO 27001이 기재되어 있습니다(공급업체의 주장이며 이 리뷰에서는 검증하지 않았습니다). 개인정보 보호 규정 준수 여부는 요청을 보내는 제공업체와 구성에 따라 달라집니다. 이는 법률 자문이 아니므로 개인정보 보호 담당자와 상의하시기 바랍니다.
LiteLLM은 어떤 라이선스를 사용하나요?
핵심 저장소는 자체 LICENSE 파일에 따르면 MIT 라이선스입니다. enterprise/ 하위 디렉터리에만 enterprise/LICENSE에 따른 별도 라이선스가 적용됩니다 — 이 리뷰를 위해 저장소의 LICENSE 파일을 직접 확인해 검증했습니다.
LiteLLM에 GPU가 필요한가요?
아니요. LiteLLM은 모델 추론 엔진이 아니라 요청 라우터입니다 — 스스로 모델 가중치를 실행하는 대신 제공업체(클라우드 API 또는 Ollama 같은 로컬 런타임)로 호출을 전달하므로 CPU만 있는 하드웨어에서도 잘 작동합니다.
LiteLLM은 어떻게 설치하나요?
Python SDK: pip install litellm. 셀프호스팅 프록시: `pip install 'litellm[proxy]' 후 litellm --model gpt-4o를 실행하거나, config.yaml을 마운트해 Docker 이미지 docker.litellm.ai/berriai/litellm:latest`를 실행합니다. Helm, AWS ECS Fargate, Google Cloud Run 옵션은 위의 설치 표를 참고하세요.
LiteLLM 프록시에는 데이터베이스가 필요한가요?
프로덕션 사용에는 필요합니다 — LiteLLM 자체 배포 문서에 따르면 PostgreSQL이 가상 키와 지출 데이터를 영구 저장하고, Redis가 여러 프록시 인스턴스에 걸쳐 속도 제한을 일관되게 유지합니다. 빠른 로컬 테스트는 둘 다 없이도 실행할 수 있지만 이러한 기능은 잃게 됩니다.
LiteLLM은 로컬 호스팅 모델로 라우팅할 수 있나요?
네. OpenAI나 Anthropic을 가리키는 config.yaml의 동일한 model_list가 로컬 Ollama나 vLLM 엔드포인트도 똑같이 가리킬 수 있어, 하나의 게이트웨이로 클라우드 모델과 로컬 모델을 섞어 쓸 수 있습니다.
LiteLLM은 OpenRouter와 비교하면 어떤가요?
둘 다 여러 LLM 제공업체를 하나의 인터페이스 뒤로 통합합니다. LiteLLM은 직접 운영하는 셀프호스팅 인프라(오픈소스 프록시 또는 SDK)이고, OpenRouter는 직접 운영하는 대신 호출하는 제3자 호스팅 라우팅 서비스입니다. 운영 부담이 없는 것(OpenRouter)을 원하는지, 라우터 제공업체의 요청당 마크업 없이 완전한 통제권(셀프호스팅 LiteLLM)을 원하는지에 따라 선택이 달라집니다.
LiteLLM은 누가 개발하나요?
github.com/BerriAI/litellm 저장소를 운영하는 조직인 BerriAI이며, 이 리뷰 작성 시점 기준 61,000개 이상의 스타를 보여줍니다.