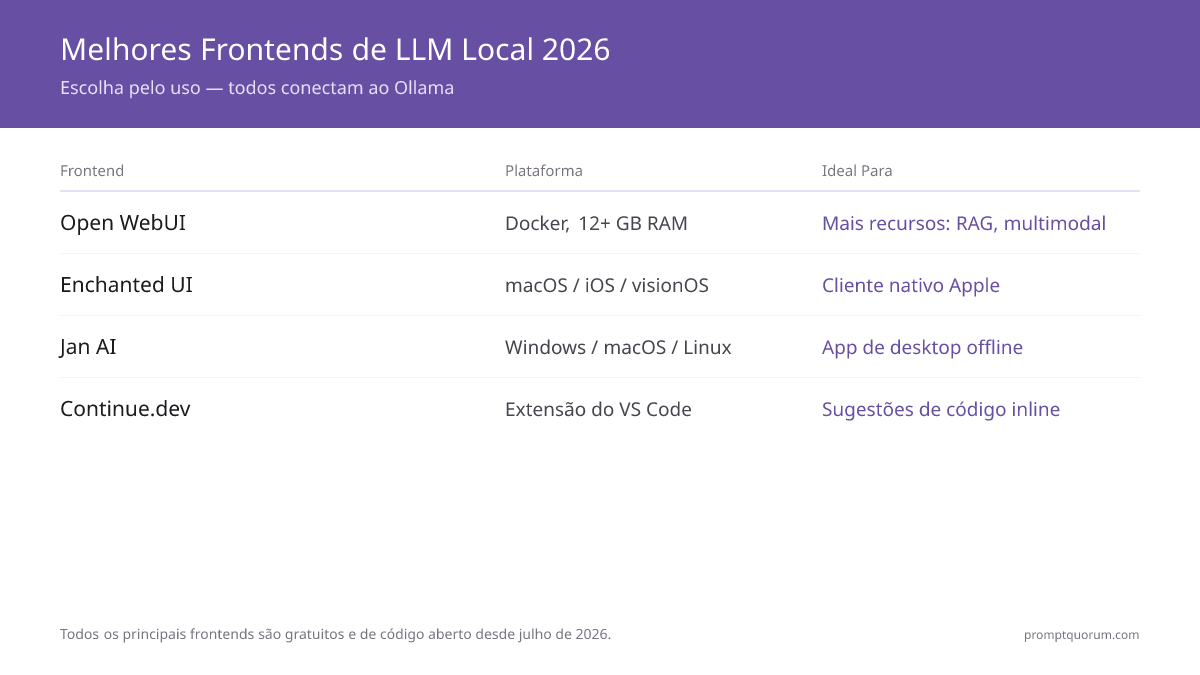
Os 8 principais frontends para LLMs locais: comparativo de recursos
Frontend | Tipo | Ideal para | Tempo de setup | RAM necessária | Código aberto |
|---|---|---|---|---|---|
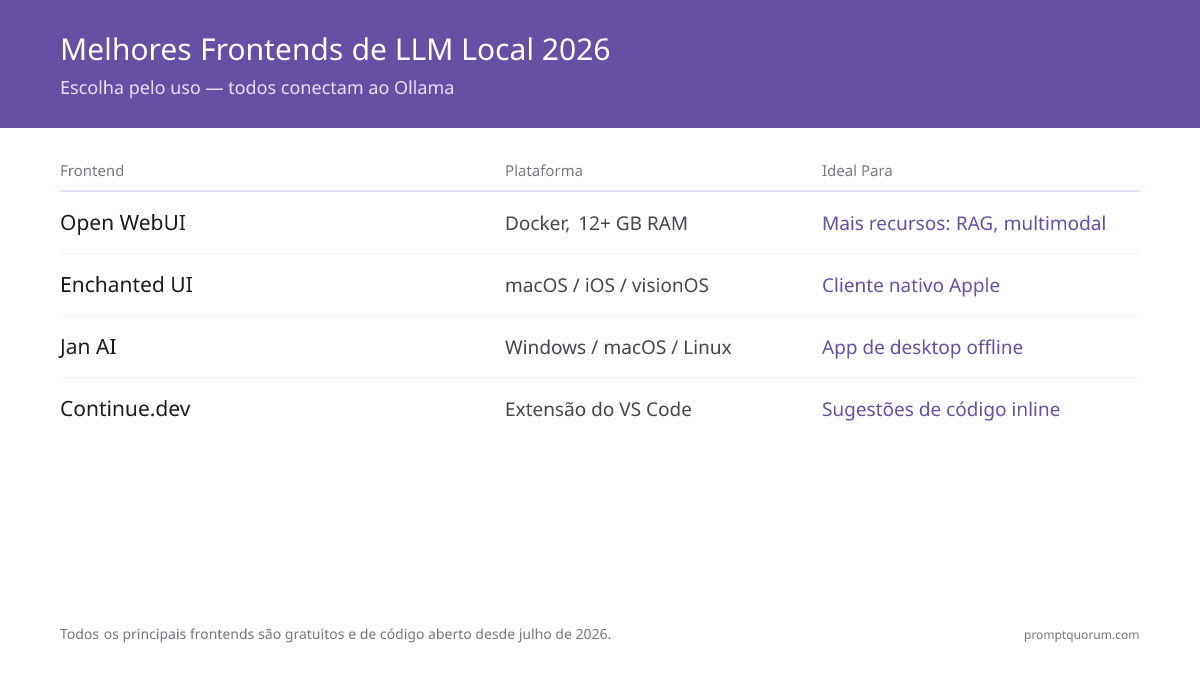
| Open WebUI | App web (Docker/pip) | Muitos recursos, RAG, equipes | 5 min (com Docker) | 12 GB+ | Código disponível (cláusula de marca) |
| App desktop do Ollama | App nativo (macOS/Windows) | Chat básico, sem instalar nada extra | ~2 min | 8 GB+ | Sim (repositório MIT) |
| Enchanted UI | App nativo (iOS/macOS/visionOS) | Apple (sem atualização desde julho de 2026) | ~2 min (App Store) | 8 GB+ | Sim (Apache-2.0) |
| Jan AI | App desktop | Usuários não técnicos, offline | 3 min (instalação) | 8 GB+ | Sim (Apache-2.0) |
| Continue.dev | Extensão do VS Code | Código (desenv. parado em junho de 2026) | 2 min (instalar extensão) | 8 GB+ | Sim (Apache-2.0) |
| LobeHub (Lobe Chat) | App web | Privacidade, personalização | 5 min | 8 GB+ | Licença da comunidade (base Apache) |
| Gradio / Streamlit | Bibliotecas Python | Interfaces personalizadas, dashboards | 5 min (Python) | 8 GB+ | Sim (Apache-2.0) |
| TextGen (antigo Text-generation-webui) | Web (complexo) | Experimentação, usuários avançados | 15 min | 12 GB+ | Sim (AGPL-3.0) |
O que faz do Open WebUI o frontend mais popular?
O Open WebUI é o frontend para LLMs locais com mais estrelas neste guia, com mais de 150.000 estrelas no GitHub -- ele reúne RAG, multimodal, busca na web e colaboração multiusuário em um único contêiner Docker ou pacote Python. Funciona com Ollama, LM Studio ou qualquer API compatível com OpenAI. Versão mais recente: v0.12.3 (16 de outubro de 2026).
Principais recursos:
- RAG (Retrieval-Augmented Generation): envie documentos (PDFs, arquivos de texto) e faça o modelo responder perguntas sobre eles.
- Suporte multimodal: envie imagens e faça perguntas sobre elas.
- Integração com busca na web: o modelo pode pesquisar na web para obter informações atuais.
- Bases de conhecimento: crie coleções persistentes de documentos que o modelo consulta.
- Function calling e ferramentas: monte fluxos em que o modelo chama funções ou ferramentas.
- Colaboração em equipe: vários usuários podem compartilhar a mesma instância.
- Marketplace de modelos: navegue e baixe modelos direto da interface.
A principal limitação é o esforço de configuração. O Docker é a instalação oficialmente recomendada (cerca de 5 minutos); `pip install open-webui` (Python 3.11 ou 3.12) e um app desktop são as alternativas. Depois de rodando, ele adiciona RAG, multimodal, multiusuário e busca na web -- recursos que as alternativas leves não oferecem.
Licença: o código até a v0.6.5 é BSD-3-Clause. A partir da v0.6.6 (abril de 2025), o Open WebUI usa uma licença modificada com uma cláusula de marca: você não pode remover nem alterar a marca "Open WebUI", a menos que tenha 50 usuários ou menos em qualquer período de 30 dias, tenha permissão por escrito ou possua uma licença empresarial. Ele é gratuito para rodar, mas a própria página de licença afirma que não é uma licença de código aberto aprovada pela OSI.
# Run Open WebUI with Docker (5 min setup)
docker run -d -p 3000:8080 --add-host=host.docker.internal:host-gateway \
  -e OLLAMA_BASE_URL=http://host.docker.internal:11434 \
  --name open-webui ghcr.io/open-webui/open-webui:latest

# Then open http://localhost:3000 in your browser

# Alternative without Docker (Python 3.11 or 3.12)
pip install open-webui
open-webui serve   # then open http://localhost:8080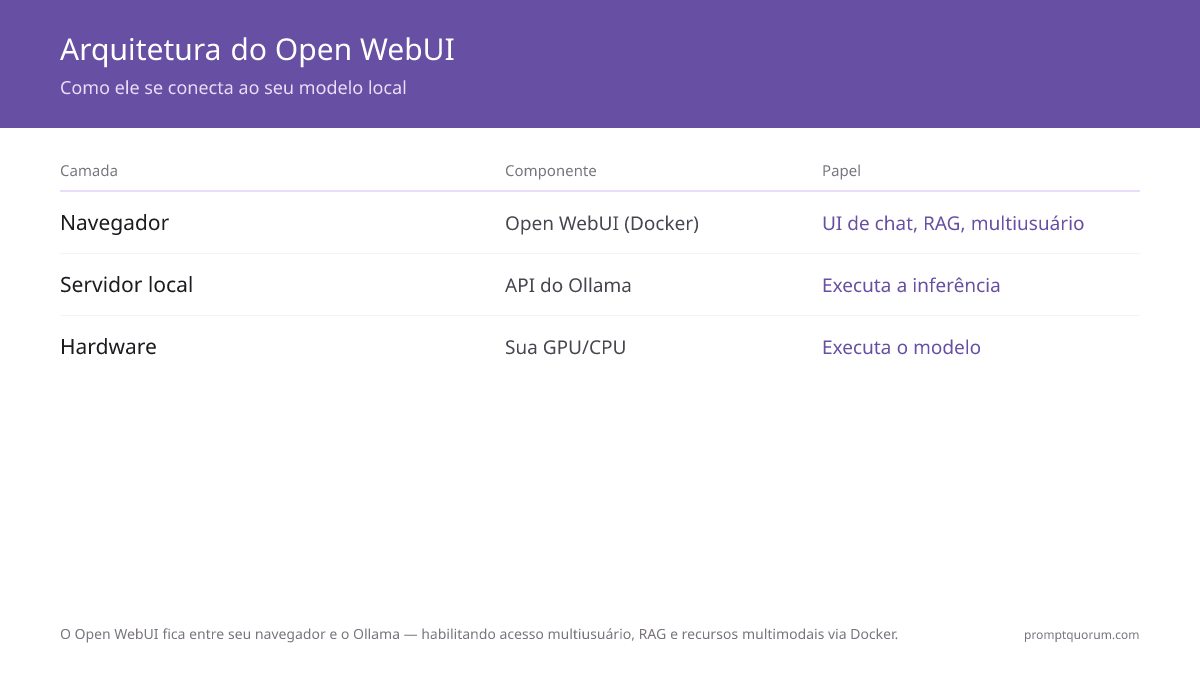
•⚠️ Aviso: O Docker é a forma recomendada de rodar o Open WebUI. Se o Docker não estiver instalado, some 10 a 15 minutos ao tempo de configuração (rode `docker --version` para verificar) ou use a instalação via pip mostrada abaixo.
•💡 Dica profissional: A autenticação vem ativada por padrão (WEBUI_AUTH=True) e, na primeira execução, o app pede que você crie uma conta de administrador. Crie essa conta você mesmo antes de expor a instância a uma rede, principalmente em implantações multiusuário ou de equipe.
Por que escolher o Enchanted UI como app nativo para Apple?
⚠️ Sem atualização desde 7 de julho de 2026 (há mais de 3 meses) -- este projeto pode estar sem manutenção. Verifique o repositório antes de depender dele. A versão mais recente com tag é a v1.8.2 (15 de junho de 2026).
O Enchanted UI é um app nativo para iOS, macOS e visionOS para conversar com o seu modelo Ollama local -- instale pela App Store ou compile a partir do código-fonte e aponte para o endereço do seu servidor Ollama. O projeto de código aberto tem mais de 6.000 estrelas no GitHub e usa a licença Apache-2.0, sendo a opção nativa mais refinada para hardware Apple neste guia.
Principais recursos:
- App nativo da Apple: roda no iPhone, iPad, Mac e Apple Vision Pro com uma interface no estilo ChatGPT -- não é uma aba do navegador.
- Entrada multimodal: aceita comandos de voz e anexos de imagem, além de texto.
- Privado: o histórico de conversas fica no seu dispositivo e na sua rede; nada é enviado a servidores de terceiros.
- Integração com o Spotlight do macOS e modo escuro: abra conversas pelo Spotlight; interface limpa e moderna.
O Enchanted UI atende usuários Apple que querem um app nativo, parecido com o ChatGPT, em vez de uma aba do navegador ou de um contêiner Docker. Ele não tem RAG nem bases de conhecimento, mas para o chat do dia a dia no iPhone, iPad, Mac ou Vision Pro é a opção mais refinada deste guia -- desde que você aceite o risco de manutenção descrito acima.
# 1. Start your Ollama model
ollama run llama3.2:3b

# 2. Install Enchanted UI from the App Store (iOS/macOS/visionOS)
# or build from source: https://github.com/gluonfield/enchanted

# 3. In Enchanted UI settings, enter your Ollama server address
# (localhost:11434 on the same Mac, or the Mac's LAN IP from iOS/visionOS)•💡 Dica profissional: No macOS, o Enchanted UI usa por padrão o Ollama em localhost:11434. No iOS ou visionOS, você precisa informar manualmente o endereço de rede do seu Mac (por exemplo, http://192.168.1.x:11434) em Ajustes, porque o celular ou o headset não alcança "localhost" de outra máquina. Sempre rode `ollama serve` (ou abra o app do Ollama) antes.
Por que o Jan AI é o melhor para usuários de desktop?
O Jan AI é um app desktop (Windows, macOS, Linux) que reúne gerenciamento de modelos, inferência e chat em um único aplicativo offline -- sem configurar servidor nem Docker. É parecido com o LM Studio, mas de código aberto (Apache-2.0) e apoiado por uma abordagem conduzida pela comunidade. Versão mais recente: v0.8.7 (20 de outubro de 2026).
Principais recursos:
- Offline em primeiro lugar: os modelos ficam armazenados no seu dispositivo; não é preciso internet para conversar.
- GPU com fallback para CPU: usa a GPU automaticamente quando disponível (incluindo aceleração AMD ROCm/HIP no Linux, adicionada na v0.8.2) e recorre à CPU quando não há.
- Privado por padrão: não exige conta; as análises de uso só são coletadas se você permitir na primeira execução.
- Marketplace de extensões: adicione plugins como RAG, busca na web ou ferramentas.
O Jan é ideal para usuários não técnicos que querem um app desktop refinado. O Jan AI tem mais de 45.000 estrelas no GitHub e suporte nativo completo em Windows, macOS e Linux -- é uma alternativa madura ao LM Studio, com forte apoio da comunidade.
•📌 Ponto-chave: O Jan AI armazena os modelos em ~/jan/models -- separado do cache de modelos do Ollama. Se você usa os dois, os modelos baixados não são compartilhados e o uso de disco dobra para qualquer modelo usado nos dois apps.
Como usar o Continue.dev para completar código?
⚠️ Desenvolvimento parado: nenhuma versão desde 19 de junho de 2026 (há mais de 4 meses). Este projeto pode estar sem manutenção -- verifique antes de depender dele.
O Continue.dev transforma o seu modelo Ollama local em sugestões de código em linha dentro do VS Code ou do JetBrains -- a configuração leva 2 minutos e não exige chave de API na nuvem. Quando você começa a digitar, o Continue sugere complementos com base no seu modelo local.
A Cursor adquiriu o Continue em junho de 2026 e a última versão saiu em 19 de junho de 2026 -- a extensão do VS Code e o plugin do JetBrains ainda instalam e funcionam com um modelo Ollama local, mas não há novas atualizações previstas.
Configuração (2 minutos):
1. Instale o Continue pelo marketplace do VS Code.
2. Aponte para a sua instância do Ollama (Config → Configure Continue → Add localhost:11434).
3. Comece a digitar código e pressione Tab para aceitar uma sugestão.
O Continue ainda atende desenvolvedores que querem sugestões de código sem enviar código para APIs na nuvem, mas uma ferramenta que continua recebendo atualizações é a escolha mais segura a longo prazo. O Tabby, um servidor de autocompletar código de código aberto e auto-hospedado, é a alternativa mais próxima, mas seu repositório também está parado desde 30 de junho de 2026 (versão mais recente v0.32.0, de 25 de janeiro de 2026), então verifique-o antes de adotá-lo. Veja LLMs locais com VS Code e Cursor para opções atuais.
•⚠️ Aviso: A Cursor adquiriu o Continue em junho de 2026 e o desenvolvimento parou -- a extensão ainda funciona com o Ollama, mas não espere novos recursos nem correções de bugs. O Tabby, a alternativa auto-hospedada mais próxima, também não tem atividade no repositório desde 30 de junho de 2026.
•💡 Dica profissional: Para completar código, o Qwen2.5-Coder 7B (`ollama run qwen2.5-coder:7b`) é um modelo especializado em código, mais adequado para sugestões do que modelos de chat gerais como o Llama 3.2. Selecione-o na configuração do Continue depois de instalar.
Quais frontends leves e alternativas ao Open WebUI vale a pena testar?
Se o Open WebUI parecer pesado demais, comece pelo app desktop do Ollama ou pela extensão de navegador Page Assist; se o seu foco principal é perguntar sobre documentos, experimente o AnythingLLM. Cada opção abaixo se conecta à mesma API local do Ollama (localhost:11434).
- App desktop do Ollama -- Chat integrado para macOS e Windows: baixe modelos, arraste arquivos de texto ou PDFs e envie imagens para modelos multimodais. Nada mais para instalar. Baixe em ollama.com/download.
- Page Assist -- Chat em barra lateral do navegador para Chrome e Firefox, com mais de 8.000 estrelas no GitHub (MIT). A opção mais leve: sem servidor extra nem Docker. Versão mais recente v1.5.88 (18 de outubro de 2026) no GitHub.
- AnythingLLM -- App desktop e imagem Docker construídos em torno de workspaces de RAG, com mais de 67.000 estrelas no GitHub (MIT). Versão mais recente v1.18.0 (13 de outubro de 2026) no GitHub.
- LM Studio -- App desktop de código fechado (gratuito para uso pessoal e comercial) com chat integrado e um servidor local compatível com OpenAI em localhost:1234, que o Open WebUI e outros frontends podem usar como backend. Veja o changelog (última atualização em 12 de outubro de 2026).
- Cherry Studio -- Cliente desktop multiprovedor com bases de conhecimento integradas e mais de 52.000 estrelas no GitHub (AGPL-3.0). Versão mais recente v2.1.7 (19 de outubro de 2026). Leia a análise do Cherry Studio.
•📌 Ponto-chave: Para uma comparação lado a lado, veja LM Studio vs Jan AI e LobeChat, Big-AGI, NextChat, Page Assist e Chatbox comparados.
Auto-hospedar ou usar um frontend na nuvem?
Todos os frontends deste guia rodam na sua máquina ou no seu servidor -- nenhum dado de prompt sai do seu dispositivo e não há custo de API. A alternativa são frontends na nuvem, como ChatGPT, Claude ou Gemini, que se conectam a servidores remotos.
- Escolha auto-hospedado se: você tem dados sensíveis, quer custo zero de API, quer personalizar a interface ou está offline.
- Escolha a nuvem se: você precisa da melhor qualidade de modelo, não quer gerenciar infraestrutura ou tem baixo volume de uso.
- Use os dois em paralelo: ferramentas como o PromptQuorum permitem enviar um prompt ao mesmo tempo para o seu modelo local e para APIs na nuvem, e comparar os resultados lado a lado.
•📌 Ponto-chave: Todos os frontends podem apontar para a mesma instância do Ollama -- localhost:11434 na mesma máquina ou o IP da sua máquina na rede local para apps móveis como o Enchanted UI. Trocar de frontend não exige baixar os modelos de novo -- o Ollama mantém todos os modelos baixados, não importa qual frontend você use.
Como as regras regionais de conformidade afetam a escolha do frontend?
Brasil (LGPD)
Para organizações brasileiras que implantam frontends para LLMs locais, o controle sobre os dados pessoais é o principal motivo. Todos os 8 frontends deste guia podem rodar inteiramente em infraestrutura própria -- nenhum conteúdo de prompt, histórico de conversa ou documento enviado precisa sair do seu ambiente. Isso se alinha aos princípios da LGPD (Lei nº 13.709/2018), como necessidade e minimização, e pode reduzir a necessidade de repassar dados pessoais a um fornecedor de inferência na nuvem.
Em setores regulados (saúde, jurídico, financeiro), o Open WebUI é uma escolha comum porque guarda o histórico de conversas no seu próprio servidor e oferece papéis de usuário e controles de administração. Como medida técnica básica, mantenha a autenticação ativada no Open WebUI (ela vem ativada por padrão, `WEBUI_AUTH=True`), crie você mesmo a conta de administrador antes de expor a instância e restrinja o acesso a usuários autorizados. O art. 46 da LGPD trata das medidas de segurança técnicas e administrativas; este guia não constitui aprovação da ANPD nem parecer jurídico. Cabe ao seu encarregado de dados (DPO) e à sua assessoria jurídica avaliar se a sua implantação atende às obrigações aplicáveis.
Portugal e Europa (RGPD)
Para organizações em Portugal e na União Europeia, o mesmo raciocínio vale sob o RGPD: rodar os frontends em infraestrutura própria pode evitar a relação com um operador de tratamento externo para o conteúdo das conversas. Confirme os detalhes com a autoridade de proteção de dados do seu setor ou com assessoria jurídica.
Licenças para organizações
A cláusula de marca do Open WebUI (v0.6.6 e posteriores) exige manter a marca visível em implantações com mais de 50 usuários em um período de 30 dias, a menos que você tenha uma licença empresarial. Peça uma revisão jurídica antes de implantá-lo em toda a empresa ou de usá-lo em white-label. Os demais frontends deste guia usam Apache-2.0 (Jan AI, Enchanted UI), AGPL-3.0 (TextGen) ou licenças da comunidade (LobeHub).
•⚠️ Aviso: Em setores regulados (saúde, jurídico, financeiro): a autenticação é uma medida técnica necessária, mas a adequação à LGPD exige uma avaliação mais ampla das medidas técnicas e administrativas. Mantenha a autenticação do Open WebUI ativada, crie a conta de administrador antes de expor a instância e consulte o seu encarregado de dados (DPO).
•🔍 Você sabia?: Documentar as versões das ferramentas de IA em produção facilita auditorias internas. A versão do Open WebUI aparece em Settings → About, e fixar as imagens Docker em uma tag de versão específica (em vez de :latest) gera um registro exato das versões usadas.
Quais são os 5 erros mais comuns ao escolher um frontend?
- Achar que você precisa do frontend com mais recursos. O Open WebUI tem mais recursos, mas se você só quer conversar, o app desktop do Ollama ou o Enchanted é mais rápido de configurar. Escolha pelas suas necessidades reais, não pela quantidade de recursos.
- Não perceber que dá para trocar de frontend com facilidade. Seus modelos do Ollama são independentes do frontend. Passe do Open WebUI para o Enchanted UI ou para o app desktop do Ollama sem baixar os modelos de novo -- todos compartilham a mesma instância do Ollama (o Jan AI mantém sua própria pasta de modelos).
- Tentar rodar o Open WebUI em uma máquina com 8 GB de RAM e sem GPU. O Open WebUI mais a inferência do modelo exigem 12 GB ou mais no total. Em hardware limitado, use o app desktop do Ollama, o Page Assist ou o Enchanted UI.
- Ignorar a quantização do modelo e os requisitos do frontend. Um modelo de 13B em 8 bits ocupa 13 GB só por si. O Open WebUI soma sobrecarga. Faça a conta: tamanho do modelo + sobrecarga do frontend + sistema operacional = RAM total necessária.
- Não configurar o Ollama como serviço em segundo plano antes. Muitos iniciantes tentam rodar vários frontends ao mesmo tempo sem perceber que o Ollama precisa estar em execução. Configure o Ollama primeiro (como serviço, com `ollama serve` em segundo plano) e só depois adicione o frontend escolhido.
•⚠️ Aviso: Rodar o Open WebUI mais a inferência do modelo com 8 GB de RAM costuma causar travamentos por falta de memória. O mínimo para uma experiência fluida é 16 GB de RAM no sistema -- 12 GB para o modelo e 4 GB para o sistema operacional e o Docker.
Perguntas frequentes sobre frontends para LLMs locais
Posso rodar vários frontends ao mesmo tempo?
Sim. Todos os frontends se conectam à mesma API do Ollama (localhost:11434). Você pode ter o Open WebUI, o Enchanted UI e o app desktop do Ollama rodando ao mesmo tempo e usando o mesmo modelo. Isso não dobra o uso de VRAM -- todos compartilham a mesma instância do modelo.
Qual frontend é o melhor para RAG?
O Open WebUI tem a implementação de RAG de uso geral mais madura entre os frontends deste guia -- você envia documentos e o modelo responde perguntas sobre eles. Se perguntar sobre documentos é o seu caso de uso principal, e não um recurso secundário, o AnythingLLM (mais de 67.000 estrelas no GitHub) foi construído em torno de workspaces de RAG e vale uma avaliação à parte. Para fluxos de RAG avançados, veja Melhores ferramentas de RAG local.
Eu preciso mesmo de um frontend?
Não. O Ollama oferece uma API REST em localhost:11434 e, no macOS e no Windows, o app desktop já inclui uma janela de chat básica. Você também pode escrever scripts em Python, JavaScript ou bash para falar com o modelo direto pela API. Um frontend separado serve por conveniência, RAG, acesso multiusuário ou uso no celular.
O Ollama tem interface gráfica?
Sim, no macOS e no Windows. Desde julho de 2025, o Ollama inclui um app desktop que baixa modelos, conversa com eles, aceita arquivos de texto e PDFs arrastados para a janela e envia imagens para modelos multimodais. O anúncio cobre macOS e Windows; no Linux, use a linha de comando e a API, ou combine o Ollama com um frontend como o Open WebUI ou o Page Assist.
O Open WebUI é de código aberto?
Em parte. O código até a v0.6.5 é BSD-3-Clause. A partir da v0.6.6 (abril de 2025), ele usa uma licença modificada com uma cláusula de marca, que a própria página de licença do Open WebUI diz não ser uma licença de código aberto aprovada pela OSI. Ele continua gratuito para rodar; mantenha a marca visível se você atender mais de 50 usuários em um período de 30 dias, a menos que tenha uma licença empresarial ou permissão por escrito.
O Open WebUI exige Docker?
Não. O Docker é a instalação recomendada, mas você pode rodar o Open WebUI com `pip install open-webui` (Python 3.11 ou 3.12; o Python 3.13 ainda não é suportado) ou usar o app desktop do Open WebUI em github.com/open-webui/desktop.
Quais são as melhores alternativas ao Open WebUI?
Para uma configuração mais leve: o app desktop do Ollama (macOS/Windows), o Page Assist (extensão de navegador) ou o Jan AI (desktop). Para perguntas sobre documentos: AnythingLLM. Para um cliente desktop multiprovedor: Cherry Studio. Para uma interface web auto-hospedada: LobeHub. Veja a seção de alternativas acima para versões e licenças.
Qual frontend funciona no Linux?
Open WebUI, Jan AI, LobeHub, Page Assist (em um navegador no Linux) e Gradio/Streamlit funcionam no Linux. O Jan AI adicionou aceleração de GPU AMD ROCm/HIP no Linux na v0.8.2 (junho de 2026), então o Linux deixou de ser uma plataforma beta para ele. O Enchanted UI é apenas para iOS/macOS/visionOS, e o app desktop do Ollama foi anunciado para macOS e Windows. O Continue.dev funciona pelo VS Code em todas as plataformas, embora o projeto tenha parado o desenvolvimento ativo em junho de 2026, depois de ser adquirido pela Cursor.
Posso hospedar um frontend em um servidor remoto?
Sim. Frontends web como o Open WebUI e o LobeHub funcionam bem em um servidor: rode o Ollama lá, implante o frontend no Docker e abra-o do seu notebook via HTTP. Apps nativos como o Enchanted UI se conectam a um servidor Ollama remoto quando você informa o endereço dele em Ajustes. Proteja a configuração com autenticação ou um firewall.
Qual frontend usa menos RAM?
Clientes nativos e baseados em extensão acrescentam menos sobrecarga: o app desktop do Ollama, o Enchanted UI, o Page Assist e o Continue.dev não têm camada de Docker nem de banco de dados. A imagem Docker slim do Open WebUI fica em cerca de 300 MB em repouso, segundo a documentação, e usa mais quando o RAG e os modelos de embedding estão ativos. Se a RAM for limitada, use o app desktop do Ollama ou o Page Assist, o Enchanted UI em dispositivos Apple ou o Continue.dev para código.
Posso usar esses frontends com o LM Studio em vez do Ollama?
Sim. O Open WebUI funciona com qualquer API compatível com OpenAI, incluindo a API do LM Studio em localhost:1234. A API REST do LM Studio chegou a uma versão v1 estável (não é mais beta) e também ganhou um endpoint compatível com Anthropic, então tanto o Ollama quanto o LM Studio servem como backend confiável. Altere a URL base nas configurações.
Qual frontend é o melhor para uma equipe de 5 ou mais desenvolvedores?
Open WebUI. Foi projetado para implantação multiusuário: autenticação, históricos de conversa separados por usuário, bases de conhecimento compartilhadas e controles de administração. Implante em um servidor compartilhado com Docker e todos os membros da equipe acessam pelo navegador. Exige 12 GB ou mais de RAM no servidor host. Confira a cláusula de marca se mais de 50 usuários forem usá-lo.
Fontes
- Open WebUI Contributors. (2026). "Open WebUI GitHub." -- Código-fonte, versões e documentação de instalação com Docker do Open WebUI.
- Open WebUI. (2026). "Open WebUI License." -- BSD-3-Clause até a v0.6.5; cláusula de marca a partir da v0.6.6.
- Open WebUI. (2026). "Quick Start." -- Métodos de instalação via Docker, pip e app desktop.
- Ollama. (2025). "Ollama's new app." -- Anúncio do app desktop para macOS e Windows (30 de julho de 2025).
- Jan AI. (2026). "Jan AI Official Site." -- Documentação do app desktop e guia de gerenciamento de modelos; versões no GitHub.
- Enchanted Contributors. (2026). "Enchanted GitHub." -- Código-fonte do cliente Ollama nativo para iOS/macOS/visionOS; última atualização em 7 de julho de 2026.
- The New Stack. (2026). "Cursor acquires Continue." -- Reportagem sobre a aquisição de junho de 2026.
- Continue.dev. (2026). "Continue GitHub Repository." -- Código-fonte da extensão para VS Code e JetBrains; última versão em 19 de junho de 2026.
- LobeHub. (2026). "LobeHub GitHub." -- Código-fonte, versões e licença do sucessor do Lobe Chat.
- Page Assist e AnythingLLM. (2026). "Page Assist GitHub." -- Código-fonte do cliente em barra lateral do navegador; o AnythingLLM está em github.com/Mintplex-Labs/anything-llm.
- A escolha do frontend afeta a experiência de uso, não a saída do modelo. A qualidade da resposta depende dos prompts, não das interfaces: o guia de prompt engineering vale para todos os frontends.