Datos rápidos
- Artículo base: Arditi et al., "Refusal in Language Models Is Mediated by a Single Direction" (arXiv 2406.11717, 2024), 13 modelos de chat de 1.8B a 72B parámetros.
- Heretic: creado por Philipp Emanuel Weidmann (p-e-w); 2.0.0 publicado el 2026-11-01, 2.1.0 el 2026-11-08; usa Optuna para buscar parámetros y puntúa los rechazos y la divergencia KL.
- Recuentos de etiquetas en Hugging Face (2026-11-13): abliterated 13.279; uncensored 16.629; heretic 7.058 repositorios, incluyendo cuantizaciones y duplicados.
- Tamaños típicos (GGUF Q4_K_M): 8B unos 5 GB; 12B unos 7.6 GB; 24B unos 14 GB; 27B unos 16.6 GB; 31B unos 18.7 GB.
- Estimación de memoria: un modelo Q4 de 31B necesita aproximadamente 22-24 GB de VRAM o 32 GB de RAM; son estimaciones, no mediciones.
- Formatos de archivo de menor riesgo: prefiere safetensors y GGUF frente a archivos .bin, .pt o .ckpt basados en pickle.
¿Qué son los modelos de IA sin censura?
Dos personas descargan el mismo modelo de pesos abiertos. La primera le hace una pregunta límite y recibe un rechazo educado. La segunda descargó una copia modificada del mismo modelo base, hace la misma pregunta y obtiene una respuesta. Misma arquitectura, mismo conocimiento, distinto comportamiento. Esa diferencia es toda la historia de la IA sin censura.
Es posible porque los modelos de pesos abiertos son archivos. Un chatbot alojado mantiene sus pesos, su prompt de sistema y sus filtros en servidores ajenos, así que solo puedes conversar con él. Un modelo de pesos abiertos te da los pesos. Cualquiera puede hacerles fine-tuning, fusionarlos, cuantizarlos o editarlos y publicar el resultado. El comportamiento de rechazo es algo que el modelo aprendió, así que se puede desaprender o suprimir.
La IA local lo hace práctico. Un modelo de 12B o 24B ya funciona en un portátil o en una sola GPU, sin conexión, dentro de apps en las que ya confías. Las páginas de etiquetas de Hugging Face del 2026-11-13 listaban 13.279 repositorios con la etiqueta abliterated, 16.629 con uncensored y 7.058 con heretic, aunque estos recuentos incluyen cuantizaciones y duplicados. También existen dos índices especializados: abliter.cn mostraba 921 modelos de 25.796 repositorios analizados, y abliteration.org describe un catálogo de más de 19.000 modelos. Usan reglas de inclusión distintas, así que las cifras no describen lo mismo.
El tema también está en las noticias. Heretic 2.0 se publicó el 2026-11-01 y sustituyó a la técnica clásica de una sola dirección como método por defecto de la herramienta. WIRED publicó un perfil de la comunidad el 2026-11-10 (solo pudimos leer reposts, así que lo citamos como reportado). Un modelo modificado de Gemma 4 31B publicado el 2026-11-05 afirma una gran reducción de rechazos; examinamos sus cifras más abajo.
Esta guía empieza por el fenómeno y luego explica los términos, la ciencia y las herramientas. Una idea la recorre: piensa en estos modelos como un componente intercambiable de las apps locales. La app aporta documentos, voz, agentes y una interfaz usable; el modelo decide qué responderá. Combinarlos da una flexibilidad que ningún servicio alojado ofrece, y también elimina la red de seguridad que ofrece un servicio alojado.
📍 En una frase
Los modelos de IA sin censura son modelos de lenguaje de pesos abiertos modificados, mediante fine-tuning o edición de pesos, para que rechacen menos peticiones que el original.
💬 En términos simples
Piensa en un modelo como un archivo tuyo. Alguien puede editar ese archivo para que diga que sí más a menudo, y tú puedes ejecutar el archivo editado en tus propias apps.
¿Qué significa realmente «sin censura»?
Las palabras se usan con poco rigor, y así es como la gente acaba descargando algo que no se comporta como se anuncia. Esto es lo que significa técnicamente cada término.
📍 En una frase
«Sin censura» describe un resultado (menos rechazos), mientras que «abliterado» describe un método (edición de pesos), así que un modelo puede ser lo uno sin lo otro.
💬 En términos simples
Sin censura es lo que esperas, abliterado es cómo se hizo y jailbroken es un truco que haces con un modelo sin cambios.
Término | Qué significa | ¿Garantía técnica? |
|---|---|---|
| Uncensored | Menos rechazos de contenido o ninguno | No |
| Unfiltered | Filtrado de salida menos restrictivo | No |
| Unaligned | Entrenamiento de alineación reducido o distinto | No |
| Abliterated | Pesos editados con una técnica de ablación | Solo el método |
| Jailbroken | Comportamiento eludido mediante prompts | No, pesos intactos |
| Unrestricted | Término de marketing | No |
El jailbreak es el caso aparte: cambia el prompt, no el modelo, así que la siguiente conversación empieza limpia. Los demás términos describen algo hecho a los pesos.
⚠️Advertencia: Un modelo con «uncensored» en el nombre no ha perdido necesariamente sus rechazos. Comprueba si la ficha del modelo muestra una tasa de rechazo medida y cómo se midió.
💡Consejo: Con frecuencia se confunden dos cosas distintas: un modelo orientable (Hermes, Dolphin) deja que el prompt de sistema defina el comportamiento, mientras que a un modelo abliterado se le ha eliminado el comportamiento de rechazo de los pesos.
Cómo aprenden los modelos de IA a rechazar peticiones
El preentrenamiento enseña al modelo a predecir texto a partir de un corpus enorme. Produce un sistema capaz pero sin rumbo que continuará casi cualquier cosa. El instruction tuning y el supervised fine-tuning (SFT) lo entrenan después con conversaciones de ejemplo para que responda preguntas en un formato útil.
El entrenamiento por preferencias añade la capa de seguridad. En RLHF (aprendizaje por refuerzo con retroalimentación humana), evaluadores humanos comparan respuestas, un modelo de recompensa aprende sus preferencias y el modelo se optimiza hacia ellas. DPO (optimización directa de preferencias) llega a un resultado similar sin un modelo de recompensa aparte. Los conjuntos de datos de seguridad emparejan peticiones dañinas con rechazos, de modo que el modelo aprende que ciertos tipos de petición deben declinarse: eso es el entrenamiento de rechazo.
¿Dónde vive ese comportamiento? En dos lugares. Un prompt de sistema es texto que se antepone en tiempo de ejecución, y puedes cambiarlo. El comportamiento en los pesos se graba durante el entrenamiento, y no puedes cambiarlo sin tocar los pesos. Por eso un prompt de sistema por sí solo a veces no consigue que el modelo responda, y por eso las ediciones de pesos sí pueden.
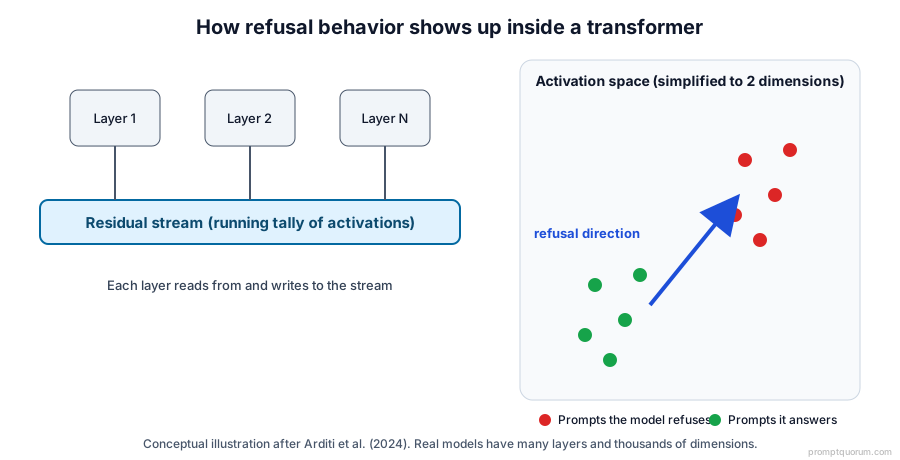
El diagrama muestra la idea que hace posible la abliteración. Dentro de un transformer, cada capa lee de un recuento compartido y continuo, el flujo residual, y escribe en él. La investigación sugiere que, para los rechazos, gran parte de la señal se sitúa a lo largo de una dirección de ese flujo.
¿Qué es la abliteración?
El fundamento científico es Arditi et al. (2024), "Refusal in Language Models Is Mediated by a Single Direction" (arXiv 2406.11717). Los autores probaron 13 modelos de chat abiertos de entre 1.8B y 72B parámetros. Su hallazgo: en estos modelos, el rechazo está mediado por una única dirección del flujo residual.
Cómo se encuentra la dirección. Se ejecuta el modelo con un conjunto de prompts dañinos y otro de prompts inofensivos, se registran las activaciones internas en una capa y una posición de token elegidas, y se calcula la diferencia entre los dos promedios. Ese vector de diferencia de medias es la dirección de rechazo candidata.
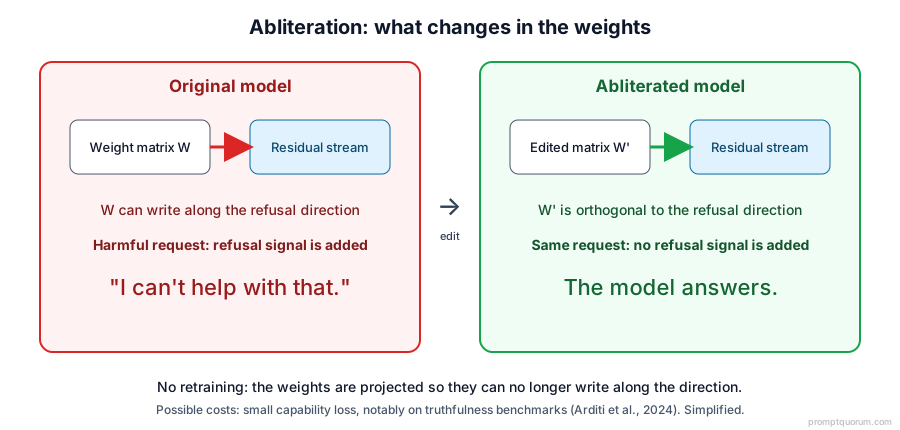
Cómo se elimina. La ablación direccional proyecta esa dirección fuera de las activaciones en tiempo de ejecución. La ortogonalización de pesos logra el mismo efecto de forma permanente: se modifican las matrices de pesos que escriben en el flujo residual para que ya no puedan escribir a lo largo de la dirección. El modelo editado no necesita reentrenamiento y su archivo es igual que el de cualquier otro modelo.
Qué se pierde. Los autores informan de pequeñas caídas de capacidad en la mayoría de los benchmarks, con la excepción de TruthfulQA, que bajó de forma consistente, aproximadamente de 1 a 3.5 puntos. También describen su método de selección de dirección como heurístico. La guía práctica de Maxime Labonne encontró que la abliteración redujo todos los benchmarks que midió, que un paso de «curación» con DPO recuperó la mayor parte pero no todo, y que elegir la capa requiere criterio.
Una advertencia sobre las cifras. La empresa de seguridad Alice publicó un informe que probó cinco modelos y reportó un 98.0 % de cumplimiento tras la abliteración (539 de 550 prompts) frente a un 5.8 % antes, y una entrada de blog que reporta un 96-100 % en seis familias de modelos. Estas cifras las informa la propia empresa, las puntuó un LLM como juez, no han sido revisadas por pares y miden la disposición a responder, no un aumento real de capacidad en el mundo real. Tómalas como un dato, no como una prueba.
📍 En una frase
La abliteración estima una dirección de rechazo a partir de diferencias de activaciones y edita los pesos para que el modelo ya no pueda escribir a lo largo de ella.
💬 En términos simples
Si rechazar es un dial dentro del modelo, la abliteración encuentra el dial y lo quita, sin enseñarle nada nuevo al modelo.
Heretic 2.0: la nueva generación de abliteración
Quién y qué. Heretic es una herramienta de línea de comandos de código abierto creada por Philipp Emanuel Weidmann (usuario de GitHub p-e-w). En lugar de pedir a una persona que elija capas e intensidades, automatiza la búsqueda.
El enfoque original. Heretic usa Optuna, una biblioteca de optimización de hiperparámetros con un sampler TPE, para probar muchos ajustes de abliteración. Unos scorers enchufables puntúan cada prueba. Por defecto cuenta los rechazos con un scorer basado en palabras clave y mide la divergencia KL respecto al modelo original con prompts inofensivos, de modo que la búsqueda persigue ajustes que eliminen rechazos cambiando todo lo demás lo mínimo posible. Los modifiers son los componentes que realmente editan los pesos.
Qué cambió en la 2.0. La versión 2.0.0 se publicó el 2026-11-01 (la 2.1.0 siguió el 2026-11-08). El modificador por defecto es ahora la Arbitrary-Rank Ablation (ARA); la ablación direccional clásica, con opciones de abliteración proyectada y preservación de la norma, sigue disponible. La versión añade además un sistema de plugins, funcionamiento sin interfaz y un scorer de rechazo basado en BERT como plugin (el scorer por defecto sigue basándose en palabras clave). Los archivos de configuración de Heretic 1.x no funcionan con la 2.x.
Qué es ARA. Según el propio pull request del autor, ARA no usa direcciones de rechazo. Aprende ediciones matriciales por módulo con un optimizador L-BFGS frente a tres objetivos: dejar intactas las salidas para prompts inofensivos, hacer que las salidas para prompts dañinos coincidan con las inofensivas y alejarlas de las antiguas salidas dañinas. Una sola dirección es una edición de rango uno; ARA permite ediciones de rango superior, así que puede capturar un comportamiento de rechazo que no es unidimensional. La descripción completa se sigue anunciando como un preprint «pronto», así que las afirmaciones de calidad son del propio autor y no están verificadas de forma independiente.
Hardware y compromisos. La herramienta carga el modelo completo y ejecuta muchas pruebas, así que necesitas memoria suficiente para ejecutar el modelo que modificas, además de tiempo. Los compromisos de calidad siguen el patrón de otros métodos: un estudio comparativo de cuatro herramientas en 16 modelos (Young, arXiv 2512.13655, resumen leído) reporta cambios en GSM8K de +1.5 a -18.8 puntos y valores KL de Heretic de 0.04 a 1.65, de modo que los resultados dependen mucho del modelo.
⚠️Advertencia: Varios detalles de la 2.0 aparecen en entradas de blog de terceros que no pudimos contrastar con el repositorio. Solo afirmamos lo que dicen el repositorio, las notas de versión o el pull request del autor, y etiquetamos el resto como reportado.
Otras formas de crear modelos sin censura
La abliteración no es la única vía. La tabla compara los enfoques principales. La fila de fusión de modelos es deliberadamente cautelosa: no encontramos ninguna fuente primaria que documente las fusiones como método para eliminar rechazos.
Método | Qué cambia | ¿Requiere entrenar? | Principal contrapartida |
|---|---|---|---|
| Fine-tuning sin censura | Pesos, con datos nuevos | Sí | Cómputo y calidad de datos |
| Abliteración | Pesos, una dirección | No | Cierta pérdida de capacidad |
| Abliteración automatizada | Pesos, ajustes buscados | No | Tiempo de pruebas y memoria |
| Fusión de modelos | Mezcla varios modelos | No | Sin verificar para rechazos |
| Optimización de preferencias | Pesos, con preferencias | Sí | Requiere datos emparejados |
El enfoque de fine-tuning más conocido es la línea Dolphin de Eric Hartford, que filtra del conjunto de entrenamiento las respuestas de estilo rechazo y confía en el prompt de sistema para el comportamiento. El fine-tuning también puede hacerse con adaptadores LoRA, y la investigación publicada indica que el entrenamiento de seguridad puede deshacerse con pequeñas cantidades de fine-tuning dañino (Qi et al., Lermen et al.). Variantes más nuevas de edición de pesos, como la abliteración biproyectada con preservación de la norma, intentan reducir el daño colateral, y la «curación» con DPO se usa para recuperar calidad tras una edición.
Las familias más importantes de modelos de IA sin censura
Dolphin (cognitivecomputations y la organización más reciente dphn) es la línea de fine-tuning más conocida. La entrada verificada actual es Dolphin-Mistral-24B-Venice-Edition. Su ficha dice que el prompt de sistema fija el comportamiento, así que es orientable y no tiene garantizado que carezca de rechazos.
Hermes (NousResearch) no es una familia sin censura. Los modelos Hermes 4 tienen una alineación neutra y son orientables. El propio RefusalBench de Nous, según la ficha de Hermes 4.3 36B, muestra que el modelo respondió aproximadamente al 72-75 % de sus prompts de prueba, de modo que casi una cuarta parte sigue rechazándose. No clasifiques todos los Hermes como sin censura.
Las variantes abliteradas de Qwen dominan las descargas. La entrada verificada más descargada es Huihui-Qwen3.8-27B-abliterated, con unos 4 millones de descargas. Búsqueda: Qwen abliterated en Hugging Face.
Las variantes abliteradas de Gemma son el área más nueva. Los modelos modificados de Gemma 4 aparecen con abliteración simple y con Heretic y ARA. Búsqueda: Gemma abliterated. Uno de ellos, un modelo Gemma 4 31B con ARA, afirma una gran reducción de rechazos, que examinamos más abajo.
Las variantes abliteradas de Llama son en su mayoría antiguas. En nuestra comprobación del 2026-11-13, nada más reciente que Llama 3.1 y 3.3 tiene muchas descargas, y la entrada de 8B más descargada es de 2024. Búsqueda: Llama abliterated.
Mistral, DeepSeek y GLM. Existe una abliteración de Mistral Small 3.2 24B. Para DeepSeek y GLM existen versiones abliteradas de los modelos más recientes, pero pesan unos 284 GB y 321 GB, fuera del alcance del hardware de consumo; solo es práctico un DeepSeek R1 distill más antiguo de 32B.
Una lectura crítica de la afirmación sobre Gemma 4 31B. La ficha del modelo reporta que los rechazos bajan de 99 de 100 prompts a 28 de 100 (Heretic v2.0.0 ARA, divergencia KL 0.0845). Es una reducción relativa del 72 %, y también significa que 28 de 100 prompts de prueba siguieron activando el detector. El detector es una lista de unas 34 palabras clave como «sorry» e «illegal», aplicada a respuestas truncadas a 100 tokens, de modo que una respuesta útil con un aviso cuenta como rechazo y una no respuesta sin esas palabras cuenta como cumplimiento. El conjunto de prueba son 100 prompts de un único dataset, el original puntuó 99/100 y la cifra KL se mide solo con prompts inofensivos, así que no dice nada sobre la capacidad. La ficha promete reproducibilidad, pero su propio archivo de reproducción advierte de que se usó una compilación local de Heretic sin confirmar en el repositorio. No encontramos ninguna evaluación independiente. Otro repack de 31B sobre la misma base reporta 10/100 con KL 0.054, pero los resultados de autores, ejecuciones y ajustes distintos no son comparables.
💡Consejo: Lee las cifras de rechazo como lees las de benchmarks: pregunta qué contó como rechazo, cuántos prompts, cuánto podía durar la respuesta y quién hizo la prueba.
¿Dónde se pueden descargar modelos de IA sin censura?
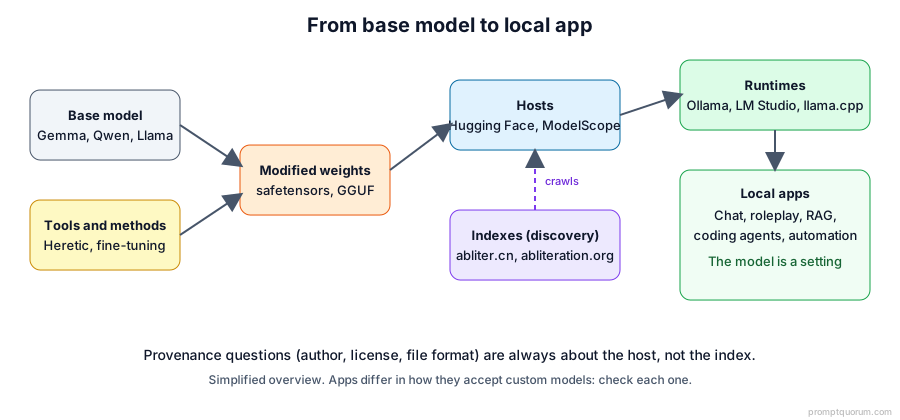
Una plataforma de alojamiento almacena y sirve los propios archivos. Un índice especializado solo rastrea plataformas de alojamiento y añade una capa de descubrimiento. Un índice puede ayudarte a encontrar candidatos, pero el archivo que descargas sigue viniendo del alojamiento, así que las dudas de procedencia siempre se refieren al alojamiento y al autor.
Plataforma | Función | Sitio web |
|---|---|---|
| Hugging Face | Pesos y fichas de modelo | huggingface.co |
| Ollama | Ejecutar y distribuir en local | ollama.com |
| ModelScope | Repositorio alternativo | modelscope.cn |
| GitHub | Herramientas y código fuente | github.com |
| Abliter.cn | Índice de descubrimiento | abliter.cn |
| Abliteration.org | Catálogo y analítica | abliteration.org |
Verifica antes de ejecutar. Prefiere archivos safetensors y GGUF. Los formatos basados en pickle (.bin, .pt, .pkl, .ckpt) pueden ejecutar código al cargarse, y la documentación de Hugging Face recomienda autores de confianza y safetensors. No actives nunca trust_remote_code en un repositorio desconocido. Comprueba que la ficha del modelo nombre el modelo base y el método y que la cadena de modelos base lleve al repositorio oficial, compara los hashes de archivo cuando el autor los publique y lee la licencia. Hugging Face ejecuta un análisis de malware sobre los archivos de repositorio de menos de 2 GB, así que los archivos de pesos grandes pueden quedar fuera (nuestra lectura de la documentación). Las copias cuantizadas de cuantizadores reputados avalan el formato del archivo, no las afirmaciones del autor original. Los espacios de nombres de Ollama como huihui_ai y richardyoung son subidas de usuarios, no modelos verificados por la biblioteca.
¿Qué modelos sin censura merece la pena descargar?
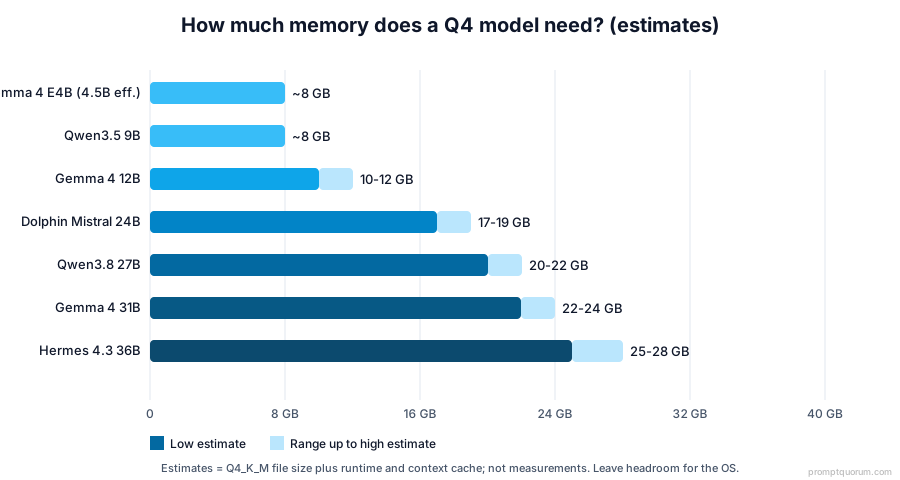
Comprobamos diez repositorios actuales el 2026-11-13 contra la API de Hugging Face y las fichas de modelo, no contra artículos antiguos. Los tamaños son los de archivos GGUF Q4_K_M cuando el repositorio los publica; las cifras de memoria son estimaciones nuestras (tamaño del archivo más runtime y caché), no mediciones. Los recuentos de descargas y las fechas cambian constantemente, así que esta tabla es una instantánea y debe actualizarse con independencia del artículo.
Gemma 4 31B ARA Heretic
- Base:
- Gemma 4 31B-it
- Método:
- Heretic 2.0 ARA
- Parámetros:
- 30.7B
- Tamaño Q4:
- 18.7 GB
- Memoria (est.):
- 22-24 GB VRAM
- Contexto:
- 262K
- Licencia:
- Apache-2.0
- Límites conocidos:
- Sin prueba independiente
Gemma 4 E4B Heretic
- Base:
- Gemma 4 E4B-it
- Método:
- Heretic ARA
- Parámetros:
- 4.5B efect.
- Tamaño Q4:
- 5.3 GB
- Memoria (est.):
- ~8 GB
- Contexto:
- 131K
- Licencia:
- Apache-2.0
- Límites conocidos:
- Pruebas del propio repackager
Huihui Gemma 4 12B
- Base:
- Gemma 4 12B-it
- Método:
- Abliteración
- Parámetros:
- 12.0B
- Tamaño Q4:
- 7.6 GB
- Memoria (est.):
- 10-12 GB
- Contexto:
- 128-256K
- Licencia:
- Apache-2.0
- Límites conocidos:
- Ficha: «proof-of-concept»
Huihui Qwen3.8 27B
- Base:
- Qwen3.8 27B
- Método:
- Abliteración
- Parámetros:
- 27.3B
- Tamaño Q4:
- 16.6 GB
- Memoria (est.):
- 20-22 GB
- Contexto:
- 262K
- Licencia:
- Apache-2.0
- Límites conocidos:
- Puede añadir avisos
Huihui Qwen3.5 9B
- Base:
- Qwen3.5 9B
- Método:
- Abliteración
- Parámetros:
- 9.7B
- Tamaño Q4:
- 5.6 GB
- Memoria (est.):
- ~8 GB
- Contexto:
- 262K
- Licencia:
- Apache-2.0
- Límites conocidos:
- Sin datos de rechazo en la ficha
Dolphin Mistral 24B Venice
- Base:
- Mistral Small 24B
- Método:
- Fine-tune
- Parámetros:
- 24.0B
- Tamaño Q4:
- 14.3 GB
- Memoria (est.):
- 17-19 GB
- Contexto:
- 131K
- Licencia:
- Apache-2.0
- Límites conocidos:
- El prompt fija el comportamiento
Hermes 4.3 36B
- Base:
- Seed-OSS 36B
- Método:
- Post-entrenamiento
- Parámetros:
- 36.2B
- Tamaño Q4:
- 21.8 GB
- Memoria (est.):
- 25-28 GB
- Contexto:
- 524K
- Licencia:
- Apache-2.0
- Límites conocidos:
- No es sin censura
Hermes 4 14B
- Base:
- Qwen3 14B
- Método:
- Post-entrenamiento
- Parámetros:
- 14.8B
- Tamaño Q4:
- 9.0 GB
- Memoria (est.):
- 11-12 GB
- Contexto:
- 41K
- Licencia:
- Apache-2.0
- Límites conocidos:
- No es sin censura
Llama 3.1 8B abliterated
- Base:
- Llama 3.1 8B
- Método:
- Abliteración
- Parámetros:
- 8.0B
- Tamaño Q4:
- 4.9 GB
- Memoria (est.):
- 7-8 GB
- Contexto:
- 131K
- Licencia:
- Términos de Llama 3.1
- Límites conocidos:
- De 2024
R1 Distill Qwen 32B
- Base:
- R1-Distill-Qwen-32B
- Método:
- Abliteración
- Parámetros:
- 32.8B
- Tamaño Q4:
- 19.9 GB
- Memoria (est.):
- 23-26 GB
- Contexto:
- 131K
- Licencia:
- Sin etiquetar
- Límites conocidos:
- De 2025, sin etiqueta de licencia
Cómo leer la tabla. La abliteración de Qwen3.8 27B es, con diferencia, la más descargada (unos 4 millones), pero su ficha dice que la salida aún puede incluir un pequeño aviso de advertencia, un recordatorio de que «abliterado» no significa «responderá a cualquier cosa». Para equipos modestos, las entradas Gemma 4 E4B y Qwen3.5 9B caben en unos 8 GB. Existen etiquetas de Ollama verificadas para algunos: ollama run huihui_ai/gemma-4-abliterated:12b, ollama run huihui_ai/qwen3.5-abliterated:9b y huihui_ai/Qwen3.8-abliterated (unos 18 GB); el modelo Gemma 4 31B tiene una página de Ollama bajo el espacio de nombres del autor. Hermes 4.3 36B aparece para que puedas ver un modelo orientable y de alineación neutra junto a los modificados: el propio benchmark de Nous deja alrededor de una cuarta parte de los prompts rechazados. Los términos de Llama 3.1 exigen un aviso «Built with Llama» y el prefijo «Llama» en los nombres de modelos derivados, y el R1 distill no tiene etiqueta de licencia, así que no des ninguna por supuesta. También existen una abliteración de Mistral Small 3.2 (24B) y una de Llama 3.3 70B (unos 42.5 GB en Q4, para equipos de 64 GB), pero están desfasadas.
Usa modelos sin censura dentro de apps locales
La razón por la que esto importa es la arquitectura de la IA local. La mayoría de las apps locales no incluyen un modelo fijo. Se conectan a un backend, normalmente Ollama, llama.cpp o un servidor compatible con OpenAI, o cargan los archivos GGUF que tú eliges.
Nuestras propias reseñas confirman el patrón en todas las categorías. SillyTavern se conecta a KoboldCpp, text-generation-webui, Ollama o LM Studio. Open WebUI hace de interfaz de Ollama o de cualquier API compatible con OpenAI. LM Studio ejecuta modelos GGUF con un explorador de Hugging Face integrado. AnythingLLM, Msty y Cline se conectan a Ollama o LM Studio. n8n tiene un nodo de Ollama dedicado, y KoboldCpp ejecuta archivos GGUF directamente. Cuando el modelo es un ajuste, puedes cambiar un modelo neutro por uno sin restricciones según la tarea.
Lo que ganas. Obtienes las funciones de la app y el modelo que elijas, sin conexión y sin que un proveedor alojado lea la conversación. La tabla muestra cómo se traduce esto por categoría. Confirma que la versión de la app que usas acepta modelos personalizados antes de depender de ella; esta lista es un punto de partida, no una garantía.
📍 En una frase
Como la mayoría de las apps locales tratan el modelo como un ajuste intercambiable, combinarlas con un modelo sin restricciones cambia lo que hará toda la app sin cambiar la app.
💬 En términos simples
La app es el coche y el modelo es el conductor: pon un conductor que diga que sí más a menudo y el mismo coche irá a sitios a los que antes no iba.
Categoría de app | Apps de ejemplo | Aporta sin restricciones |
|---|---|---|
| Clientes de chat | LM Studio, Msty, Open WebUI | Menos preguntas rechazadas |
| Roleplay y ficción | SillyTavern, KoboldCpp | Temas oscuros, sin rechazos a mitad de escena |
| RAG sobre documentos | AnythingLLM, Open WebUI | La inferencia se queda en tu dispositivo |
| Agentes de programación | Cline, Aider, Continue | Ayuda con código de pruebas de seguridad |
| Automatización | n8n con nodo de Ollama | Pipelines propios, capa de política propia |
| Agentes personales | Hermes Agent, nanobot | Más autonomía, exige salvaguardas |
Ejemplos concretos de la flexibilidad extra. Un novelista puede ejecutar un modelo abliterado u orientable tras SillyTavern para ficción moralmente compleja sin rechazos a mitad de escena, algo que nuestra guía de escritura creativa cubre en profundidad. Un abogado, periodista o investigador puede apuntar AnythingLLM a una carpeta de documentos sensibles y hacer preguntas sobre contenido que un modelo alojado podría negarse a tratar, con la inferencia ejecutándose en tu equipo. Revisa los ajustes de telemetría y de actualización de cada app, porque las apps y las descargas de modelos aún pueden usar la red. Un profesional de la seguridad puede usar un agente de programación con un modelo que no se arredra ante preguntas cercanas a exploits dentro de un entorno de pruebas autorizado. Un desarrollador puede construir un flujo de n8n cuyo modelo sea un ajuste y cambiarlo sin reescribir nada. Un usuario avanzado puede ejecutar dos modelos en una misma app, uno neutro para el trabajo diario y otro sin restricciones para las tareas que el primero declina.
⚠️Advertencia: La flexibilidad tiene un precio. En una ventana de chat, un modelo sin restricciones solo produce texto. Conectado a un agente con acceso a archivos, shell o web, ese mismo modelo puede actuar sobre lo que genera. Combina estas configuraciones con sandboxing, mínimo privilegio y aprobación humana.
💡Consejo: ¿No sabes qué app puede cargar tu modelo o encaja con tu equipo? Filtra el Directorio de software de LLM local por caso de uso, sistema operativo y RAM, o describe tu equipo a Ask Hans.
Cómo ejecutar IA sin censura en local
Ollama (ollama.com) es la vía más sencilla para quien usa la línea de comandos: descargas un modelo por nombre y sirve una API que muchas apps entienden. LM Studio (lmstudio.ai) es la vía gráfica, con un explorador de Hugging Face integrado y un servidor local compatible con OpenAI. llama.cpp (github.com/ggml-org/llama.cpp) es el motor que hay debajo de muchas de estas herramientas y ejecuta archivos GGUF directamente. Transformers (huggingface.co/docs/transformers) carga pesos safetensors de precisión completa en Python, lo que conviene a la investigación y a quien piense evaluar o modificar modelos.
GGUF y cuantización. GGUF es el formato de archivo único que usan las herramientas basadas en llama.cpp. La cuantización almacena los pesos con menos bits: Q4_K_M es el compromiso habitual, con aproximadamente una cuarta parte del tamaño de precisión completa y un coste modesto en calidad. Las cuantizaciones más bajas ahorran memoria pero pueden perjudicar el razonamiento y el seguimiento de instrucciones, así que prueba el archivo concreto que uses.
Hardware. En Apple Silicon, la memoria unificada se comparte entre CPU y GPU, así que un Mac de 32 GB puede alojar un modelo Q4 de unos 24-27B parámetros más el contexto; deja varios gigabytes para el sistema. En GPUs NVIDIA el modelo debe caber en la VRAM: una tarjeta de 24 GB sirve para los modelos de 24-31B anteriores y 8 GB sirve para modelos de 4-9B. Si el modelo no cabe, las capas pasan a la RAM del sistema y la velocidad cae en picado. Para cifras exactas, consulta cuánta VRAM necesita un LLM local.
Funcionamiento sin conexión. Una vez que los pesos están en el disco, ninguna de estas herramientas necesita internet para generar texto. Ese es el principal argumento de privacidad, y también la razón por la que ningún proveedor puede imponer normas de uso sobre una copia local.
¿Puedes crear tu propio modelo abliterado?
Conceptualmente sí, y es más accesible que antes. Describimos el flujo de trabajo solo a alto nivel.
- 1Selecciona un modelo de pesos abiertos
Why it matters: Elige uno cuyo tamaño quepa en tu memoria, porque la herramienta debe cargarlo. - 2Revisa la licencia
Why it matters: Algunas licencias y políticas de uso restringen eludir los filtros de seguridad (los Gemma Terms anteriores lo hacían); lee la licencia exacta del modelo base antes de modificar o redistribuir. - 3Comprueba la compatibilidad de arquitectura
Why it matters: Las herramientas admiten arquitecturas concretas; un modelo nuevo puede no funcionar todavía. - 4Elige un método
Why it matters: Ablación direccional clásica, o una herramienta automatizada como Heretic con ARA. - 5Ejecuta la modificación
Why it matters: Las herramientas automatizadas buscan entre muchos ajustes; los métodos clásicos dependen de tu elección de capa. - 6Evalúa el resultado
Why it matters: Mide los rechazos y la pérdida de calidad con prompts con los que la herramienta no ajustó. - 7Compáralo con el original
Why it matters: La capacidad puede bajar aunque los rechazos disminuyan. - 8Documenta y publica con responsabilidad
Why it matters: Indica el método, las cifras, el modelo base y la cadena de licencias.
¿Cuáles son los riesgos de la IA sin censura?
Describimos los riesgos al nivel necesario para entenderlos y no damos ningún detalle operativo.
- Ayuda para ciberdelincuencia y malware. Un modelo con menos rechazos reduce el esfuerzo necesario para obtener ayuda al escribir código malicioso. Se debate si añade capacidad más allá de la que ya está disponible.
- Phishing y fraude. Cualquier modelo capaz produce con facilidad textos de estafa fluidos y personalizados; los rechazos eran un punto de fricción, y aquí es más débil.
- Información biológica y química peligrosa. Es la preocupación de mayor riesgo en el debate político. Las cifras de tasa de rechazo reportadas miden la disposición a responder, no un aumento real de capacidad, así que no son prueba ni de peligro ni de seguridad.
- Uso indebido relacionado con armas. Se aplica la misma cautela: el cumplimiento medido no es capacidad demostrada.
- Acoso y contenido abusivo. Los modelos locales pueden generar material abusivo a gran escala. El material de abuso sexual infantil es un delito en las jurisdicciones que conocemos. En Alemania, el § 184b StGB también abarca las representaciones realistas, así que asume que el material realista generado por IA puede ser punible. No lo generes, no lo pidas ni lo almacenes.
- Desinformación. Menos rechazos también significa menos barreras para producir contenido falso persuasivo.
- Privacidad y seguridad de los datos. La inferencia local mantiene tus prompts en tu equipo, pero las descargas son un riesgo aparte: los repositorios desconocidos pueden contener archivos maliciosos, y las apps aún pueden hacer llamadas de red.
- Archivos de modelo maliciosos. Los formatos basados en pickle pueden ejecutar código al cargarse, y el escaneo no es una garantía (consulta la documentación de Hugging Face sobre el escaneo de pickle). Usa safetensors o GGUF de autores conocidos.
- Agentes autónomos con acceso a herramientas. Es el mayor cambio: un modelo sin restricciones conectado a archivos, un shell o la web puede actuar. OWASP incluye la inyección de prompts (LLM01) y la agencia excesiva (LLM06) entre los principales riesgos de las aplicaciones LLM.
¿Por qué algunas personas están en contra de las salvaguardas de la IA?
Los argumentos más sólidos a favor de modelos menos restrictivos merecen un planteamiento justo.
- Libertad de expresión. Los defensores sostienen que una herramienta no debería decidir qué puede leer o escribir un adulto.
- Investigación científica. Estudiar el comportamiento de los modelos, incluidos los rechazos, requiere modelos que puedan modificarse; la propia investigación sobre abliteración depende de los pesos abiertos.
- Pruebas de seguridad. Los red teams necesitan modelos que hablen de ataques para poner a prueba las defensas.
- Escritura creativa. La ficción necesita villanos, violencia y complejidad moral que los modelos demasiado cautelosos pueden aplanar.
- Autonomía del usuario. Algunos sostienen que el usuario, y no el proveedor, debería fijar los límites de una herramienta local.
- Privacidad y ejecución local. El material sensible se procesa en tu equipo, de modo que ningún proveedor alojado recibe el prompt; revisa los ajustes de telemetría de cada app.
- Evitar restricciones excesivas. Los críticos de los modelos comerciales citan rechazos de preguntas inofensivas. El ensayo de Eric Hartford sobre los modelos sin censura defiende este argumento.
¿Por qué son importantes las salvaguardas de la IA?
Los contraargumentos son igual de reales. Las salvaguardas reducen la probabilidad de que un modelo ayude con daños graves, protegen a los usuarios vulnerables y hacen defendible el despliegue en productos.
La distinción clave es entre un modelo que genera texto y un agente que puede ejecutar comandos, leer archivos, navegar por la web o interactuar con otros sistemas. Si un modelo de chat escribe algo dañino, una persona aún tiene que actuar en consecuencia. Si actúa un agente con el mismo modelo, se cierra la distancia entre la salida y la consecuencia.
Es difícil hacer que las salvaguardas de los modelos abiertos resistan manipulaciones: la investigación sobre abliteración citada arriba muestra que una sola edición de pesos puede suprimir el comportamiento de rechazo. Ese es un argumento central a favor de protecciones más fuertes a nivel de modelo y de controles externos alrededor del modelo.
¿Puedes crear tus propias salvaguardas?
Sí. Como un modelo local no tiene capa del lado del proveedor, añades la tuya a su alrededor.
- Capas de moderación. Ejecuta un clasificador como Llama Guard o ShieldGemma sobre entradas y salidas.
- Filtrado de entrada y salida. Bloquea o revisa las categorías que no quieras en tu flujo de trabajo.
- Sandboxing. Ejecuta los agentes en contenedores o máquinas virtuales sin acceso a nada que no puedas permitirte perder.
- Restricciones de permisos. Da a los agentes el mínimo privilegio que necesiten: carpetas de solo lectura, sin red, sin shell salvo que sea imprescindible.
- Aprobación humana. Exige confirmación antes de que un agente escriba archivos, ejecute comandos o envíe mensajes.
- Registro y monitorización. Conserva un registro de lo que hizo el agente y por qué.
- Seguridad del agente. Trata cada documento, página web o correo que lea el agente como entrada no fiable que puede contener instrucciones (inyección de prompts).
¿Es legal descargar y usar modelos de IA sin censura?
No hay una respuesta única, y esto no es asesoramiento jurídico. Las cuestiones que conviene separar son la posesión, la distribución y el uso, y la respuesta puede variar según el país y según para qué se use el modelo.
Ley de IA de la UE. El Reglamento (UE) 2024/1689 impone obligaciones a los proveedores de modelos de IA de uso general, con una exención parcial para los modelos de código abierto que no se aplica a los modelos con riesgo sistémico. Las obligaciones para los modelos de IA de uso general se aplican desde el 2025-08-02, y las facultades de ejecución de la Comisión desde el 2026-08-02. Las directrices de la Comisión de 2025 dicen que un modificador posterior solo se convierte en proveedor por encima de un umbral orientativo de cómputo; entendemos que la abliteración queda muy por debajo, pero el criterio no es vinculante. No pudimos confirmar a partir del texto si el Digital Omnibus de 2026 cambió las fechas de la IA de uso general, así que consulta el texto vigente.
Posesión frente a uso. Poseer un archivo de modelo es distinto de usarlo para cometer un delito. El derecho penal se vincula a actos concretos: producir contenido prohibido, fraude, acoso o herramientas diseñadas para la delincuencia informática. Revisamos las disposiciones alemanas solo parcialmente, así que no te bases en esta guía para ellas.
Licencias y contratos. Las licencias añaden normas encima de la ley. Las fichas de Gemma 4 indican Apache-2.0 y enlazan una página de licencia de Gemma 4, mientras que las generaciones anteriores de Gemma usaban los Gemma Terms y la Prohibited Use Policy, que prohíben eludir los filtros de seguridad; comprueba la página de licencia del modelo base exacto. La licencia de Llama 3.1 exige un aviso «Built with Llama» y un prefijo en el nombre del modelo en los derivados, con una política de uso aceptable que restringe usos pero, según nuestra lectura, no tiene una cláusula explícita contra la elusión. Las fichas de Qwen3.5 y Qwen3.8 de la tabla indican Apache-2.0. Lee siempre la licencia del modelo base, no solo la del derivado.
Protección de datos y derechos de autor. Tratar datos personales en local sigue estando sujeto a la normativa de protección de datos, y las cuestiones de derechos de autor sobre los datos de entrenamiento de los modelos subyacentes siguen sin resolverse. Ninguna cambia cuando se eliminan los rechazos.
¿Se está convirtiendo la IA sin censura en una parte permanente del ecosistema de IA?
Varias tendencias apuntan a que sí. La modificación por parte de la comunidad es grande y crece: los recuentos de etiquetas de Hugging Face anteriores llegan a miles de repositorios. Las herramientas son cada vez más automáticas: Heretic busca los ajustes por ti, y ARA va más allá de una sola dirección. Seguirán llegando nuevas técnicas para eliminar rechazos, y también técnicas que hagan más difícil eliminar las salvaguardas.
Otros desarrollos tiran en direcciones distintas: arquitecturas de seguridad configurables que permiten a quien despliega elegir una política, servicios comerciales que ofrecen modelos menos restringidos, una IA local que pone cada vez más el control en manos del usuario y una regulación que aún se está formando. Espera que continúe el debate sobre si los pesos abiertos podrán hacerse alguna vez resistentes a manipulaciones.
Conclusión. La IA de pesos abiertos da a los usuarios un mayor control sobre el comportamiento de los modelos, y la capa de las apps hace práctico ese control. Pero quitar las salvaguardas no quita la responsabilidad: la transfiere a quien ejecuta el modelo.
Fuentes
- Arditi et al., Refusal in Language Models Is Mediated by a Single Direction — arXiv 2406.11717
- Repositorio y versiones de Heretic — github.com/p-e-w/heretic
- Maxime Labonne, Uncensor any LLM with abliteration — blog de Hugging Face
- Young, Comparative Analysis of LLM Abliteration Methods — arXiv 2512.13655 (solo el resumen)
- Alice, One Pass to Break Them All (informe de 2026) — informe en PDF, investigación de un proveedor, sin revisión por pares
- WIRED, Tear Down Those Guardrails! (2026-11-10/11) — solo leímos reposts y lo citamos como reportado
- Abliter.cn — abliter.cn; Abliteration.org — abliteration.org (el sitio devolvió un error de acceso; se usó el espejo del README)
- Páginas de etiquetas de Hugging Face — abliterated, uncensored, heretic
- Biblioteca de Ollama — ollama.com/library
- Reglamento (UE) 2024/1689 (Ley de IA), art. 2(12) y 53; directrices de la Comisión para modelos de IA de uso general (2025)
- Gemma Prohibited Use Policy y Terms; licencia y política de uso aceptable de Llama 3.1; ficha del modelo Qwen3
- Documentación de Hugging Face: Pickle Scanning y Malware Scanning; OWASP Top 10 para aplicaciones LLM
Preguntas frecuentes
¿Qué es un modelo de IA sin censura?
Un modelo de IA sin censura es un modelo de lenguaje de pesos abiertos cuyos rechazos se han reducido o eliminado, ya sea mediante fine-tuning o editando sus pesos. El resultado rara vez es total: las pruebas publicadas de modelos modificados conocidos aún muestran rechazos residuales.
¿Cuál es la diferencia entre IA sin censura y abliterada?
Sin censura describe un resultado, menos rechazos. Abliterada describe un método, editar los pesos para suprimir el comportamiento de rechazo. Un modelo abliterado suele ser menos restrictivo, pero «uncensored» en el nombre de un modelo no prueba nada sin un resultado medido.
¿Cuál es el mejor LLM sin censura?
No hay un único mejor. Para equipos pequeños, las abliteraciones de Gemma y Qwen de 4-9B caben en unos 8 GB. Para GPUs de 24 GB, caben modelos de 24-31B como Dolphin Mistral 24B o la abliteración de Qwen3.8 27B. Comprueba en la ficha del modelo la evidencia, la licencia y la actividad reciente, y pruébalo con tus propias tareas.
¿Son gratuitos los modelos de IA sin censura?
Los pesos suelen ser gratuitos de descargar, con licencias como Apache-2.0 o la licencia comunitaria de Llama. Aun así pagas el hardware y la electricidad, y algunas licencias imponen condiciones de uso y redistribución.
¿Dónde puedo descargar modelos sin censura?
Hugging Face es el principal alojamiento de pesos y fichas de modelo, y Ollama distribuye muchos como etiquetas listas para ejecutar. ModelScope es un alojamiento alternativo. Abliter.cn y Abliteration.org son índices que ayudan a descubrir modelos pero no alojan los archivos.
¿Puedo ejecutar IA sin censura en local?
Sí. Descarga un archivo GGUF o una etiqueta de Ollama y ejecútalo en Ollama, LM Studio o llama.cpp. Un modelo de 7-9B necesita unos 8 GB de memoria, y uno de 24-31B necesita aproximadamente 20-28 GB en Q4.
¿Qué es Heretic?
Heretic es una herramienta de código abierto de Philipp Emanuel Weidmann que busca automáticamente ajustes que eliminan rechazos cambiando el modelo lo mínimo posible. La versión 2.0, publicada el 2026-11-01, convirtió la Arbitrary-Rank Ablation en su método por defecto.
¿Elimina la abliteración todas las salvaguardas de la IA?
No. Apunta al comportamiento de rechazo y no garantiza que desaparezcan todos los rechazos. Las pruebas publicadas muestran rechazos residuales, y la calidad puede disminuir, sobre todo en los benchmarks de veracidad de la investigación original.
¿Son peligrosos los modelos sin censura?
Pueden usarse mal, y el riesgo crece cuando un modelo se conecta a herramientas como un shell, archivos o la web. En una ventana de chat sencilla solo genera texto. Usa sandboxing, mínimo privilegio, aprobación humana y registro para los agentes.
¿Es legal usar IA sin censura en Europa?
Depende de la posesión, la distribución y el uso. Poseer un modelo es distinto de usarlo para cometer un delito. La Ley de IA de la UE obliga sobre todo a los proveedores, y licencias como la de Llama añaden límites contractuales. Esto no es asesoramiento jurídico; consulta a un abogado para tu caso.
¿Qué apps locales pueden usar modelos sin censura?
Cualquier app que te deje elegir el modelo, lo que incluye LM Studio, Open WebUI, SillyTavern, AnythingLLM, Msty, KoboldCpp, Cline y n8n mediante conexiones con Ollama o compatibles con OpenAI. Comprueba que la versión que usas acepta modelos personalizados.