速览
- 核心论文:Arditi等人,“Refusal in Language Models Is Mediated by a Single Direction”(arXiv 2406.11717,2024),涵盖13个参数量从1.8B到72B的聊天模型。
- Heretic:由Philipp Emanuel Weidmann(p-e-w)创建;2.0.0于2026-11-01发布,2.1.0于2026-11-08发布;使用Optuna搜索参数,并对拒答和KL散度打分。
- Hugging Face标签数量(2026-11-13):abliterated 13,279个;uncensored 16,629个;heretic 7,058个仓库,含量化版本和重复项。
- 典型体积(Q4_K_M GGUF):8B约5 GB;12B约7.6 GB;24B约14 GB;27B约16.6 GB;31B约18.7 GB。
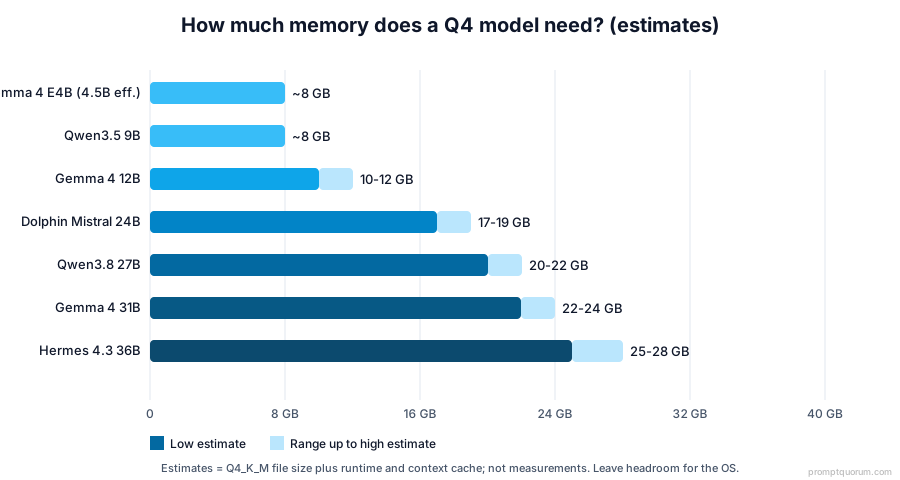
- 内存估算:31B的Q4模型大约需要22-24 GB显存或32 GB内存;这些是估算值,不是实测。
- 风险较低的文件格式:优先选择safetensors和GGUF,避免基于pickle的.bin、.pt或.ckpt文件。
什么是无审查AI模型?
两个人下载了同一个开放权重模型。第一个人问了一个边缘问题,得到礼貌的拒绝。第二个人下载的是同一基础模型的修改版,问了完全相同的问题,却得到了回答。架构相同,知识相同,行为不同。这个差距就是无审查AI的全部故事。
之所以可能,是因为开放权重模型就是文件。托管聊天机器人把权重、系统提示词和过滤器都放在别人的服务器上,你只能与它对话。开放权重模型则把权重交给你。任何人都可以微调、合并、量化或编辑权重,然后发布结果。拒答行为是模型学到的,因此可以被遗忘或抑制。
本地AI让这一切变得切实可行。如今12B或24B模型可以在笔记本电脑或单块GPU上离线运行,放在你已经信任的应用里。2026-11-13,Hugging Face标签页列出标记为abliterated的仓库13,279个、uncensored的16,629个、heretic的7,058个,不过这些数字包含量化版本和重复项。另有两个专门的索引站:abliter.cn显示在扫描的25,796个仓库中有921个模型,abliteration.org则称其目录收录了超过19,000个模型。它们的收录规则不同,因此这些数字描述的并不是同一件事。
这个话题也出现在新闻中。Heretic 2.0于2026-11-01发布,取代经典的单方向技术成为该工具的默认方法。WIRED于2026-11-10发表了一篇关于该社区的报道(我们只能读到转载,因此按转述方式引用)。2026-11-05发布的一个Gemma 4 31B修改模型声称拒答大幅下降;我们在下文检视了它的数据。
本指南先从现象讲起,再解释术语、原理和工具。贯穿全文的一个想法是:把这些模型看作本地应用中可替换的组件。应用提供文档、语音、智能体和好用的界面;模型决定它愿意回答什么。二者结合带来任何托管服务都无法提供的灵活性,同时也拿掉了托管服务所提供的安全网。
📍 简单一句话
无审查AI模型是经过微调或权重编辑而被修改的开放权重语言模型,其拒绝的请求比原模型更少。
💬 简单来说
把模型想成你拥有的一个文件。有人可以编辑这个文件,让它更常说“可以”,而你可以在自己的应用里运行编辑后的文件。
“无审查”究竟指什么?
这些词的用法很随意,这正是人们下载到与宣传不符的东西的原因。以下是每个术语在技术上的含义。
📍 简单一句话
“无审查”描述的是结果(拒答更少),而“abliterated”描述的是方法(编辑权重),因此一个模型可以是前者而不是后者。
💬 简单来说
无审查是你希望得到的效果,abliterated是制作方式,越狱则是对一个没有改动的模型玩的花招。
术语 | 含义 | 有技术保证吗? |
|---|---|---|
| Uncensored(无审查) | 拒绝内容请求更少或没有 | 没有 |
| Unfiltered(未过滤) | 输出过滤限制更少 | 没有 |
| Unaligned(未对齐) | 对齐训练减少或有所不同 | 没有 |
| Abliterated | 用消融技术编辑过权重 | 仅限方法 |
| Jailbroken(越狱) | 通过提示词绕过行为限制 | 没有,权重未变 |
| Unrestricted(无限制) | 营销用语 | 没有 |
越狱是其中的例外:它改变的是提示词,而不是模型,所以下一次对话会从干净状态开始。其他术语描述的都是对权重所做的改动。
⚠️警告: 名称中带有“uncensored”的模型不一定真的失去了拒答能力。请查看模型卡是否给出了实测的拒答率,以及是如何测量的。
💡提示: 两件不同的事经常被混为一谈:可引导模型(Hermes、Dolphin)让系统提示词来定义行为,而abliterated模型则是把拒答行为从权重中移除了。
AI模型如何学会拒绝请求
预训练教模型从庞大语料中预测文本。它产出的系统能力很强但没有方向,几乎什么都会接着写。随后,指令微调和监督微调(SFT)用示例对话训练它,使其以有帮助的格式回答问题。
偏好训练加入了安全层。在RLHF(基于人类反馈的强化学习)中,人类评审比较答案,奖励模型学习他们的偏好,模型再朝着这些偏好优化。DPO(直接偏好优化)无需单独的奖励模型就能达到类似效果。安全数据集把有害请求与拒绝配对,因此模型学会某些类型的请求应当被拒绝:这就是拒答训练。
这种行为存在于哪里?两个地方。系统提示词是运行时附加在前面的文本,你可以修改。模型权重中的行为是在训练期间固化下来的,不碰权重就无法改变。这就是为什么仅靠系统提示词有时无法让模型作答,而编辑权重可以。
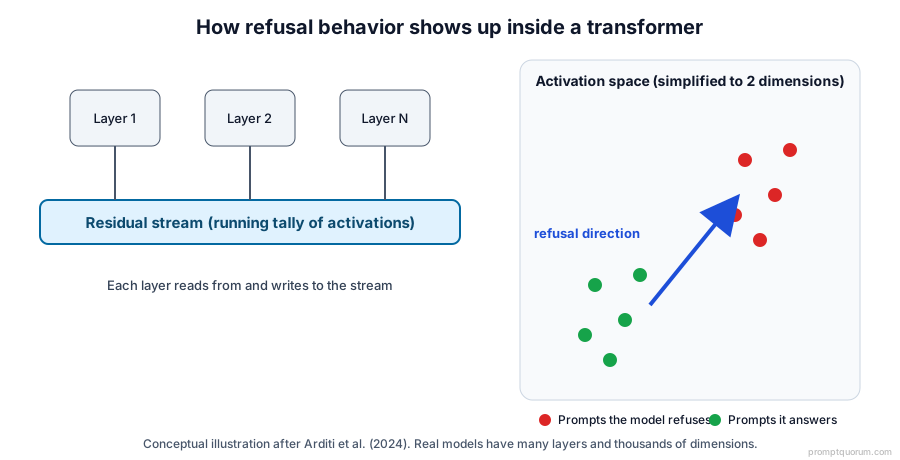
图中展示了让abliteration成为可能的思路。在Transformer内部,每一层都从一个共享的累计量(称为残差流)中读取并写入。研究表明,就拒答而言,大部分信号位于该流中的一个方向上。
什么是Abliteration?
其科学基础是Arditi等人(2024)的论文“Refusal in Language Models Is Mediated by a Single Direction”(arXiv 2406.11717)。作者测试了13个参数量在1.8B到72B之间的开放聊天模型。结论是:对这些模型而言,拒答由残差流中的单一方向介导。
如何找到这个方向。让模型分别处理一组有害提示词和一组无害提示词,记录选定层和词元位置上的内部激活值,并计算两组平均值之差。这个均值差向量就是候选的拒答方向。
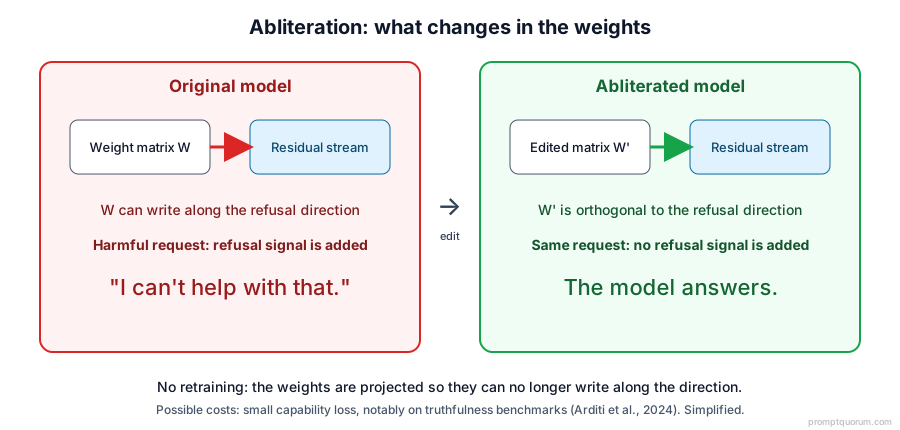
如何移除它。方向消融在运行时把该方向从激活值中投影去除。权重正交化则永久地达到同样效果:修改向残差流写入的权重矩阵,使其无法再沿该方向写入。编辑后的模型无需重新训练,其文件看起来与其他模型没有区别。
损失了什么。作者报告称,大多数基准测试上的能力下降很小,TruthfulQA是例外:它持续下降,幅度大约为1到3.5个点。他们还把自己的方向选择方法描述为启发式。Maxime Labonne的实践指南发现,abliteration使他测量的每一项基准都有所下降,用DPO“修复”步骤能恢复大部分但不是全部,而选择哪一层需要判断力。
关于数据的提醒。安全厂商Alice发布了一份报告,测试了五个模型,报告称abliteration后的服从率为98.0%(550个提示词中的539个),之前为5.8%;另有一篇博客称六个模型家族的服从率在96-100%。这些数字由公司自行报告,由LLM裁判打分,未经同行评审,衡量的是回答意愿,而不是现实中的能力提升。请把它们当作一个数据点,而不是证据。
📍 简单一句话
Abliteration根据激活值差异估计出一个拒答方向,并编辑权重,使模型无法再沿该方向写入。
💬 简单来说
如果拒答是模型内部的一个旋钮,abliteration就是找到这个旋钮并把它拿掉,而不教模型任何新东西。
Heretic 2.0:新一代Abliteration
谁做的、是什么。Heretic是由Philipp Emanuel Weidmann(GitHub用户名p-e-w)创建的开源命令行工具。它不是让人去挑选层和强度,而是自动完成搜索。
最初的方法。Heretic使用Optuna(一个带TPE采样器的超参数优化库)来尝试多种abliteration设置。可插拔的打分器为每次试验评分。默认情况下,它用关键词打分器统计拒答次数,并在无害提示词上测量与原模型的KL散度,因此搜索的目标是找到既能去除拒答、又尽量少改动其他行为的设置。修改器则是真正编辑权重的组件。
2.0有哪些变化。2.0.0版本于2026-11-01发布(2.1.0于2026-11-08跟进)。默认修改器现在是任意秩消融(Arbitrary-Rank Ablation,ARA);经典的方向消融(含投影式abliteration和范数保持选项)仍然可用。该版本还加入了插件系统、无界面运行,以及作为插件提供的基于BERT的拒答打分器(默认打分器仍基于关键词)。Heretic 1.x的配置文件不适用于2.x。
ARA是什么。根据作者自己的拉取请求,ARA不使用拒答方向。它用L-BFGS优化器学习每个模块的矩阵编辑,目标有三个:不改变无害提示词的输出,让有害提示词的输出与无害输出一致,并使其远离原有的有害输出。单一方向是秩一编辑;ARA允许更高秩的编辑,因此可以捕捉非一维的拒答行为。完整说明仍被描述为“很快”发布的预印本,所以质量方面的说法是作者自己的,未经独立验证。
硬件与取舍。该工具会加载完整模型并运行许多次试验,因此你需要足够内存来运行你要修改的模型,还要有时间。质量上的取舍与其他方法类似:一项对16个模型、四种工具的比较研究(Young,arXiv 2512.13655,我们读过摘要)报告GSM8K变化从+1.5到-18.8个点,Heretic的KL值从0.04到1.65,所以结果在很大程度上取决于具体模型。
⚠️警告: 2.0的若干细节出现在第三方博客文章中,我们无法与代码仓库核对。我们只陈述仓库、发布说明或作者拉取请求中所说的内容,其余部分标注为转述。
制作无审查模型的其他方法
Abliteration不是唯一的途径。下表比较了主要方法。模型合并一行刻意保持谨慎:我们没有找到把合并作为去除拒答方法的一手来源。
方法 | 改变什么 | 需要训练吗? | 主要取舍 |
|---|---|---|---|
| 无审查微调 | 权重(通过新数据) | 需要 | 算力和数据质量 |
| Abliteration | 权重(单一方向) | 不需要 | 部分能力损失 |
| 自动化abliteration | 权重(搜索设置) | 不需要 | 试验时间和内存 |
| 模型合并 | 混合多个模型 | 不需要 | 对拒答未经验证 |
| 偏好优化 | 权重(通过偏好) | 需要 | 需要成对数据 |
最知名的微调路线是Eric Hartford的Dolphin系列,它把拒答式回答从训练数据中过滤掉,并依靠系统提示词来决定行为。微调也可以通过LoRA适配器完成,已发表的研究报告称,少量有害数据的微调就能撤销安全训练(Qi et al.、Lermen et al.)。较新的权重编辑变体(如保持范数的双投影abliteration)试图减少附带损伤,DPO“修复”则用于在编辑后恢复质量。
最重要的无审查AI模型家族
Dolphin(cognitivecomputations以及较新的dphn组织)是最知名的微调系列。目前已核实的条目是Dolphin-Mistral-24B-Venice-Edition。其模型卡称由系统提示词决定行为,因此它是可引导的,而不是保证没有拒答。
Hermes(NousResearch)不是无审查家族。Hermes 4模型是中性对齐、可引导的。Nous自己的RefusalBench(如Hermes 4.3 36B模型卡所报道)显示,该模型回答了约72-75%的测试提示词,也就是说大约四分之一仍被拒绝。不要把每个Hermes模型都归为无审查。
Qwen abliterated变体占据下载量的大头。已核实条目中下载量最高的是Huihui-Qwen3.8-27B-abliterated,约400万次下载。搜索:Hugging Face上的Qwen abliterated。
Gemma abliterated变体是最新的领域。Gemma 4的修改模型既有普通abliteration版本,也有Heretic和ARA版本。搜索:Gemma abliterated。其中一个Gemma 4 31B ARA模型声称拒答大幅下降,我们在下文检视。
Llama abliterated变体大多较旧。在我们2026-11-13的检查中,Llama 3.1和3.3之后的版本都没有很高的下载量,下载量最高的8B条目来自2024年。搜索:Llama abliterated。
Mistral、DeepSeek和GLM。存在Mistral Small 3.2 24B的abliteration版本。对于DeepSeek和GLM,最新模型的abliterated版本虽然存在,但分别约284 GB和321 GB,超出消费级硬件的范围;只有较旧的32B DeepSeek R1蒸馏模型是实用的。
对Gemma 4 31B说法的批判性解读。模型卡报告称,拒答从100个提示词中的99个降到了28个(Heretic v2.0.0 ARA,KL散度0.0845)。这是72%的相对降幅,同时也意味着仍有28个测试提示词触发了检测器。检测器是一份约34个关键词的列表(如“sorry”和“illegal”),作用于截断到100个词元的回答,所以带免责声明的有用回答会被算作拒答,而不含这些词的无效回答会被算作服从。测试集是来自同一数据集的100个提示词,原模型得分为99/100,KL数值只在无害提示词上测得,因此它无法说明能力如何。模型卡承诺可复现,但其自带的复现文件警告说使用了未提交的本地Heretic版本。我们没有找到独立评测。同一基础模型上的另一个31B重新打包版本报告为10/100、KL为0.054,但不同作者、不同运行和不同设置得出的结果无法比较。
💡提示: 像看基准分数一样看拒答数字:问清楚什么算拒答、用了多少提示词、回答允许多长,以及是谁做的测试。
从哪里可以下载无审查AI模型?
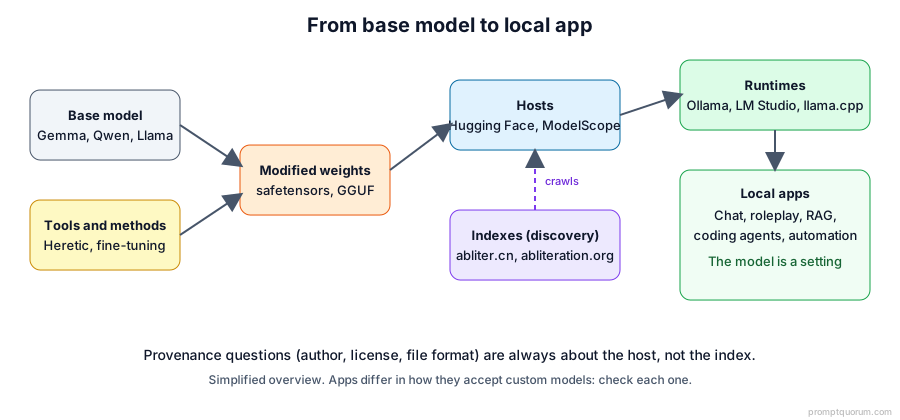
托管平台存储并提供文件本身。专门的索引站只是抓取托管平台,并增加一层发现功能。索引可以帮你找到候选模型,但你下载的文件仍来自托管方,所以来源问题始终关乎托管方和作者。
平台 | 作用 | 网站 |
|---|---|---|
| Hugging Face | 权重和模型卡 | huggingface.co |
| Ollama | 本地运行与分发 | ollama.com |
| ModelScope | 备选模型仓库 | modelscope.cn |
| GitHub | 工具和源代码 | github.com |
| Abliter.cn | 模型发现索引 | abliter.cn |
| Abliteration.org | 目录与分析 | abliteration.org |
运行前先核实。优先选择safetensors和GGUF文件。基于pickle的格式(.bin、.pt、.pkl、.ckpt)在加载时可能执行代码,Hugging Face文档建议使用可信作者和safetensors。切勿对陌生仓库启用trust_remote_code。确认模型卡写明了基础模型和方法,且基础模型链能追溯到官方仓库;作者提供哈希值时进行比对,并阅读许可证。Hugging Face会对小于2 GB的仓库文件运行恶意软件扫描,因此大型权重文件可能不在扫描范围内(这是我们对文档的理解)。来自信誉良好的量化者的量化副本,担保的是文件格式,而不是原作者的说法。huihui_ai和richardyoung等Ollama命名空间是用户上传的内容,并非经过库审核的模型。
哪些无审查模型值得下载?
我们于2026-11-13对照Hugging Face API和模型卡检查了十个当前的仓库,而不是对照旧文章。体积为仓库提供的Q4_K_M GGUF文件大小;内存数字是我们的估算值(文件大小加运行时和缓存),不是实测。下载量和日期不断变化,因此这张表只是一个快照,应当独立于文章进行刷新。
Gemma 4 31B ARA Heretic
- 基础模型:
- Gemma 4 31B-it
- 方法:
- Heretic 2.0 ARA
- 参数量:
- 30.7B
- Q4体积:
- 18.7 GB
- 内存(估算):
- 22-24 GB VRAM
- 上下文:
- 262K
- 许可证:
- Apache-2.0
- 已知局限:
- 未找到独立测试
Gemma 4 E4B Heretic
- 基础模型:
- Gemma 4 E4B-it
- 方法:
- Heretic ARA
- 参数量:
- 4.5B(有效)
- Q4体积:
- 5.3 GB
- 内存(估算):
- ~8 GB
- 上下文:
- 131K
- 许可证:
- Apache-2.0
- 已知局限:
- 重新打包者自己的测试
Huihui Gemma 4 12B
- 基础模型:
- Gemma 4 12B-it
- 方法:
- Abliteration
- 参数量:
- 12.0B
- Q4体积:
- 7.6 GB
- 内存(估算):
- 10-12 GB
- 上下文:
- 128-256K
- 许可证:
- Apache-2.0
- 已知局限:
- 模型卡:“概念验证”
Huihui Qwen3.8 27B
- 基础模型:
- Qwen3.8 27B
- 方法:
- Abliteration
- 参数量:
- 27.3B
- Q4体积:
- 16.6 GB
- 内存(估算):
- 20-22 GB
- 上下文:
- 262K
- 许可证:
- Apache-2.0
- 已知局限:
- 可能附带免责声明
Huihui Qwen3.5 9B
- 基础模型:
- Qwen3.5 9B
- 方法:
- Abliteration
- 参数量:
- 9.7B
- Q4体积:
- 5.6 GB
- 内存(估算):
- ~8 GB
- 上下文:
- 262K
- 许可证:
- Apache-2.0
- 已知局限:
- 模型卡无拒答数据
Dolphin Mistral 24B Venice
- 基础模型:
- Mistral Small 24B
- 方法:
- 微调
- 参数量:
- 24.0B
- Q4体积:
- 14.3 GB
- 内存(估算):
- 17-19 GB
- 上下文:
- 131K
- 许可证:
- Apache-2.0
- 已知局限:
- 行为由提示词决定
Hermes 4.3 36B
- 基础模型:
- Seed-OSS 36B
- 方法:
- 后训练
- 参数量:
- 36.2B
- Q4体积:
- 21.8 GB
- 内存(估算):
- 25-28 GB
- 上下文:
- 524K
- 许可证:
- Apache-2.0
- 已知局限:
- 并非无审查
Hermes 4 14B
- 基础模型:
- Qwen3 14B
- 方法:
- 后训练
- 参数量:
- 14.8B
- Q4体积:
- 9.0 GB
- 内存(估算):
- 11-12 GB
- 上下文:
- 41K
- 许可证:
- Apache-2.0
- 已知局限:
- 并非无审查
Llama 3.1 8B abliterated
- 基础模型:
- Llama 3.1 8B
- 方法:
- Abliteration
- 参数量:
- 8.0B
- Q4体积:
- 4.9 GB
- 内存(估算):
- 7-8 GB
- 上下文:
- 131K
- 许可证:
- Llama 3.1条款
- 已知局限:
- 2024年的版本
R1 Distill Qwen 32B
- 基础模型:
- R1-Distill-Qwen-32B
- 方法:
- Abliteration
- 参数量:
- 32.8B
- Q4体积:
- 19.9 GB
- 内存(估算):
- 23-26 GB
- 上下文:
- 131K
- 许可证:
- 未标注
- 已知局限:
- 2025年版本,无许可证标签
如何看这张表。Qwen3.8 27B的abliteration版本下载量远远领先(约400万次),但其模型卡称输出仍可能带有简短的免责警告,这提醒我们“abliterated”并不意味着“什么都会回答”。对于小内存设备,Gemma 4 E4B和Qwen3.5 9B这两项大约8 GB即可容纳。部分模型有已核实的Ollama标签:ollama run huihui_ai/gemma-4-abliterated:12b、ollama run huihui_ai/qwen3.5-abliterated:9b以及huihui_ai/Qwen3.8-abliterated(约18 GB);Gemma 4 31B模型在作者的命名空间下有一个Ollama页面。列出Hermes 4.3 36B,是为了让你能把一个可引导的中性对齐模型与那些修改版模型放在一起对照:Nous自己的基准测试中仍有约四分之一的提示词被拒绝。Llama 3.1条款要求标注“Built with Llama”,并要求衍生模型名称带有“Llama”前缀;R1蒸馏模型没有许可证标签,因此不要想当然地认为它有。此外还有Mistral Small 3.2的abliteration版本(24B)和Llama 3.3 70B的abliteration版本(Q4约42.5 GB,适合64 GB级设备),但它们都已较旧。
在本地应用中使用无审查模型
这一点之所以重要,在于本地AI的架构。大多数本地应用并不自带固定模型。它们连接到后端(通常是Ollama、llama.cpp或兼容OpenAI的服务器),或加载你选择的GGUF文件。
我们自己的评测在各个类别中都印证了这一模式。SillyTavern可连接KoboldCpp、text-generation-webui、Ollama或LM Studio。Open WebUI作为前端对接Ollama或任何兼容OpenAI的API。LM Studio运行GGUF模型,并内置Hugging Face浏览器。AnythingLLM、Msty和Cline可连接Ollama或LM Studio。n8n有专门的Ollama节点,KoboldCpp则直接运行GGUF文件。当模型只是一项设置时,你就可以按任务把中性模型换成无限制模型。
你能得到什么。你得到应用的功能和你自选的模型,离线运行,没有托管服务商读取对话。下表展示了不同类别的具体情形。在依赖之前,请确认你使用的应用版本接受自定义模型;这份列表只是起点,不是保证。
📍 简单一句话
由于大多数本地应用把模型视为可替换的设置,将它们与无限制模型搭配,可以在不改变应用的前提下改变整个应用的行为。
💬 简单来说
应用是车,模型是司机:换一个更常说“好”的司机,同一辆车就能开到以前去不了的地方。
应用类别 | 示例应用 | 无限制模型带来什么 |
|---|---|---|
| 聊天客户端 | LM Studio, Msty, Open WebUI | 被拒绝的问题更少 |
| 角色扮演与小说 | SillyTavern, KoboldCpp | 可写黑暗题材,场景中不被打断 |
| 文档RAG | AnythingLLM, Open WebUI | 推理留在你的设备上 |
| 编程智能体 | Cline, Aider, Continue | 协助安全测试代码 |
| 自动化 | n8n(Ollama节点) | 自定义流程,自有策略层 |
| 个人智能体 | Hermes Agent, nanobot | 自主性更强,需要防护 |
额外灵活性的具体例子。小说家可以在SillyTavern后面运行abliterated或可引导的模型,写道德上复杂的小说而不会在场景中途被拒绝,我们的创意写作指南对此有深入介绍。律师、记者或研究人员可以让AnythingLLM指向一个存放敏感文档的文件夹,并就托管模型可能不愿讨论的内容提问,推理在本机上运行。请检查各应用的遥测和更新设置,因为应用和模型下载仍可能使用网络。安全从业者可以在获得授权的测试环境中,使用搭配了不会对漏洞利用类问题打退堂鼓的模型的编程智能体。开发者可以搭建一个以模型为设置项的n8n工作流,之后无需改动任何东西就能更换模型。高级用户可以在一个应用中运行两个模型,一个中性模型处理日常工作,一个无限制模型处理前者拒绝的任务。
如何在本地运行无审查AI
Ollama(ollama.com)是命令行用户最简单的途径:按名称拉取模型,它就会提供许多应用都能识别的API。LM Studio(lmstudio.ai)是图形界面的途径,内置Hugging Face浏览器和本地兼容OpenAI的服务器。llama.cpp(github.com/ggml-org/llama.cpp)是许多此类工具背后的引擎,可直接运行GGUF文件。Transformers(huggingface.co/docs/transformers)在Python中加载全精度safetensors权重,适合研究,以及打算评估或修改模型的人。
GGUF与量化。GGUF是基于llama.cpp的工具所用的单文件格式。量化是用更少的位数存储权重:Q4_K_M是常见的折中方案,体积约为全精度的四分之一,质量损失有限。更低的量化级别可以节省内存,但可能损害推理和指令遵循能力,因此请测试你实际使用的那个文件。
硬件。在Apple Silicon上,统一内存由CPU和GPU共享,因此32 GB的Mac可以容纳约24-27B参数的Q4模型加上上下文;请给系统留出几GB。在NVIDIA GPU上,模型应当能放进显存:24 GB的显卡适合上文中的24-31B模型,8 GB适合4-9B模型。如果模型放不下,部分层会溢出到系统内存,速度会急剧下降。具体数字请参见本地LLM需要多少显存。
离线运行。权重存到磁盘之后,这些工具生成文本都不需要联网。这是隐私方面的主要理由,同时也是没有任何服务商能对本地副本强制执行使用规则的原因。
你能自己制作abliterated模型吗?
从概念上说可以,而且比过去容易上手。我们只在高层次上描述这个流程。
- 1选择一个开放权重模型
Why it matters: 选一个大小适合你内存的,因为工具必须加载它。 - 2检查许可证
Why it matters: 一些许可证和使用政策限制规避安全过滤(早期的Gemma条款即是如此);修改或再分发之前,请先阅读所用基础模型的许可证。 - 3检查架构兼容性
Why it matters: 工具只支持特定架构;新模型可能还不能用。 - 4选择方法
Why it matters: 经典的方向消融,或使用ARA的Heretic等自动化工具。 - 5运行修改
Why it matters: 自动化工具会搜索许多设置;经典方法则依赖你对层的选择。 - 6评估结果
Why it matters: 在工具没有调优过的提示词上测量拒答和质量损失。 - 7与原模型对比
Why it matters: 即使拒答减少,能力也可能下降。 - 8负责任地记录和发布
Why it matters: 说明方法、数据、基础模型和许可证链。
无审查AI有哪些风险?
我们只在理解风险所需的程度上描述它们,不提供任何可操作的细节。
- 网络犯罪与恶意软件协助。拒答更少的模型降低了获得编写恶意代码帮助所需的努力。它是否带来超出现有渠道的额外能力,目前存在争论。
- 网络钓鱼与欺诈。任何有能力的模型都很容易写出流畅、个性化的诈骗文本;拒答曾是一个摩擦点,如今这一点已被削弱。
- 危险的生物与化学信息。这是政策辩论中风险最高的担忧。已报告的拒答率数字衡量的是回答意愿,而不是现实中的能力提升,因此它们既不能证明危险,也不能证明安全。
- 与武器相关的滥用。同样的提醒适用:测得的服从率不等于已被证明的能力。
- 骚扰与侮辱性内容。本地模型可以大规模生成侮辱性材料。在我们所知的司法辖区,儿童性虐待材料属于刑事犯罪。在德国,《刑法典》第184b条(§ 184b StGB)也涵盖逼真的描绘内容,因此请假定逼真的AI生成材料可能受到处罚。请勿生成、索取或存储。
- 虚假信息。拒答减少也意味着制作有说服力的虚假内容的障碍更少。
- 隐私与数据安全。本地推理会让你的提示词留在本机,但下载是另一种风险:陌生的仓库可能含有恶意文件,应用也仍可能发起网络请求。
- 恶意模型文件。基于pickle的格式在加载时可以运行代码,扫描并不能提供保证(参见Hugging Face的pickle扫描文档)。请使用来自已知作者的safetensors或GGUF。
- 拥有工具权限的自主智能体。这是最大的转变:连接到文件、shell或网络的无限制模型可以采取行动。OWASP把提示词注入(LLM01)和过度自主权(LLM06)列为LLM应用的主要风险。
为什么有些人反对AI防护?
支持限制更少的模型的最有力理由,值得公平地陈述。
- 言论自由。支持者认为,工具不应该决定成年人可以读什么、写什么。
- 科学研究。研究模型行为(包括拒答)需要可以被修改的模型;abliteration研究本身就依赖开放权重。
- 安全测试。红队需要能够讨论攻击的模型,以便测试防御。
- 创意写作。小说需要反派、暴力和道德复杂性,而过于谨慎的模型可能会把这些抹平。
- 用户自主权。有人认为,本地工具的限制应由用户而不是厂商来设定。
- 隐私与本地运行。敏感材料在你的设备上处理,因此没有托管服务商会收到该提示词;请检查每个应用的遥测设置。
- 避免过度限制。商业模型的批评者举出它们拒绝无害问题的例子。Eric Hartford的关于无审查模型的文章就提出了这一论点。
为什么AI防护措施很重要?
反方的论点同样真实。防护措施降低了模型协助严重伤害的可能性,保护脆弱用户,并使在产品中部署成为站得住脚的选择。
关键的区别在于生成文本的模型与能够执行命令、读取文件、浏览网页或与其他系统交互的智能体。如果聊天模型写出了有害内容,仍然需要有人据此行动。如果搭载同一模型的智能体采取行动,输出与后果之间的距离就消失了。
开放模型中的防护很难做到防篡改:上文的abliteration研究表明,一次权重编辑就能抑制拒绝行为。这是支持加强模型层面保护和在模型外部设置控制措施的核心论据。
你能自建防护措施吗?
可以。因为本地模型没有服务商一侧的防护层,所以你要在它周围自己加上。
- 内容审核层。对输入和输出运行Llama Guard或ShieldGemma等分类器。
- 输入与输出过滤。屏蔽或审查你不希望出现在工作流中的类别。
- 沙箱。在容器或虚拟机中运行智能体,使其无法访问任何你输不起的东西。
- 权限限制。只给智能体它所需的最小权限:只读文件夹、无网络,除非必要否则不给shell。
- 人工批准。要求智能体在写入文件、运行命令或发送消息之前先获得确认。
- 日志与监控。记录智能体做了什么以及为什么这样做。
- 智能体安全。把智能体读取的每份文档、网页或邮件都视为可能包含指令的不可信输入(提示词注入)。
下载和使用无审查AI模型合法吗?
没有单一的答案,这也不构成法律意见。需要区分的问题是持有、分发和使用,答案可能因国家以及模型的用途而异。
欧盟AI法案。法规(EU)2024/1689对通用AI模型的提供者施加义务,对开源模型有部分豁免,但该豁免不适用于具有系统性风险的模型。通用AI模型的义务自2025-08-02起适用,欧盟委员会的执法权力自2026-08-02起适用。2025年的欧盟委员会指南指出,下游修改者只有在超过一个指示性算力门槛时才成为提供者;我们认为abliteration远低于该门槛,但这一标准不具约束力。我们无法从文本中确认2026年的数字综合法案(Digital Omnibus)是否改变了通用AI的日期,请查阅现行文本。
持有与使用。拥有一个模型文件与用它实施违法行为是两回事。刑法针对的是具体行为:制作禁止内容、欺诈、骚扰,或专为计算机犯罪设计的工具。我们对德国法律条文只做了部分审阅,所以请不要依赖本指南来了解这些条文。
许可证与合同。许可证在法律之上增加规则。Gemma 4模型卡列出的是Apache-2.0,并链接到Gemma 4许可证页面;而早期的Gemma各代使用Gemma条款和使用限制政策,其中禁止规避安全过滤。请查看所用基础模型的许可证页面。Llama 3.1许可证要求标注“Built with Llama”,并要求衍生模型名称带有前缀,其可接受使用政策限制某些用途,但据我们理解并没有明确的反规避条款。表中列出的Qwen3.5和Qwen3.8模型卡显示为Apache-2.0。请始终阅读基础模型的许可证,而不只是衍生模型的。
数据保护与版权。在本地处理个人数据仍然受数据保护法约束,而底层模型训练数据的版权问题尚无定论。移除拒答并不会改变这两点。
无审查AI正在成为AI生态中的永久组成部分吗?
有几个趋势指向“是”。社区修改规模庞大且仍在增长:上文的Hugging Face标签数量达到数千个仓库。工具正变得更自动化:Heretic会为你搜索设置,ARA则超越了单一方向。移除拒答的新技术会不断出现,让防护更难被移除的技术也是如此。
其他发展则指向不同方向:让部署者选择策略的可配置安全架构、提供限制更少的模型的商业服务、越来越多把控制权交给用户的本地AI,以及仍在成形的监管。开放权重能否做到防篡改,这一争论预计还会持续。
结论。开放权重AI让用户对模型行为有了更大的控制权,而应用层使这种控制变得切实可行。但移除防护并不会移除责任:它把责任转移给了运行模型的人。
来源
- Arditi等人,Refusal in Language Models Is Mediated by a Single Direction — arXiv 2406.11717
- Heretic代码仓库与发布页 — github.com/p-e-w/heretic
- Maxime Labonne,Uncensor any LLM with abliteration — Hugging Face博客
- Young,Comparative Analysis of LLM Abliteration Methods — arXiv 2512.13655(仅摘要)
- Alice,One Pass to Break Them All(2026年报告)— 报告PDF,厂商研究,未经同行评审
- WIRED,Tear Down Those Guardrails!(2026-11-10/11)— 仅阅读了转载,按报道引用
- Abliter.cn — abliter.cn;Abliteration.org — abliteration.org(网站返回访问错误;使用了README镜像)
- Hugging Face标签页 — abliterated、uncensored、heretic
- Ollama模型库 — ollama.com/library
- 法规(EU)2024/1689(AI法案),第2(12)条和第53条;欧盟委员会通用AI模型指南(2025)
- Gemma使用限制政策与条款;Llama 3.1许可证与可接受使用政策;Qwen3模型卡
- Hugging Face文档:Pickle Scanning和Malware Scanning;OWASP大语言模型应用十大风险
常见问题
什么是无审查AI模型?
无审查AI模型是拒答被削弱或移除的开放权重语言模型,方法是微调或编辑权重。结果很少是彻底的:对知名修改模型已发布的测试仍显示存在残余拒答。
无审查与abliterated AI有什么区别?
“无审查”描述的是结果,即拒答更少。“Abliterated”描述的是方法,即编辑权重以抑制拒答行为。Abliterated模型通常限制更少,但模型名称中的“uncensored”在没有实测结果的情况下说明不了什么。
最好的无审查大模型是哪个?
没有唯一的最佳选择。小内存设备上,4-9B的Gemma和Qwen abliterated版本约8 GB即可容纳。24 GB显卡则可运行Dolphin Mistral 24B或Qwen3.8 27B abliterated版本等24-31B模型。请查看模型卡中的证据、许可证和近期活跃度,并用你自己的任务来测试。
无审查AI模型免费吗?
权重通常可以免费下载,许可证如Apache-2.0或Llama社区许可证。硬件和电费仍需你自己承担,部分许可证对使用和再分发附有条件。
在哪里可以下载无审查模型?
Hugging Face是权重和模型卡的主要托管方,Ollama则以即可运行的标签形式分发许多模型。ModelScope是备选托管方。Abliter.cn和Abliteration.org是帮助你发现模型的索引站,不托管文件。
我可以在本地运行无审查AI吗?
可以。下载GGUF文件或Ollama标签,在Ollama、LM Studio或llama.cpp中运行即可。7-9B模型大约需要8 GB内存,24-31B模型在Q4下大约需要20-28 GB。
什么是Heretic?
Heretic是Philipp Emanuel Weidmann开发的开源工具,可自动搜索既能去除拒答、又尽量少改动模型的设置。2026-11-01发布的2.0版本将任意秩消融(ARA)设为默认方法。
Abliteration会移除所有AI防护吗?
不会。它针对的是拒答行为,并不保证每一次拒答都会消失。已发布的测试显示存在残余拒答,质量也可能下降,在原始研究中尤其体现在真实性基准上。
无审查模型危险吗?
它们可能被滥用,当模型连接到shell、文件或网络等工具时风险会上升。在普通聊天窗口中,它只生成文本。对智能体请使用沙箱、最小权限、人工批准和日志记录。
在欧洲使用无审查AI合法吗?
这取决于持有、分发和使用。拥有模型与用它实施违法行为是两回事。欧盟AI法案主要约束提供者,Llama等许可证还会增加合同层面的限制。以上不构成法律意见;具体情况请咨询律师。
哪些本地应用可以使用无审查模型?
任何允许你选择模型的应用,包括通过Ollama或兼容OpenAI的连接使用的LM Studio、Open WebUI、SillyTavern、AnythingLLM、Msty、KoboldCpp、Cline和n8n。请确认你使用的版本接受自定义模型。