Faits essentiels
- Article de référence : Arditi et al., « Refusal in Language Models Is Mediated by a Single Direction » (arXiv 2406.11717, 2024), 13 modèles de chat de 1,8B à 72B de paramètres.
- Heretic : créé par Philipp Emanuel Weidmann (p-e-w) ; la version 2.0.0 est parue le 2026-11-01, la 2.1.0 le 2026-11-08 ; utilise Optuna pour chercher les paramètres et évalue les refus et la divergence KL.
- Nombre de dépôts par tag Hugging Face (2026-11-13) : abliterated 13 279 ; uncensored 16 629 ; heretic 7 058, quantifications et doublons compris.
- Tailles typiques (GGUF Q4_K_M) : 8B environ 5 Go ; 12B environ 7.6 Go ; 24B environ 14 Go ; 27B environ 16.6 Go ; 31B environ 18.7 Go.
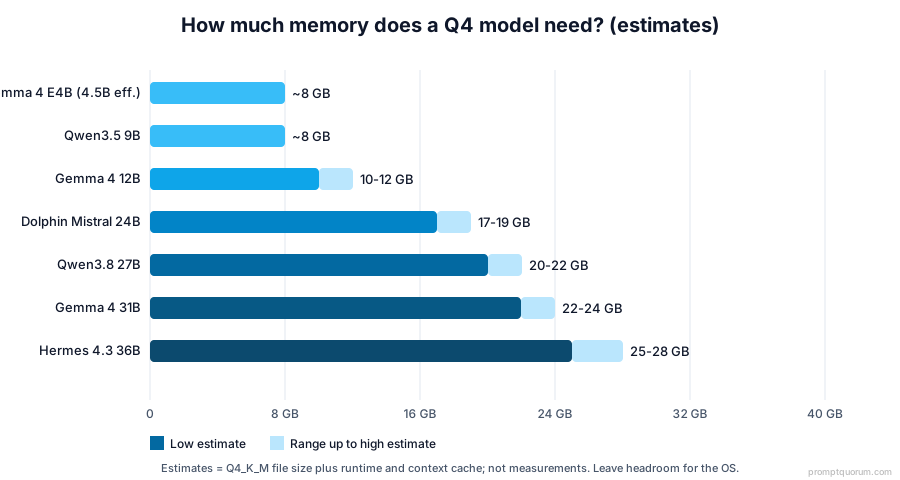
- Estimation de mémoire : un modèle 31B en Q4 demande environ 22 à 24 Go de VRAM ou 32 Go de RAM ; ce sont des estimations, pas des mesures.
- Formats de fichier à moindre risque : privilégiez safetensors et GGUF plutôt que les fichiers .bin, .pt ou .ckpt basés sur pickle.
Que sont les modèles d'IA non censurés ?
Deux personnes téléchargent le même modèle à poids ouverts. La première lui pose une question limite et reçoit un refus poli. La seconde a téléchargé une copie modifiée du même modèle de base, pose la même question et obtient une réponse. Même architecture, mêmes connaissances, comportement différent. Cet écart résume toute l'histoire de l'IA non censurée.
Cela est possible parce que les modèles à poids ouverts sont des fichiers. Un chatbot hébergé garde ses poids, son prompt système et ses filtres sur les serveurs d'un tiers : vous ne pouvez que lui parler. Un modèle à poids ouverts vous donne les poids. N'importe qui peut les affiner, les fusionner, les quantifier ou les modifier, puis publier le résultat. Le comportement de refus est une chose que le modèle a apprise ; il peut donc être désappris ou supprimé.
L'IA locale rend cela concret. Un modèle de 12B ou 24B tourne désormais sur un portable ou un seul GPU, hors ligne, dans des applications en lesquelles vous avez déjà confiance. Le 2026-11-13, les pages de tags de Hugging Face listaient 13 279 dépôts tagués abliterated, 16 629 tagués uncensored et 7 058 tagués heretic, mais ces chiffres incluent quantifications et doublons. Deux index spécialisés existent aussi : abliter.cn affichait 921 modèles sur 25 796 dépôts analysés, et abliteration.org décrit un catalogue de plus de 19 000 modèles. Leurs règles d'inclusion diffèrent, donc ces nombres ne décrivent pas la même chose.
Le sujet fait aussi l'actualité. Heretic 2.0 est sorti le 2026-11-01 et a remplacé la technique classique à direction unique comme méthode par défaut de l'outil. WIRED a publié un portrait de la communauté le 2026-11-10 (nous n'avons pu lire que des reprises, donc nous le citons tel que rapporté). Un modèle Gemma 4 31B modifié, publié le 2026-11-05, annonce une forte baisse des refus ; nous examinons ses chiffres plus bas.
Ce guide commence par le phénomène, puis explique les termes, la science et les outils. Une idée le traverse : considérez ces modèles comme un composant interchangeable des applications locales. L'application fournit documents, voix, agents et une interface utilisable ; le modèle décide de ce à quoi il répond. Leur association offre une souplesse qu'aucun service hébergé ne propose, et elle supprime aussi le filet de sécurité qu'un service hébergé apporte.
📍 En une phrase
Les modèles d'IA non censurés sont des modèles de langage à poids ouverts modifiés, par fine-tuning ou par édition des poids, pour refuser moins de requêtes que l'original.
💬 En termes simples
Voyez un modèle comme un fichier qui vous appartient. Quelqu'un peut le modifier pour qu'il dise oui plus souvent, et vous pouvez exécuter ce fichier modifié dans vos propres applications.
Que signifie vraiment « non censuré » ?
Ces mots sont employés à la légère, et c'est ainsi qu'on télécharge un modèle qui ne se comporte pas comme annoncé. Voici le sens technique de chaque terme.
📍 En une phrase
« Non censuré » décrit un résultat (moins de refus), alors qu'« abliterated » décrit une méthode (édition des poids) : un modèle peut donc être l'un sans l'autre.
💬 En termes simples
Non censuré est ce qu'on espère, abliterated est la façon dont il a été fabriqué, et jailbreaké est une astuce appliquée à un modèle inchangé.
Terme | Signification | Garantie technique ? |
|---|---|---|
| Uncensored | Peu ou pas de refus de contenu | Non |
| Unfiltered | Filtrage de sortie moins strict | Non |
| Unaligned | Alignement réduit ou différent | Non |
| Abliterated | Poids modifiés par ablation | Méthode seulement |
| Jailbroken | Comportement contourné par prompt | Non, poids inchangés |
| Unrestricted | Terme marketing | Non |
Le jailbreak fait figure d'exception : il modifie le prompt, pas le modèle, donc la conversation suivante repart de zéro. Les autres termes décrivent une intervention sur les poids.
⚠️Attention: Un modèle dont le nom contient « uncensored » n'a pas forcément perdu ses refus. Vérifiez si la fiche du modèle indique un taux de refus mesuré et comment il a été mesuré.
💡Astuce: Deux choses différentes sont souvent confondues : un modèle orientable (Hermes, Dolphin) laisse le prompt système définir le comportement, alors qu'un modèle abliterated a vu son comportement de refus retiré de ses poids.
Comment les modèles d'IA apprennent à refuser des requêtes
Le préentraînement apprend au modèle à prédire du texte à partir d'un corpus immense. Il produit un système capable mais sans direction, qui prolongera à peu près n'importe quoi. Le réglage par instructions et le fine-tuning supervisé (SFT) l'entraînent ensuite sur des exemples de conversations pour qu'il réponde aux questions dans un format utile.
L'entraînement par préférences ajoute la couche de sécurité. Avec le RLHF (apprentissage par renforcement à partir de retours humains), des évaluateurs comparent des réponses, un modèle de récompense apprend leurs préférences et le modèle est optimisé dans ce sens. Le DPO (optimisation directe des préférences) aboutit à un résultat voisin sans modèle de récompense séparé. Des jeux de données de sécurité associent des requêtes dangereuses à des refus, si bien que le modèle apprend que certains types de requêtes doivent être déclinés : c'est l'entraînement au refus.
Où ce comportement réside-t-il ? À deux endroits. Un prompt système est un texte ajouté à l'exécution, que vous pouvez modifier. Le comportement inscrit dans les poids est fixé pendant l'entraînement et ne se change qu'en touchant aux poids. C'est pourquoi un prompt système seul ne suffit parfois pas à faire répondre un modèle, et pourquoi une modification des poids le peut.
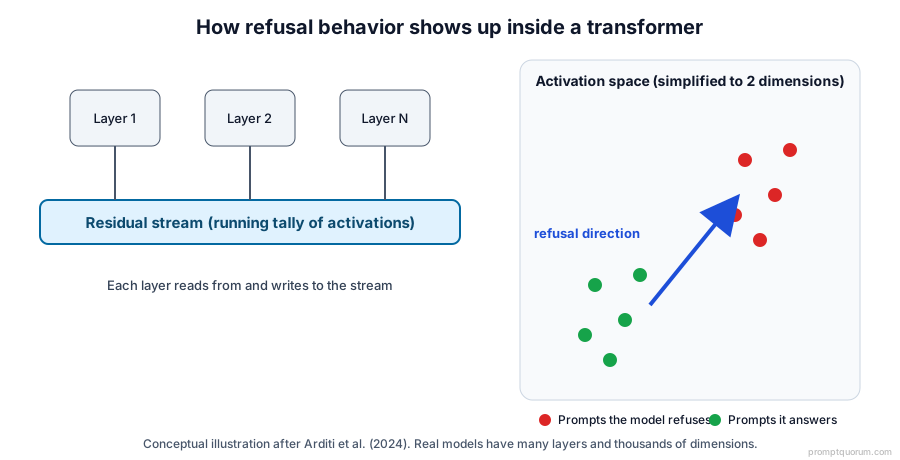
Le schéma illustre l'idée qui rend l'abliteration possible. Dans un transformer, chaque couche lit et écrit dans un cumul partagé appelé flux résiduel. Les recherches suggèrent que, pour les refus, une grande part du signal se situe le long d'une seule direction de ce flux.
Qu'est-ce que l'abliteration ?
Le fondement scientifique est Arditi et al. (2024), « Refusal in Language Models Is Mediated by a Single Direction » (arXiv 2406.11717). Les auteurs ont testé 13 modèles de chat ouverts de 1,8B à 72B de paramètres. Leur constat : pour ces modèles, le refus est médié par une seule direction du flux résiduel.
Comment la direction est trouvée. On exécute le modèle sur un ensemble de prompts nuisibles et un ensemble de prompts inoffensifs, on enregistre les activations internes à une couche et une position de token choisies, puis on calcule la différence des deux moyennes. Ce vecteur de différence des moyennes est la direction de refus candidate.
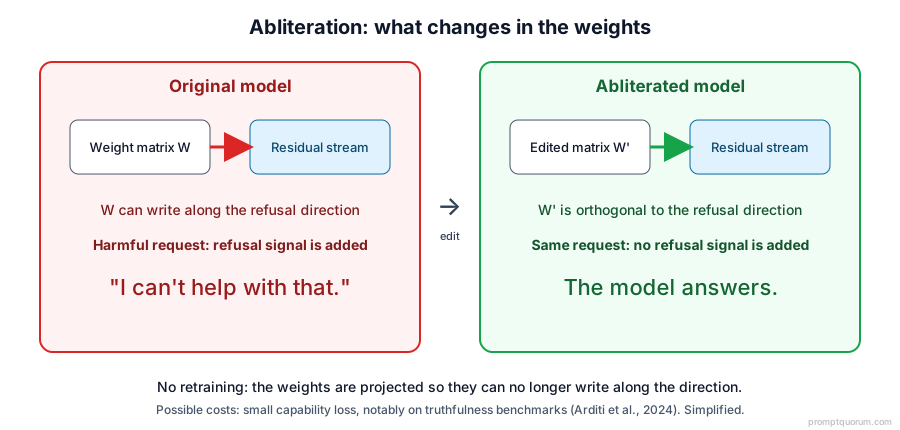
Comment elle est retirée. L'ablation directionnelle projette cette direction hors des activations à l'exécution. L'orthogonalisation des poids obtient le même effet de façon permanente : les matrices de poids qui écrivent dans le flux résiduel sont modifiées pour ne plus pouvoir écrire le long de cette direction. Le modèle modifié ne demande aucun réentraînement, et son fichier ressemble à n'importe quel autre modèle.
Ce qui est perdu. Les auteurs rapportent de faibles baisses de capacité sur la plupart des benchmarks, avec TruthfulQA comme exception : il a reculé de façon constante, d'environ 1 à 3,5 points. Ils décrivent aussi leur méthode de sélection de la direction comme heuristique. Le guide pratique de Maxime Labonne a constaté que l'abliteration faisait baisser tous les benchmarks qu'il a mesurés, qu'une étape de « guérison » par DPO en récupérait l'essentiel mais pas la totalité, et que le choix de la couche demande du jugement.
Une mise en garde sur les chiffres. L'éditeur de sécurité Alice a publié un rapport testant cinq modèles qui annonce 98,0 % de conformité après abliteration (539 prompts sur 550) contre 5,8 % avant, ainsi qu'un billet de blog annonçant 96 à 100 % sur six familles de modèles. Ces chiffres sont déclarés par l'entreprise, notés par un LLM juge, non évalués par des pairs, et mesurent la disposition à répondre plutôt qu'un gain de capacité réel. Considérez-les comme un indice, pas comme une preuve.
📍 En une phrase
L'abliteration estime une direction de refus à partir des différences d'activations et modifie les poids pour que le modèle ne puisse plus écrire le long de celle-ci.
💬 En termes simples
Si le refus est un cadran à l'intérieur du modèle, l'abliteration trouve le cadran et le retire, sans rien apprendre de nouveau au modèle.
Heretic 2.0 : la nouvelle génération de l'abliteration
Qui et quoi. Heretic est un outil open source en ligne de commande créé par Philipp Emanuel Weidmann (identifiant GitHub p-e-w). Au lieu de demander à un humain de choisir couches et intensités, il automatise la recherche.
L'approche d'origine. Heretic utilise Optuna, une bibliothèque d'optimisation d'hyperparamètres avec un échantillonneur TPE, pour essayer de nombreux réglages d'abliteration. Des scorers enfichables jugent chaque essai. Par défaut, il compte les refus avec un scorer à mots-clés et mesure la divergence KL par rapport au modèle d'origine sur des prompts inoffensifs : la recherche vise donc des réglages qui suppriment les refus en modifiant le reste le moins possible. Les modificateurs sont les composants qui modifient réellement les poids.
Ce qui change dans la 2.0. La version 2.0.0 est parue le 2026-11-01 (la 2.1.0 a suivi le 2026-11-08). Le modificateur par défaut est désormais l'Arbitrary-Rank Ablation (ARA) ; l'ablation directionnelle classique, avec ablation projetée et options de préservation de la norme, reste disponible. La version ajoute aussi un système de plugins, un fonctionnement sans interface et un scorer de refus basé sur BERT sous forme de plugin (le scorer par défaut reste à mots-clés). Les fichiers de configuration de Heretic 1.x ne fonctionnent pas avec la 2.x.
Ce qu'est l'ARA. Selon la pull request de l'auteur lui-même, l'ARA n'utilise pas de directions de refus. Elle apprend des modifications matricielles par module avec un optimiseur L-BFGS selon trois objectifs : laisser inchangées les sorties pour les prompts inoffensifs, rendre les sorties pour les prompts nuisibles semblables à celles des inoffensifs, et les éloigner des anciennes sorties nuisibles. Une direction unique est une modification de rang un ; l'ARA autorise des modifications de rang supérieur, et peut donc capter un comportement de refus qui n'est pas unidimensionnel. La description complète est toujours annoncée comme un preprint « bientôt » ; les affirmations de qualité sont donc celles de l'auteur et n'ont pas été vérifiées de façon indépendante.
Matériel et compromis. L'outil charge le modèle complet et exécute de nombreux essais ; il faut donc assez de mémoire pour exécuter le modèle que vous modifiez, plus du temps. Les compromis de qualité suivent le schéma des autres méthodes : une étude comparative de quatre outils sur 16 modèles (Young, arXiv 2512.13655, résumé lu) rapporte des variations de GSM8K de +1,5 à -18,8 points et des valeurs de KL de Heretic de 0,04 à 1,65 ; les résultats dépendent donc fortement du modèle.
⚠️Attention: Plusieurs détails de la 2.0 figurent dans des billets de blog tiers que nous n'avons pas pu rapprocher du dépôt. Nous n'indiquons que ce que disent le dépôt, les notes de version ou la pull request de l'auteur, et nous signalons le reste comme rapporté.
Autres façons de créer des modèles non censurés
L'abliteration n'est pas la seule voie. Le tableau compare les principales approches. La ligne sur la fusion est volontairement prudente : nous n'avons trouvé aucune source primaire documentant la fusion de modèles comme méthode de suppression des refus.
Méthode | Ce qui change | Entraînement ? | Principal compromis |
|---|---|---|---|
| Fine-tuning non censuré | Poids, via de nouvelles données | Oui | Calcul et qualité des données |
| Abliteration | Poids, une direction | Non | Perte de capacité |
| Abliteration automatisée | Poids, réglages recherchés | Non | Temps d'essais et mémoire |
| Fusion de modèles | Mélange plusieurs modèles | Non | Non vérifié pour les refus |
| Optimisation des préférences | Poids, via préférences | Oui | Données appariées requises |
L'approche de fine-tuning la plus connue est la lignée Dolphin d'Eric Hartford, qui retire les réponses de type refus des données d'entraînement et s'en remet au prompt système pour le comportement. Le fine-tuning peut aussi se faire avec des adaptateurs LoRA, et des recherches publiées rapportent que l'entraînement de sécurité peut être défait avec de petites quantités de fine-tuning nuisible (Qi et al., Lermen et al.). De nouvelles variantes d'édition des poids, comme l'abliteration biprojetée à norme préservée, tentent de réduire les dégâts collatéraux, et la « guérison » par DPO sert à récupérer la qualité après une modification.
Les principales familles de modèles d'IA non censurés
Dolphin (cognitivecomputations et la nouvelle organisation dphn) est la lignée fine-tunée la plus connue. L'entrée vérifiée actuelle est Dolphin-Mistral-24B-Venice-Edition. Sa fiche indique que le prompt système définit le comportement : le modèle est donc orientable, sans garantie d'absence de refus.
Hermes (NousResearch) n'est pas une famille non censurée. Les modèles Hermes 4 sont alignés de façon neutre et orientables. Le RefusalBench de Nous, tel que rapporté sur la fiche de Hermes 4.3 36B, indique que le modèle a répondu à environ 72 à 75 % de ses prompts de test : environ un quart reste donc refusé. Ne classez pas tous les modèles Hermes comme non censurés.
Les variantes Qwen abliterated dominent les téléchargements. L'entrée vérifiée la plus téléchargée est Huihui-Qwen3.8-27B-abliterated, avec environ 4 millions de téléchargements. Recherche : Qwen abliterated sur Hugging Face.
Les variantes Gemma abliterated sont le domaine le plus récent. Des modèles Gemma 4 modifiés existent en abliteration simple et avec Heretic et ARA. Recherche : Gemma abliterated. L'un d'eux, un modèle Gemma 4 31B ARA, annonce une forte réduction des refus, examinée plus bas.
Les variantes Llama abliterated sont surtout anciennes. Rien de plus récent que Llama 3.1 et 3.3 n'a de gros volumes de téléchargements dans notre vérification du 2026-11-13, et l'entrée 8B la plus téléchargée date de 2024. Recherche : Llama abliterated.
Mistral, DeepSeek et GLM. Une abliteration de Mistral Small 3.2 24B existe. Pour DeepSeek et GLM, des versions abliterated des modèles les plus récents existent mais pèsent environ 284 Go et 321 Go, hors de portée du matériel grand public ; seule une ancienne distillation DeepSeek R1 en 32B est praticable.
Lecture critique de l'affirmation sur Gemma 4 31B. La fiche du modèle indique des refus passant de 99 prompts sur 100 à 28 sur 100 (Heretic v2.0.0 ARA, divergence KL 0,0845). C'est une réduction relative de 72 %, et cela signifie aussi que 28 prompts de test sur 100 ont encore déclenché le détecteur. Le détecteur est une liste d'environ 34 mots-clés comme « sorry » et « illegal », appliquée à des réponses tronquées à 100 tokens : une réponse utile accompagnée d'un avertissement compte donc comme un refus, et une non-réponse sans ces mots compte comme une conformité. Le jeu de test compte 100 prompts d'un seul jeu de données, l'original a obtenu 99/100, et la valeur de KL est mesurée sur des prompts inoffensifs uniquement, ce qui ne dit rien des capacités. La fiche promet la reproductibilité, mais son propre fichier de reproduction avertit qu'une version locale non commitée de Heretic a été utilisée. Nous n'avons trouvé aucune évaluation indépendante. Un autre repack 31B sur la même base annonce 10/100 pour une KL de 0,054, mais des résultats d'auteurs, d'exécutions et de réglages différents ne sont pas comparables.
💡Astuce: Lisez les chiffres de refus comme des chiffres de benchmark : demandez ce qui comptait comme un refus, combien de prompts, quelle longueur de réponse était autorisée, et qui a mené le test.
Où télécharger des modèles d'IA non censurés ?
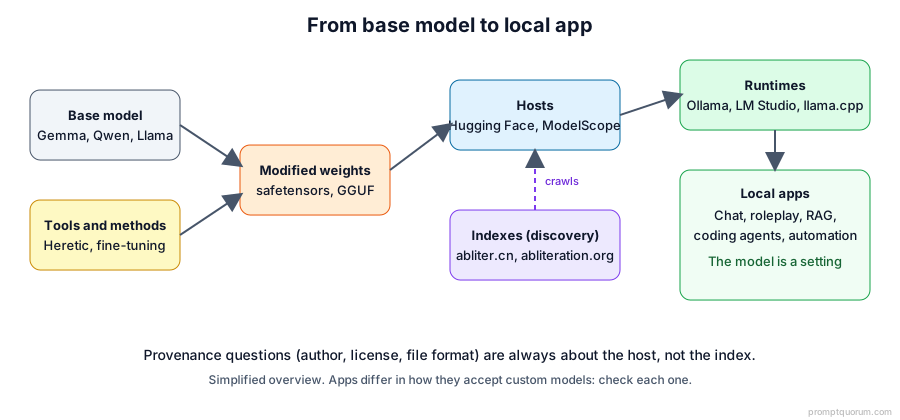
Une plateforme d'hébergement stocke et distribue les fichiers eux-mêmes. Un index spécialisé se contente d'explorer les plateformes d'hébergement et ajoute une couche de découverte. Un index peut aider à trouver des candidats, mais le fichier que vous téléchargez vient toujours de l'hébergeur ; les questions de provenance concernent donc toujours l'hébergeur et l'auteur.
Plateforme | Rôle | Site web |
|---|---|---|
| Hugging Face | Poids et fiches de modèles | huggingface.co |
| Ollama | Exécution et distribution en local | ollama.com |
| ModelScope | Dépôt alternatif | modelscope.cn |
| GitHub | Outils et code source | github.com |
| Abliter.cn | Index de découverte | abliter.cn |
| Abliteration.org | Catalogue et statistiques | abliteration.org |
Vérifiez avant d'exécuter. Privilégiez les fichiers safetensors et GGUF. Les formats basés sur pickle (.bin, .pt, .pkl, .ckpt) peuvent exécuter du code au chargement, et la documentation de Hugging Face recommande des auteurs de confiance et safetensors. N'activez jamais trust_remote_code sur un dépôt inconnu. Vérifiez que la fiche du modèle nomme le modèle de base et la méthode, que la chaîne de modèles de base mène au dépôt officiel, comparez les empreintes de fichiers lorsque l'auteur les publie, et lisez la licence. Hugging Face exécute une analyse antimalware sur les fichiers de dépôt de moins de 2 Go : les gros fichiers de poids peuvent donc y échapper (notre lecture de la documentation). Les copies quantifiées de quantificateurs réputés garantissent le format du fichier, pas les affirmations de l'auteur d'origine. Les espaces de noms Ollama comme huihui_ai et richardyoung sont des envois d'utilisateurs, pas des modèles validés par la bibliothèque.
Quels modèles non censurés valent le téléchargement ?
Nous avons vérifié dix dépôts actuels le 2026-11-13 auprès de l'API Hugging Face et des fiches de modèles, et non d'après d'anciens articles. Les tailles sont celles des fichiers GGUF Q4_K_M lorsqu'un dépôt les publie ; les chiffres de mémoire sont nos estimations (taille du fichier plus runtime et cache), pas des mesures. Les nombres de téléchargements et les dates changent constamment : ce tableau est un instantané et doit être actualisé indépendamment de l'article.
Gemma 4 31B ARA Heretic
- Base:
- Gemma 4 31B-it
- Méthode:
- Heretic 2.0 ARA
- Param.:
- 30.7B
- Taille Q4:
- 18.7 Go
- Mémoire (est.):
- 22-24 Go VRAM
- Contexte:
- 262K
- Licence:
- Apache-2.0
- Limites connues:
- Aucun test indépendant trouvé
Gemma 4 E4B Heretic
- Base:
- Gemma 4 E4B-it
- Méthode:
- Heretic ARA
- Param.:
- 4.5B eff.
- Taille Q4:
- 5.3 Go
- Mémoire (est.):
- ~8 Go
- Contexte:
- 131K
- Licence:
- Apache-2.0
- Limites connues:
- Tests du repackageur
Huihui Gemma 4 12B
- Base:
- Gemma 4 12B-it
- Méthode:
- Abliteration
- Param.:
- 12.0B
- Taille Q4:
- 7.6 Go
- Mémoire (est.):
- 10-12 Go
- Contexte:
- 128-256K
- Licence:
- Apache-2.0
- Limites connues:
- Fiche : « preuve de concept »
Huihui Qwen3.8 27B
- Base:
- Qwen3.8 27B
- Méthode:
- Abliteration
- Param.:
- 27.3B
- Taille Q4:
- 16.6 Go
- Mémoire (est.):
- 20-22 Go
- Contexte:
- 262K
- Licence:
- Apache-2.0
- Limites connues:
- Avertissements possibles
Huihui Qwen3.5 9B
- Base:
- Qwen3.5 9B
- Méthode:
- Abliteration
- Param.:
- 9.7B
- Taille Q4:
- 5.6 Go
- Mémoire (est.):
- ~8 Go
- Contexte:
- 262K
- Licence:
- Apache-2.0
- Limites connues:
- Aucune donnée de refus
Dolphin Mistral 24B Venice
- Base:
- Mistral Small 24B
- Méthode:
- Fine-tuning
- Param.:
- 24.0B
- Taille Q4:
- 14.3 Go
- Mémoire (est.):
- 17-19 Go
- Contexte:
- 131K
- Licence:
- Apache-2.0
- Limites connues:
- Le prompt fixe le comportement
Hermes 4.3 36B
- Base:
- Seed-OSS 36B
- Méthode:
- Post-entraînement
- Param.:
- 36.2B
- Taille Q4:
- 21.8 Go
- Mémoire (est.):
- 25-28 Go
- Contexte:
- 524K
- Licence:
- Apache-2.0
- Limites connues:
- Non censuré : non
Hermes 4 14B
- Base:
- Qwen3 14B
- Méthode:
- Post-entraînement
- Param.:
- 14.8B
- Taille Q4:
- 9.0 Go
- Mémoire (est.):
- 11-12 Go
- Contexte:
- 41K
- Licence:
- Apache-2.0
- Limites connues:
- Non censuré : non
Llama 3.1 8B abliterated
- Base:
- Llama 3.1 8B
- Méthode:
- Abliteration
- Param.:
- 8.0B
- Taille Q4:
- 4.9 Go
- Mémoire (est.):
- 7-8 Go
- Contexte:
- 131K
- Licence:
- Termes Llama 3.1
- Limites connues:
- Date de 2024
R1 Distill Qwen 32B
- Base:
- R1-Distill-Qwen-32B
- Méthode:
- Abliteration
- Param.:
- 32.8B
- Taille Q4:
- 19.9 Go
- Mémoire (est.):
- 23-26 Go
- Contexte:
- 131K
- Licence:
- Non indiquée
- Limites connues:
- Date de 2025, sans licence
Comment lire le tableau. L'abliteration de Qwen3.8 27B est de loin la plus téléchargée (environ 4 millions), mais sa fiche indique que la sortie peut encore comporter un petit avertissement, rappel qu'« abliterated » ne veut pas dire « répondra à tout ». Pour les petites machines, les entrées Gemma 4 E4B et Qwen3.5 9B tiennent dans environ 8 Go. Des tags Ollama vérifiés existent pour certains : ollama run huihui_ai/gemma-4-abliterated:12b, ollama run huihui_ai/qwen3.5-abliterated:9b et huihui_ai/Qwen3.8-abliterated (environ 18 Go) ; le modèle Gemma 4 31B a une page Ollama sous l'espace de noms de l'auteur. Hermes 4.3 36B figure là pour que vous voyiez un modèle orientable et neutre à côté des modèles modifiés : le benchmark de Nous laisse environ un quart des prompts refusés. Les termes de Llama 3.1 exigent la mention « Built with Llama » et le préfixe « Llama » dans le nom des modèles dérivés, et la distillation R1 n'a pas de balise de licence : n'en supposez donc pas. Une abliteration de Mistral Small 3.2 (24B) et une abliteration de Llama 3.3 70B (environ 42.5 Go en Q4, pour des machines de classe 64 Go) existent aussi mais sont datées.
Utiliser des modèles non censurés dans des applications locales
La raison pour laquelle cela compte tient à l'architecture de l'IA locale. La plupart des applications locales ne livrent pas de modèle fixe. Elles se connectent à un backend, généralement Ollama, llama.cpp ou un serveur compatible OpenAI, ou chargent les fichiers GGUF de votre choix.
Nos propres fiches confirment ce schéma dans plusieurs catégories. SillyTavern se connecte à KoboldCpp, text-generation-webui, Ollama ou LM Studio. Open WebUI sert d'interface à Ollama ou à toute API compatible OpenAI. LM Studio exécute des modèles GGUF avec un navigateur Hugging Face intégré. AnythingLLM, Msty et Cline se connectent à Ollama ou LM Studio. n8n dispose d'un nœud Ollama dédié, et KoboldCpp exécute directement les fichiers GGUF. Quand le modèle est un réglage, vous pouvez remplacer un modèle neutre par un modèle sans restriction selon la tâche.
Ce que vous y gagnez. Vous obtenez les fonctions de l'application et le modèle de votre choix, hors ligne, sans qu'aucun fournisseur hébergé ne lise la conversation. Le tableau montre ce que cela donne par catégorie. Vérifiez que la version de l'application que vous utilisez accepte les modèles personnalisés avant de vous y fier ; cette liste est un point de départ, pas une garantie.
📍 En une phrase
Comme la plupart des applications locales traitent le modèle comme un réglage interchangeable, les associer à un modèle sans restriction change ce que fera toute l'application sans changer l'application.
💬 En termes simples
L'application est la voiture et le modèle est le conducteur : mettez un conducteur qui dit oui plus souvent et la même voiture va là où elle n'allait pas avant.
Catégorie d'application | Exemples d'applications | Ce que cela apporte |
|---|---|---|
| Clients de chat | LM Studio, Msty, Open WebUI | Moins de questions refusées |
| Jeu de rôle et fiction | SillyTavern, KoboldCpp | Thèmes sombres, pas de refus en scène |
| RAG sur documents | AnythingLLM, Open WebUI | L'inférence reste sur votre appareil |
| Agents de code | Cline, Aider, Continue | Aide au code de tests de sécurité |
| Automatisation | n8n avec nœud Ollama | Pipelines sur mesure, couche de règles propre |
| Agents personnels | Hermes Agent, nanobot | Plus d'autonomie, garde-fous requis |
Exemples concrets de cette souplesse supplémentaire. Un romancier peut exécuter un modèle abliterated ou orientable derrière SillyTavern pour une fiction moralement complexe sans refus en pleine scène, ce que notre guide d'écriture créative détaille. Un avocat, un journaliste ou un chercheur peut pointer AnythingLLM vers un dossier de documents sensibles et poser des questions sur un contenu qu'un modèle hébergé pourrait refuser d'aborder, l'inférence s'exécutant sur votre machine. Vérifiez les réglages de télémétrie et de mise à jour de chaque application, car les applications et les téléchargements de modèles peuvent tout de même utiliser le réseau. Un professionnel de la sécurité peut utiliser un agent de code avec un modèle qui ne recule pas devant des questions proches de l'exploitation, dans un environnement de test autorisé. Un développeur peut construire un workflow n8n dont le modèle est un réglage, puis le changer sans rien réécrire. Un utilisateur avancé peut exécuter deux modèles dans une même application, un neutre pour le quotidien et un sans restriction pour les tâches que le premier décline.
⚠️Attention: Cette souplesse a un prix. Dans une fenêtre de chat, un modèle sans restriction ne produit que du texte. Connecté à un agent avec accès aux fichiers, au shell ou au web, le même modèle peut agir sur ce qu'il génère. Associez ces configurations à un bac à sable, au moindre privilège et à une validation humaine.
💡Astuce: Vous ne savez pas quelle application peut charger votre modèle ou convient à votre matériel ? Filtrez l'annuaire des logiciels LLM locaux par usage, système et RAM, ou décrivez votre machine à Ask Hans.
Comment exécuter une IA non censurée en local
Ollama (ollama.com) est la voie la plus simple en ligne de commande : on récupère un modèle par son nom et il sert une API que de nombreuses applications comprennent. LM Studio (lmstudio.ai) est la voie graphique, avec un navigateur Hugging Face intégré et un serveur local compatible OpenAI. llama.cpp (github.com/ggml-org/llama.cpp) est le moteur sous-jacent de nombre de ces outils et exécute directement les fichiers GGUF. Transformers (huggingface.co/docs/transformers) charge en Python des poids safetensors en pleine précision, ce qui convient à la recherche et à quiconque veut évaluer ou modifier des modèles.
GGUF et quantification. GGUF est le format de fichier unique utilisé par les outils basés sur llama.cpp. La quantification stocke les poids avec moins de bits : Q4_K_M est le compromis habituel, avec environ un quart de la taille en pleine précision pour un coût de qualité modeste. Les quantifications plus basses économisent de la mémoire mais peuvent nuire au raisonnement et au suivi des instructions ; testez donc le fichier précis que vous utilisez.
Matériel. Sur Apple Silicon, la mémoire unifiée est partagée entre le CPU et le GPU : un Mac de 32 Go peut donc contenir un modèle Q4 d'environ 24 à 27B de paramètres plus le contexte ; laissez plusieurs gigaoctets au système. Sur les GPU NVIDIA, le modèle doit tenir dans la VRAM : une carte de 24 Go convient aux modèles de 24 à 31B ci-dessus, et 8 Go aux modèles de 4 à 9B. Si le modèle ne tient pas, des couches débordent dans la RAM système et la vitesse chute fortement. Pour les chiffres exacts, voir la VRAM nécessaire à un LLM local.
Fonctionnement hors ligne. Une fois les poids sur le disque, aucun de ces outils n'a besoin d'internet pour générer du texte. C'est l'argument principal de confidentialité, et aussi la raison pour laquelle aucun fournisseur ne peut faire respecter ses règles d'usage sur une copie locale.
Pouvez-vous créer votre propre modèle abliterated ?
En principe oui, et c'est plus accessible qu'avant. Nous ne décrivons le déroulement qu'à haut niveau.
- 1Choisir un modèle à poids ouverts
Why it matters: Prenez-en un dont la taille tient dans votre mémoire, car l'outil doit le charger. - 2Vérifier la licence
Why it matters: Certaines licences et politiques d'utilisation restreignent le contournement des filtres de sécurité (les anciennes conditions de Gemma le faisaient) ; lisez la licence exacte du modèle de base avant de modifier ou de redistribuer. - 3Vérifier la compatibilité d'architecture
Why it matters: Les outils prennent en charge des architectures précises ; un modèle récent peut ne pas encore fonctionner. - 4Choisir une méthode
Why it matters: Ablation directionnelle classique, ou un outil automatisé comme Heretic avec ARA. - 5Lancer la modification
Why it matters: Les outils automatisés recherchent de nombreux réglages ; les méthodes classiques reposent sur votre choix de couche. - 6Évaluer le résultat
Why it matters: Mesurez les refus et la perte de qualité sur des prompts que l'outil n'a pas utilisés pour régler. - 7Comparer avec l'original
Why it matters: La capacité peut baisser même quand les refus reculent. - 8Documenter et publier de façon responsable
Why it matters: Indiquez la méthode, les chiffres, le modèle de base et la chaîne de licences.
Quels sont les risques de l'IA non censurée ?
Nous décrivons les risques au niveau nécessaire pour les comprendre, sans aucun détail opérationnel.
- Cybercriminalité et aide aux logiciels malveillants. Un modèle qui refuse moins réduit l'effort nécessaire pour obtenir de l'aide à l'écriture de code malveillant. Qu'il apporte une capacité au-delà de ce qui est déjà disponible est débattu.
- Hameçonnage et fraude. Un texte d'arnaque fluide et personnalisé est facile à produire pour tout modèle capable ; les refus étaient un point de friction, et il est ici plus faible.
- Informations biologiques et chimiques dangereuses. C'est la préoccupation aux enjeux les plus élevés dans le débat politique. Les taux de refus rapportés mesurent la disposition à répondre, pas un gain réel de capacité ; ils ne prouvent donc ni le danger ni la sécurité.
- Usages détournés liés aux armes. La même prudence s'applique : une conformité mesurée n'est pas une capacité démontrée.
- Harcèlement et contenus abusifs. Les modèles locaux peuvent générer des contenus abusifs à grande échelle. Les contenus pédopornographiques constituent une infraction pénale dans les juridictions que nous connaissons. En Allemagne, le § 184b StGB couvre aussi les représentations réalistes ; partez donc du principe que des contenus réalistes générés par IA peuvent être punissables. Ne les générez pas, ne les demandez pas et ne les stockez pas.
- Désinformation. Moins de refus signifie aussi moins d'obstacles à la production de faux contenus persuasifs.
- Confidentialité et sécurité des données. L'inférence locale garde vos prompts sur votre machine, mais les téléchargements constituent un risque distinct : des dépôts inconnus peuvent contenir des fichiers malveillants, et les applications peuvent tout de même effectuer des appels réseau.
- Fichiers de modèles malveillants. Les formats basés sur pickle peuvent exécuter du code au chargement, et l'analyse automatique n'est pas une garantie (voir la documentation Hugging Face sur l'analyse des pickles). Utilisez safetensors ou GGUF d'auteurs connus.
- Agents autonomes avec accès à des outils. C'est le plus grand changement : un modèle sans restriction relié à des fichiers, à un shell ou au web peut agir. L'OWASP classe l'injection de prompt (LLM01) et l'autonomie excessive (LLM06) parmi les principaux risques des applications LLM.
Pourquoi certains sont-ils contre les garde-fous de l'IA ?
Les arguments les plus solides en faveur de modèles moins restrictifs méritent d'être exposés loyalement.
- Liberté d'expression. Les partisans soutiennent qu'un outil ne devrait pas décider de ce qu'un adulte peut lire ou écrire.
- Recherche scientifique. Étudier le comportement des modèles, refus compris, exige des modèles modifiables ; la recherche sur l'abliteration elle-même repose sur les poids ouverts.
- Tests de sécurité. Les équipes de red teaming ont besoin de modèles qui parlent d'attaques afin de tester les défenses.
- Écriture créative. La fiction a besoin de méchants, de violence et de complexité morale que des modèles trop prudents peuvent aplatir.
- Autonomie de l'utilisateur. Certains estiment que c'est l'utilisateur, et non l'éditeur, qui devrait fixer les limites d'un outil local.
- Confidentialité et exécution locale. Les contenus sensibles sont traités sur votre machine : aucun fournisseur hébergé ne reçoit le prompt ; vérifiez les réglages de télémétrie de chaque application.
- Éviter les restrictions excessives. Les détracteurs des modèles commerciaux citent des refus de questions anodines. Dans son essai sur les modèles non censurés, Eric Hartford défend cet argument.
Pourquoi les garde-fous de l'IA sont-ils importants ?
Les contre-arguments sont tout aussi réels. Les garde-fous réduisent la probabilité qu'un modèle aide à causer un préjudice grave, protègent les utilisateurs vulnérables et rendent défendable un déploiement dans des produits.
La distinction essentielle oppose un modèle qui génère du texte à un agent capable d'exécuter des commandes, de lire des fichiers, de naviguer sur le web ou d'interagir avec d'autres systèmes. Si un modèle de chat écrit quelque chose de nuisible, une personne doit encore passer à l'acte. Si un agent doté du même modèle agit, l'écart entre la sortie et la conséquence se referme.
Les garde-fous des modèles ouverts sont difficiles à rendre résistants à la manipulation : la recherche sur l'abliteration présentée plus haut montre qu'une seule modification de poids peut supprimer le comportement de refus. C'est un argument central en faveur de protections renforcées au niveau du modèle et de contrôles externes autour du modèle.
Pouvez-vous construire vos propres garde-fous ?
Oui. Comme un modèle local n'a pas de couche côté fournisseur, vous ajoutez la vôtre autour de lui.
- Couches de modération. Exécutez un classifieur comme Llama Guard ou ShieldGemma sur les entrées et les sorties.
- Filtrage des entrées et des sorties. Bloquez ou faites relire les catégories dont vous ne voulez pas dans votre flux de travail.
- Bac à sable. Exécutez les agents dans des conteneurs ou des machines virtuelles sans accès à rien de ce que vous ne pouvez vous permettre de perdre.
- Restrictions de permissions. Donnez aux agents le moindre privilège nécessaire : dossiers en lecture seule, pas de réseau, pas de shell sauf nécessité.
- Validation humaine. Exigez une confirmation avant qu'un agent écrive des fichiers, exécute des commandes ou envoie des messages.
- Journalisation et surveillance. Conservez une trace de ce que l'agent a fait et pourquoi.
- Sécurité des agents. Traitez chaque document, page web ou e-mail lu par l'agent comme une entrée non fiable pouvant contenir des instructions (injection de prompt).
Est-il légal de télécharger et d'utiliser des modèles d'IA non censurés ?
Il n'existe pas de réponse unique, et ceci n'est pas un avis juridique. Il faut distinguer la possession, la distribution et l'usage, et la réponse peut varier selon le pays et l'usage du modèle.
Règlement européen sur l'IA. Le règlement (UE) 2024/1689 impose des obligations aux fournisseurs de modèles d'IA à usage général, avec une exemption partielle pour les modèles open source qui ne s'applique pas aux modèles présentant un risque systémique. Les obligations pour les modèles d'IA à usage général s'appliquent à partir du 2025-08-02, et les pouvoirs d'exécution de la Commission à partir du 2026-08-02. Les lignes directrices 2025 de la Commission indiquent qu'un modificateur en aval ne devient fournisseur qu'au-delà d'un seuil de calcul indicatif ; nous lisons l'abliteration comme très en dessous, mais ce critère n'est pas contraignant. Nous n'avons pas pu confirmer d'après le texte si le Digital Omnibus de 2026 a modifié les dates pour l'IA à usage général ; consultez donc le texte en vigueur.
Possession et usage. Posséder un fichier de modèle est une chose distincte de l'utiliser pour commettre une infraction. Le droit pénal s'attache à des actes précis : produire des contenus interdits, fraude, harcèlement, ou outils conçus pour la cybercriminalité. Nous n'avons examiné les dispositions allemandes que partiellement ; ne vous fiez donc pas à ce guide pour elles.
Licences et contrats. Les licences ajoutent des règles au droit. Les fiches de modèle Gemma 4 indiquent Apache-2.0 et renvoient vers une page de licence Gemma 4, tandis que les générations Gemma antérieures reposaient sur les Gemma Terms et la Prohibited Use Policy, qui interdisent de contourner les filtres de sécurité ; consultez la page de licence du modèle de base exact. La licence Llama 3.1 exige la mention « Built with Llama » et un préfixe dans le nom des modèles dérivés, avec une politique d'utilisation acceptable qui restreint certains usages mais, selon notre lecture, ne contient pas de clause explicite contre le contournement. Les fiches Qwen3.5 et Qwen3.8 listées dans le tableau indiquent Apache-2.0. Lisez toujours la licence du modèle de base, pas seulement celle du dérivé.
Protection des données et droit d'auteur. Traiter des données personnelles en local relève toujours du droit de la protection des données, et les questions de droit d'auteur sur les données d'entraînement des modèles sous-jacents ne sont pas tranchées. Ni l'un ni l'autre ne change quand on retire les refus.
L'IA non censurée devient-elle une composante durable de l'écosystème de l'IA ?
Plusieurs tendances penchent pour le oui. La modification par la communauté est massive et croissante : les nombres de tags Hugging Face ci-dessus se chiffrent en milliers de dépôts. Les outils deviennent plus automatiques : Heretic recherche les réglages à votre place, et l'ARA dépasse la direction unique. De nouvelles techniques pour supprimer les refus continueront d'arriver, de même que des techniques qui rendent les garde-fous plus difficiles à retirer.
D'autres évolutions tirent dans des directions différentes : architectures de sécurité configurables qui laissent le déployeur choisir une politique, services commerciaux proposant des modèles moins restreints, IA locale qui donne de plus en plus le contrôle à l'utilisateur, et réglementation encore en formation. Attendez-vous à un débat continu sur la possibilité de rendre un jour les poids ouverts résistants à la manipulation.
Conclusion. L'IA à poids ouverts donne aux utilisateurs un plus grand contrôle sur le comportement des modèles, et la couche applicative rend ce contrôle praticable. Mais retirer les garde-fous ne retire pas la responsabilité : il la transfère à la personne qui exécute le modèle.
Sources
- Arditi et al., Refusal in Language Models Is Mediated by a Single Direction — arXiv 2406.11717
- Dépôt et versions de Heretic — github.com/p-e-w/heretic
- Maxime Labonne, Uncensor any LLM with abliteration — blog Hugging Face
- Young, Comparative Analysis of LLM Abliteration Methods — arXiv 2512.13655 (résumé uniquement)
- Alice, One Pass to Break Them All (rapport 2026) — rapport PDF, recherche d'éditeur, non évaluée par des pairs
- WIRED, Tear Down Those Guardrails! (2026-11-10/11) — nous n'avons lu que des reprises et citons l'article tel que rapporté
- Abliter.cn — abliter.cn ; Abliteration.org — abliteration.org (le site a renvoyé une erreur d'accès ; miroir du README utilisé)
- Pages de tags Hugging Face — abliterated, uncensored, heretic
- Bibliothèque Ollama — ollama.com/library
- Règlement (UE) 2024/1689 (règlement sur l'IA), art. 2, par. 12, et art. 53 ; lignes directrices de la Commission pour les modèles d'IA à usage général (2025)
- Gemma Prohibited Use Policy et conditions ; licence Llama 3.1 et politique d'utilisation acceptable ; fiche du modèle Qwen3
- Documentation Hugging Face : Pickle Scanning et Malware Scanning ; OWASP Top 10 for LLM Applications
Questions fréquemment posées
Qu'est-ce qu'un modèle d'IA non censuré ?
Un modèle d'IA non censuré est un modèle de langage à poids ouverts dont les refus ont été réduits ou supprimés, par fine-tuning ou par modification de ses poids. Le résultat est rarement total : les tests publiés de modèles modifiés bien connus montrent encore des refus résiduels.
Quelle différence entre IA non censurée et IA abliterated ?
« Non censuré » décrit un résultat, moins de refus. « Abliterated » décrit une méthode, la modification des poids pour supprimer le comportement de refus. Un modèle abliterated est généralement moins restreint, mais « uncensored » dans un nom de modèle ne prouve rien sans résultat mesuré.
Quel est le meilleur LLM non censuré ?
Il n'y en a pas un seul. Pour les petites machines, les abliterations Gemma et Qwen de 4 à 9B tiennent dans environ 8 Go. Pour les GPU de 24 Go, des modèles de 24 à 31B comme Dolphin Mistral 24B ou l'abliteration Qwen3.8 27B conviennent. Vérifiez dans la fiche du modèle les preuves, la licence et l'activité récente, et testez-le sur vos propres tâches.
Les modèles d'IA non censurés sont-ils gratuits ?
Les poids sont généralement gratuits au téléchargement, sous des licences comme Apache-2.0 ou la licence communautaire Llama. Vous payez toujours le matériel et l'électricité, et certaines licences posent des conditions d'usage et de redistribution.
Où télécharger des modèles non censurés ?
Hugging Face est le principal hébergeur de poids et de fiches de modèles, et Ollama en distribue beaucoup sous forme de tags prêts à l'emploi. ModelScope est un hébergeur alternatif. Abliter.cn et Abliteration.org sont des index qui aident à découvrir des modèles mais n'hébergent pas les fichiers.
Puis-je exécuter une IA non censurée en local ?
Oui. Téléchargez un fichier GGUF ou un tag Ollama et exécutez-le dans Ollama, LM Studio ou llama.cpp. Un modèle de 7 à 9B demande environ 8 Go de mémoire, et un modèle de 24 à 31B environ 20 à 28 Go en Q4.
Qu'est-ce que Heretic ?
Heretic est un outil open source de Philipp Emanuel Weidmann qui recherche automatiquement les réglages supprimant les refus en modifiant le modèle le moins possible. La version 2.0, publiée le 2026-11-01, a fait de l'Arbitrary-Rank Ablation sa méthode par défaut.
L'abliteration supprime-t-elle tous les garde-fous de l'IA ?
Non. Elle cible le comportement de refus et ne garantit pas que tous les refus disparaissent. Les tests publiés montrent des refus résiduels, et la qualité peut baisser, notamment sur les benchmarks de véracité dans la recherche d'origine.
Les modèles non censurés sont-ils dangereux ?
Ils peuvent être détournés, et le risque croît quand un modèle est relié à des outils comme un shell, des fichiers ou le web. Dans une simple fenêtre de chat, il ne génère que du texte. Pour les agents, utilisez bac à sable, moindre privilège, validation humaine et journalisation.
Est-il légal d'utiliser une IA non censurée en Europe ?
Cela dépend de la possession, de la distribution et de l'usage. Posséder un modèle diffère de l'utiliser pour commettre une infraction. Le règlement européen sur l'IA oblige principalement les fournisseurs, et des licences comme celle de Llama ajoutent des limites contractuelles. Ceci n'est pas un avis juridique ; consultez un avocat pour votre cas.
Quelles applications locales peuvent utiliser des modèles non censurés ?
Toute application qui vous laisse choisir le modèle, dont LM Studio, Open WebUI, SillyTavern, AnythingLLM, Msty, KoboldCpp, Cline et n8n via des connexions Ollama ou compatibles OpenAI. Vérifiez que la version que vous utilisez accepte les modèles personnalisés.