Kurzfakten
- Grundlagenpaper: Arditi et al., „Refusal in Language Models Is Mediated by a Single Direction“ (arXiv 2406.11717, 2024), 13 Chat-Modelle von 1,8B bis 72B Parametern.
- Heretic: erstellt von Philipp Emanuel Weidmann (p-e-w); 2.0.0 veröffentlicht am 2026-11-01, 2.1.0 am 2026-11-08; nutzt Optuna zur Parametersuche und bewertet Ablehnungen und KL-Divergenz.
- Tag-Zahlen auf Hugging Face (2026-11-13): abliterated 13.279; uncensored 16.629; heretic 7.058 Repositories, einschließlich Quants und Duplikaten.
- Typische Größen (Q4_K_M GGUF): 8B etwa 5 GB; 12B etwa 7,6 GB; 24B etwa 14 GB; 27B etwa 16,6 GB; 31B etwa 18,7 GB.
- Speicherschätzung: Ein 31B-Q4-Modell braucht grob 22-24 GB VRAM oder 32 GB RAM; das sind Schätzungen, keine Messwerte.
- Risikoärmere Dateiformate: Bevorzugen Sie safetensors und GGUF gegenüber pickle-basierten .bin-, .pt- oder .ckpt-Dateien.
Was sind uncensored KI-Modelle?
Zwei Personen laden dasselbe Open-Weight-Modell herunter. Die erste stellt eine Grenzfrage und bekommt eine höfliche Ablehnung. Die zweite hat eine modifizierte Kopie desselben Basismodells geladen, stellt dieselbe Frage und bekommt eine Antwort. Gleiche Architektur, gleiches Wissen, anderes Verhalten. Diese Lücke ist die ganze Geschichte der uncensored KI.
Möglich ist das, weil Open-Weight-Modelle Dateien sind. Ein gehosteter Chatbot behält Gewichte, System-Prompt und Filter auf fremden Servern, sodass Sie nur mit ihm sprechen können. Ein Open-Weight-Modell gibt Ihnen die Gewichte. Jeder kann sie per Fine-Tuning anpassen, mergen, quantisieren oder bearbeiten und das Ergebnis veröffentlichen. Ablehnungsverhalten ist etwas, das das Modell gelernt hat, also lässt es sich verlernen oder unterdrücken.
Lokale KI macht das praktikabel. Ein 12B- oder 24B-Modell läuft heute offline auf einem Laptop oder einer einzelnen GPU, in Apps, denen Sie bereits vertrauen. Die Tag-Seiten von Hugging Face listeten am 2026-11-13 13.279 Repositories mit dem Tag abliterated, 16.629 mit uncensored und 7.058 mit heretic, wobei diese Zahlen Quantisierungen und Duplikate enthalten. Außerdem gibt es zwei spezialisierte Indizes: abliter.cn zeigte 921 Modelle aus 25.796 durchsuchten Repositories, und abliteration.org beschreibt einen Katalog von mehr als 19.000 Modellen. Sie nutzen unterschiedliche Aufnahmeregeln, die Zahlen beschreiben also nicht dasselbe.
Das Thema ist auch in den Nachrichten. Heretic 2.0 erschien am 2026-11-01 und löste die klassische Ein-Richtungs-Technik als Standard des Tools ab. WIRED veröffentlichte am 2026-11-10 ein Porträt der Community (wir konnten nur Reposts lesen und zitieren es daher als berichtet). Ein modifiziertes Gemma-4-31B-Modell, veröffentlicht am 2026-11-05, behauptet einen starken Rückgang der Ablehnungen; seine Zahlen prüfen wir weiter unten.
Dieser Leitfaden beginnt mit dem Phänomen und erklärt dann Begriffe, Forschung und Werkzeuge. Ein Gedanke zieht sich durch: Betrachten Sie diese Modelle als austauschbare Komponente in lokalen Apps. Die App liefert Dokumente, Sprache, Agenten und eine nutzbare Oberfläche; das Modell entscheidet, was es beantwortet. Die Kombination bietet eine Flexibilität, die kein gehosteter Dienst hat, und sie entfernt zugleich das Sicherheitsnetz, das ein gehosteter Dienst bietet.
📍 In einem Satz
Uncensored KI-Modelle sind Open-Weight-Sprachmodelle, die per Fine-Tuning oder durch Bearbeiten der Gewichte so verändert wurden, dass sie weniger Anfragen ablehnen als das Original.
💬 In einfachen Worten
Stellen Sie sich ein Modell als Datei vor, die Ihnen gehört. Jemand kann diese Datei so bearbeiten, dass sie häufiger Ja sagt, und Sie können die bearbeitete Datei in Ihren eigenen Apps ausführen.
Was bedeutet „uncensored“ wirklich?
Die Begriffe werden locker verwendet, und so laden Menschen etwas herunter, das sich nicht wie beworben verhält. Hier steht, was jeder Begriff technisch bedeutet.
📍 In einem Satz
„Uncensored“ beschreibt ein Ergebnis (weniger Ablehnungen), „abliterated“ eine Methode (Gewichtsbearbeitung); ein Modell kann also das eine sein, ohne das andere zu sein.
💬 In einfachen Worten
Uncensored ist, was man sich erhofft, abliterated ist, wie es gemacht wurde, und jailbroken ist ein Trick, den man bei einem unveränderten Modell anwendet.
Begriff | Bedeutung | Technische Garantie? |
|---|---|---|
| Uncensored | Weniger oder keine inhaltlichen Ablehnungen | Nein |
| Unfiltered | Weniger restriktive Ausgabefilterung | Nein |
| Unaligned | Reduziertes oder anderes Alignment-Training | Nein |
| Abliterated | Gewichte per Ablationstechnik bearbeitet | Nur die Methode |
| Jailbroken | Verhalten per Prompt umgangen | Nein, Gewichte unverändert |
| Unrestricted | Marketingbegriff | Nein |
Jailbreaking ist der Sonderfall: Es verändert den Prompt, nicht das Modell, sodass die nächste Unterhaltung sauber beginnt. Die anderen Begriffe beschreiben etwas, das mit den Gewichten gemacht wurde.
⚠️Warnung: Ein Modell mit „uncensored“ im Namen hat nicht zwingend seine Ablehnungen verloren. Prüfen Sie, ob die Model Card eine gemessene Ablehnungsrate nennt und wie sie gemessen wurde.
💡Tipp: Zwei verschiedene Dinge werden oft verwechselt: Ein steuerbares Modell (Hermes, Dolphin) lässt den System-Prompt das Verhalten bestimmen, während bei einem abliterierten Modell das Ablehnungsverhalten aus den Gewichten entfernt wurde.
Wie KI-Modelle lernen, Anfragen abzulehnen
Pretraining bringt einem Modell bei, Text aus einem riesigen Korpus vorherzusagen. Es entsteht ein leistungsfähiges, aber ungerichtetes System, das fast alles fortsetzt. Instruction Tuning und Supervised Fine-Tuning (SFT) trainieren es anschließend mit Beispielgesprächen, damit es Fragen in hilfreichem Format beantwortet.
Preference Training ergänzt die Sicherheitsschicht. Beim RLHF (Reinforcement Learning from Human Feedback) vergleichen menschliche Bewerter Antworten, ein Reward-Modell lernt ihre Präferenzen, und das Modell wird darauf optimiert. DPO (Direct Preference Optimization) erreicht ein ähnliches Ergebnis ohne separates Reward-Modell. Sicherheitsdatensätze stellen schädlichen Anfragen Ablehnungen gegenüber, sodass das Modell lernt, bestimmte Anfragetypen abzulehnen: das ist Refusal Training.
Wo sitzt das Verhalten? An zwei Stellen. Ein System-Prompt ist Text, der zur Laufzeit vorangestellt wird und den Sie ändern können. Verhalten in den Modellgewichten wird beim Training eingebrannt, und Sie können es nicht ändern, ohne die Gewichte anzufassen. Deshalb gelingt es mit einem System-Prompt allein manchmal nicht, ein Modell zum Antworten zu bringen, und deshalb können Gewichtsbearbeitungen es.
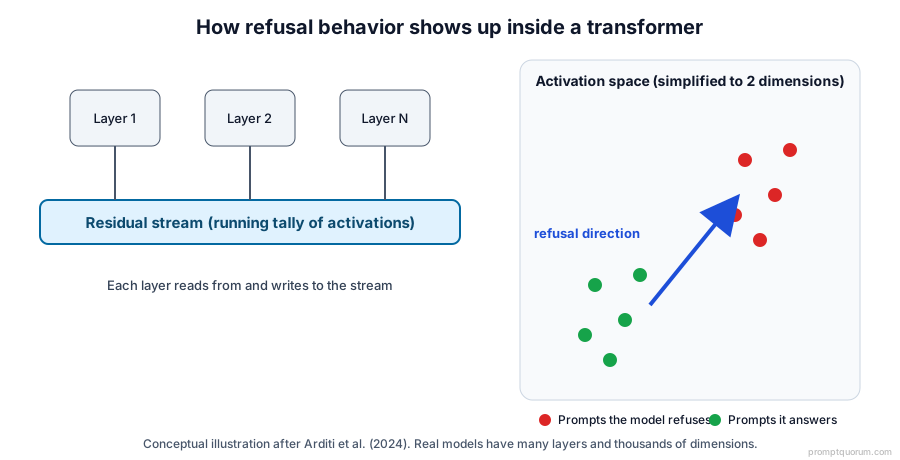
Das Diagramm zeigt die Idee, die Abliteration möglich macht. In einem Transformer liest und schreibt jede Schicht in eine gemeinsame laufende Summe, den Residual Stream. Die Forschung legt nahe, dass bei Ablehnungen ein großer Teil des Signals entlang einer Richtung in diesem Strom liegt.
Was ist Abliteration?
Die wissenschaftliche Grundlage ist Arditi et al. (2024), „Refusal in Language Models Is Mediated by a Single Direction“ (arXiv 2406.11717). Die Autoren testeten 13 offene Chat-Modelle zwischen 1,8B und 72B Parametern. Ihr Befund: Bei diesen Modellen wird Ablehnung von einer einzigen Richtung im Residual Stream vermittelt.
Wie die Richtung gefunden wird. Man lässt das Modell auf einer Menge schädlicher und einer Menge harmloser Prompts laufen, zeichnet die internen Aktivierungen an einer gewählten Schicht und Token-Position auf und bildet die Differenz der beiden Mittelwerte. Dieser Differenzvektor ist die Kandidatenrichtung für Ablehnung.
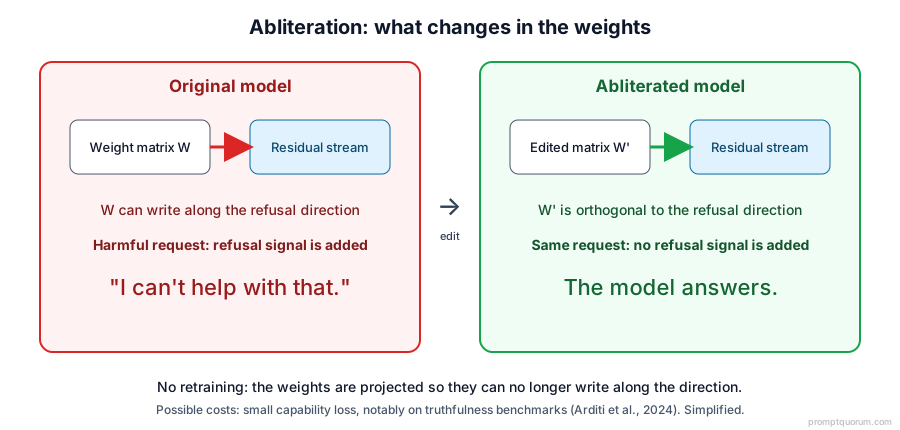
Wie sie entfernt wird. Directional Ablation projiziert diese Richtung zur Laufzeit aus den Aktivierungen heraus. Weight Orthogonalization erreicht denselben Effekt dauerhaft: Die Gewichtsmatrizen, die in den Residual Stream schreiben, werden so verändert, dass sie nicht mehr entlang der Richtung schreiben können. Das bearbeitete Modell braucht kein Neutraining, und seine Datei sieht aus wie jedes andere Modell.
Was verloren geht. Die Autoren berichten von kleinen Fähigkeitsverlusten bei den meisten Benchmarks, mit TruthfulQA als Ausnahme: Dort sank der Wert durchgängig um etwa 1 bis 3,5 Punkte. Außerdem bezeichnen sie ihre Methode zur Richtungsauswahl als heuristisch. Der praktische Leitfaden von Maxime Labonne stellte fest, dass Abliteration jeden von ihm gemessenen Benchmark senkte, dass ein DPO-„Healing“-Schritt das meiste, aber nicht alles zurückholte und dass die Wahl der Schicht Urteilsvermögen erfordert.
Ein Vorbehalt zu den Zahlen. Der Sicherheitsanbieter Alice veröffentlichte einen Bericht, der fünf Modelle testete und nach der Abliteration 98,0 % Befolgung (539 von 550 Prompts) gegenüber 5,8 % davor meldete, sowie einen Blogbeitrag mit 96-100 % über sechs Modellfamilien. Diese Zahlen stammen vom Unternehmen selbst, wurden von einem LLM-Judge bewertet, sind nicht peer-reviewed und messen die Bereitschaft zu antworten, nicht einen realen Fähigkeitszuwachs. Betrachten Sie sie als Datenpunkt, nicht als Beweis.
📍 In einem Satz
Abliteration schätzt aus Aktivierungsunterschieden eine Ablehnungsrichtung und bearbeitet die Gewichte so, dass das Modell nicht mehr entlang dieser Richtung schreiben kann.
💬 In einfachen Worten
Wenn Ablehnen ein Regler im Modell ist, findet Abliteration den Regler und entfernt ihn, ohne dem Modell etwas Neues beizubringen.
Heretic 2.0: Die nächste Generation der Abliteration
Wer und was. Heretic ist ein Open-Source-Kommandozeilenwerkzeug von Philipp Emanuel Weidmann (GitHub-Name p-e-w). Statt einen Menschen Schichten und Stärken wählen zu lassen, automatisiert es die Suche.
Der ursprüngliche Ansatz. Heretic nutzt Optuna, eine Bibliothek zur Hyperparameter-Optimierung mit TPE-Sampler, um viele Abliterations-Einstellungen auszuprobieren. Austauschbare Scorer bewerten jeden Versuch. Standardmäßig zählt es Ablehnungen mit einem Schlüsselwort-Scorer und misst die KL-Divergenz zum Originalmodell auf harmlosen Prompts, sodass die Suche Einstellungen findet, die Ablehnungen entfernen und alles andere möglichst wenig verändern. Modifier sind die Komponenten, die die Gewichte tatsächlich bearbeiten.
Was sich in 2.0 geändert hat. Version 2.0.0 erschien am 2026-11-01 (2.1.0 folgte am 2026-11-08). Der Standard-Modifier ist jetzt Arbitrary-Rank Ablation (ARA); die klassische Directional Ablation, mit den Optionen Projected Abliteration und Norm Preservation, bleibt verfügbar. Das Release ergänzt außerdem ein Plugin-System, Headless-Betrieb und einen BERT-basierten Ablehnungs-Scorer als Plugin (der Standard-Scorer bleibt schlüsselwortbasiert). Konfigurationsdateien von Heretic 1.x funktionieren mit 2.x nicht.
Was ARA ist. Laut dem eigenen Pull Request des Autors verwendet ARA keine Ablehnungsrichtungen. Es lernt mit einem L-BFGS-Optimierer Matrixbearbeitungen pro Modul gegen drei Ziele: Ausgaben für harmlose Prompts unverändert lassen, Ausgaben für schädliche Prompts denen für harmlose angleichen und sie von den alten schädlichen Ausgaben wegdrücken. Eine einzelne Richtung ist eine Rang-1-Bearbeitung; ARA erlaubt Bearbeitungen höheren Rangs und kann so Ablehnungsverhalten erfassen, das nicht eindimensional ist. Die vollständige Beschreibung wird weiterhin als Preprint „bald“ angekündigt, die Qualitätsaussagen stammen also vom Autor und sind nicht unabhängig geprüft.
Hardware und Kompromisse. Das Tool lädt das komplette Modell und führt viele Versuche durch, Sie brauchen also genug Speicher, um das zu modifizierende Modell auszuführen, sowie Zeit. Die Qualitätskompromisse folgen dem Muster anderer Methoden: Eine vergleichende Studie von vier Tools an 16 Modellen (Young, arXiv 2512.13655, Abstract gelesen) berichtet GSM8K-Änderungen von +1,5 bis -18,8 Punkten und Heretic-KL-Werte von 0,04 bis 1,65; die Ergebnisse hängen also stark vom Modell ab.
⚠️Warnung: Einige Details zu 2.0 stehen in Blogbeiträgen Dritter, die wir nicht mit dem Repository abgleichen konnten. Wir nennen nur, was das Repository, die Release Notes oder der Pull Request des Autors sagen, und kennzeichnen den Rest als berichtet.
Weitere Wege zu uncensored Modellen
Abliteration ist nicht der einzige Weg. Die Tabelle vergleicht die wichtigsten Ansätze. Die Zeile zum Merging ist bewusst vorsichtig: Wir haben keine Primärquelle gefunden, die Merges als Methode zum Entfernen von Ablehnungen dokumentiert.
Methode | Was sie ändert | Training nötig? | Hauptkompromiss |
|---|---|---|---|
| Uncensored Fine-Tuning | Gewichte, über neue Daten | Ja | Rechenaufwand, Datenqualität |
| Abliteration | Gewichte, eine Richtung | Nein | Etwas Fähigkeitsverlust |
| Automatisierte Abliteration | Gewichte, gesuchte Einstellungen | Nein | Versuchszeit und Speicher |
| Model Merging | Mischt mehrere Modelle | Nein | Für Ablehnungen unbelegt |
| Preference Optimization | Gewichte, über Präferenzen | Ja | Braucht gepaarte Daten |
Der bekannteste Fine-Tuning-Ansatz ist Eric Hartfords Dolphin-Linie, die Antworten im Ablehnungsstil aus den Trainingsdaten filtert und sich für das Verhalten auf den System-Prompt stützt. Fine-Tuning ist auch mit LoRA-Adaptern möglich, und veröffentlichte Forschung berichtet, dass sich Sicherheitstraining mit kleinen Mengen schädlichen Fine-Tunings rückgängig machen lässt (Qi et al., Lermen et al.). Neuere Varianten der Gewichtsbearbeitung wie Norm-Preserving Biprojected Abliteration versuchen, Kollateralschäden zu verringern, und DPO-„Healing“ dient dazu, nach einer Bearbeitung Qualität zurückzugewinnen.
Die wichtigsten Familien uncensored KI-Modelle
Dolphin (cognitivecomputations und die neuere Organisation dphn) ist die bekannteste feinabgestimmte Linie. Der aktuell geprüfte Eintrag ist Dolphin-Mistral-24B-Venice-Edition. Laut Model Card bestimmt der System-Prompt das Verhalten; das Modell ist also steuerbar und nicht garantiert ohne Ablehnungen.
Hermes (NousResearch) ist keine uncensored Familie. Hermes-4-Modelle sind neutral ausgerichtet und steuerbar. Nous’ eigener RefusalBench, wie auf der Hermes-4.3-36B-Karte berichtet, zeigt, dass das Modell etwa 72-75 % seiner Testprompts beantwortete; grob ein Viertel wird also weiterhin abgelehnt. Ordnen Sie nicht jedes Hermes-Modell als uncensored ein.
Abliterierte Qwen-Varianten dominieren die Downloads. Der meistgeladene geprüfte Eintrag ist Huihui-Qwen3.8-27B-abliterated mit etwa 4 Millionen Downloads. Suche: Qwen abliterated auf Hugging Face.
Abliterierte Gemma-Varianten sind der neueste Bereich. Modifizierte Gemma-4-Modelle gibt es mit einfacher Abliteration sowie mit Heretic und ARA. Suche: Gemma abliterated. Eines davon, ein Gemma-4-31B-ARA-Modell, behauptet eine starke Reduktion der Ablehnungen, die wir unten prüfen.
Abliterierte Llama-Varianten sind überwiegend älter. In unserer Prüfung vom 2026-11-13 hat nichts Neueres als Llama 3.1 und 3.3 große Download-Zahlen, und der meistgeladene 8B-Eintrag stammt von 2024. Suche: Llama abliterated.
Mistral, DeepSeek und GLM. Eine Abliteration von Mistral Small 3.2 24B existiert. Für DeepSeek und GLM gibt es abliterierte Versionen der neuesten Modelle, die jedoch etwa 284 GB und 321 GB groß sind und damit außerhalb von Consumer-Hardware liegen; praktikabel ist nur eine ältere DeepSeek-R1-Distillation mit 32B.
Ein kritischer Blick auf die Gemma-4-31B-Aussage. Die Model Card berichtet, dass die Ablehnungen von 99 von 100 Prompts auf 28 von 100 sanken (Heretic v2.0.0 ARA, KL-Divergenz 0,0845). Das ist eine relative Reduktion um 72 %, und es bedeutet auch, dass 28 von 100 Testprompts den Detektor weiterhin auslösten. Der Detektor ist eine Liste von etwa 34 Schlüsselwörtern wie „sorry“ und „illegal“, angewandt auf 100 Token gekürzte Antworten; eine hilfreiche Antwort mit Hinweis zählt also als Ablehnung, und eine Nicht-Antwort ohne diese Wörter als Befolgung. Der Testsatz besteht aus 100 Prompts eines einzigen Datensatzes, das Original erreichte 99/100, und der KL-Wert wird nur auf harmlosen Prompts gemessen und sagt daher nichts über die Fähigkeiten. Die Karte verspricht Reproduzierbarkeit, doch ihre eigene Reproduktionsdatei warnt, dass ein nicht committeter lokaler Heretic-Build verwendet wurde. Eine unabhängige Auswertung haben wir nicht gefunden. Ein anderes 31B-Repack auf derselben Basis berichtet 10/100 bei KL 0,054, doch Ergebnisse verschiedener Autoren, Läufe und Einstellungen sind nicht vergleichbar.
💡Tipp: Lesen Sie Ablehnungszahlen wie Benchmark-Zahlen: Fragen Sie, was als Ablehnung zählte, wie viele Prompts getestet wurden, wie lang die Antwort sein durfte und wer den Test durchgeführt hat.
Wo können Sie uncensored KI-Modelle herunterladen?
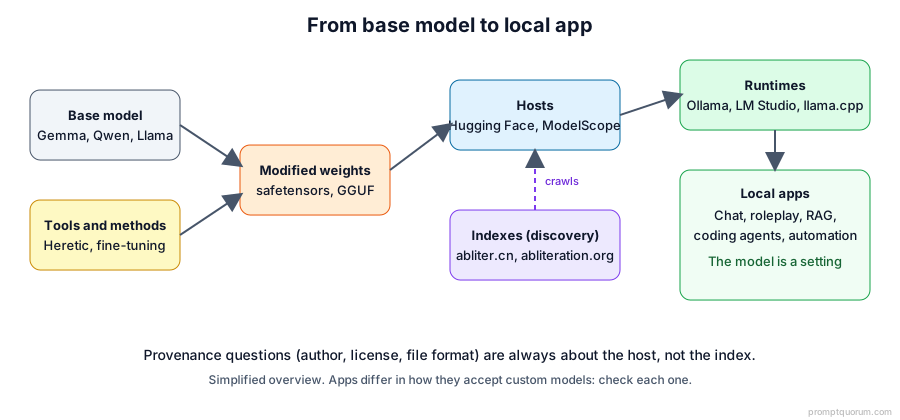
Eine Hosting-Plattform speichert und liefert die Dateien selbst. Ein spezialisierter Index durchsucht nur Hosting-Plattformen und ergänzt eine Ebene zur Entdeckung. Ein Index kann beim Finden von Kandidaten helfen, doch die heruntergeladene Datei stammt weiterhin vom Host; Fragen der Herkunft betreffen daher immer den Host und den Autor.
Plattform | Rolle | Website |
|---|---|---|
| Hugging Face | Gewichte und Model Cards | huggingface.co |
| Ollama | Lokal ausführen und verteilen | ollama.com |
| ModelScope | Alternatives Repository | modelscope.cn |
| GitHub | Tools und Quellcode | github.com |
| Abliter.cn | Index zur Modellsuche | abliter.cn |
| Abliteration.org | Katalog und Analysen | abliteration.org |
Prüfen Sie vor dem Start. Bevorzugen Sie safetensors- und GGUF-Dateien. Pickle-basierte Formate (.bin, .pt, .pkl, .ckpt) können beim Laden Code ausführen, und die Hugging-Face-Dokumentation empfiehlt vertrauenswürdige Autoren und safetensors. Aktivieren Sie trust_remote_code nie bei einem unbekannten Repository. Prüfen Sie, dass die Model Card Basismodell und Methode nennt und dass die Kette der Basismodelle zum offiziellen Repository führt, vergleichen Sie Datei-Hashes, wo der Autor sie veröffentlicht, und lesen Sie die Lizenz. Hugging Face führt einen Malware-Scan für Repository-Dateien unter 2 GB durch, große Gewichtsdateien können also außerhalb liegen (unsere Lesart der Dokumentation). Quantisierte Kopien seriöser Quantisierer bürgen für das Dateiformat, nicht für die Aussagen des ursprünglichen Autors. Ollama-Namespaces wie huihui_ai und richardyoung sind Uploads von Nutzern, keine von der Library geprüften Modelle.
Welche uncensored Modelle lohnen sich?
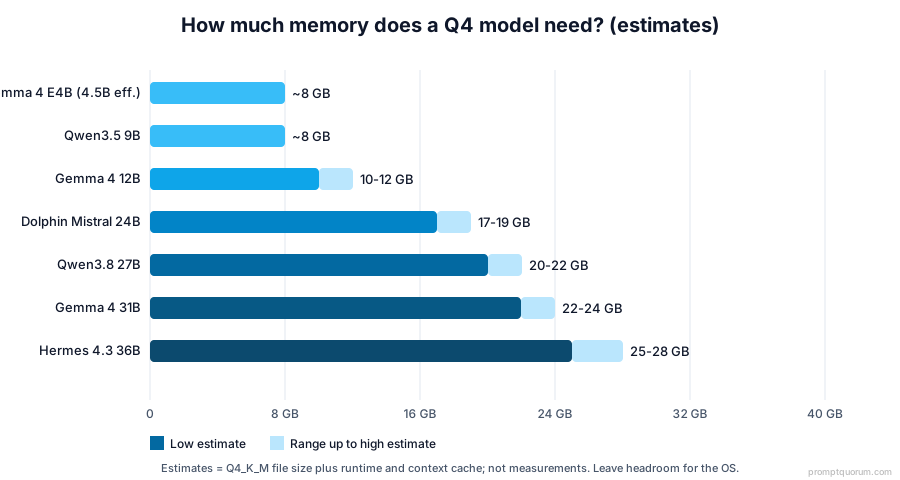
Wir haben am 2026-11-13 zehn aktuelle Repositories gegen die Hugging-Face-API und die Model Cards geprüft, nicht gegen ältere Artikel. Größen sind Q4_K_M-GGUF-Dateigrößen, sofern ein Repository sie veröffentlicht; Speicherangaben sind unsere Schätzungen (Dateigröße plus Runtime und Cache), keine Messwerte. Download-Zahlen und Daten ändern sich ständig; diese Tabelle ist daher eine Momentaufnahme und sollte unabhängig vom Artikel aktualisiert werden.
Gemma 4 31B ARA Heretic
- Basis:
- Gemma 4 31B-it
- Methode:
- Heretic 2.0 ARA
- Parameter:
- 30,7B
- Q4-Größe:
- 18,7 GB
- Speicher (gesch.):
- 22-24 GB VRAM
- Kontext:
- 262K
- Lizenz:
- Apache-2.0
- Bekannte Grenzen:
- Kein unabhängiger Test gefunden
Gemma 4 E4B Heretic
- Basis:
- Gemma 4 E4B-it
- Methode:
- Heretic ARA
- Parameter:
- 4,5B eff.
- Q4-Größe:
- 5,3 GB
- Speicher (gesch.):
- ~8 GB
- Kontext:
- 131K
- Lizenz:
- Apache-2.0
- Bekannte Grenzen:
- Eigene Tests des Repackagers
Huihui Gemma 4 12B
- Basis:
- Gemma 4 12B-it
- Methode:
- Abliteration
- Parameter:
- 12,0B
- Q4-Größe:
- 7,6 GB
- Speicher (gesch.):
- 10-12 GB
- Kontext:
- 128-256K
- Lizenz:
- Apache-2.0
- Bekannte Grenzen:
- Karte: „Proof of Concept“
Huihui Qwen3.8 27B
- Basis:
- Qwen3.8 27B
- Methode:
- Abliteration
- Parameter:
- 27,3B
- Q4-Größe:
- 16,6 GB
- Speicher (gesch.):
- 20-22 GB
- Kontext:
- 262K
- Lizenz:
- Apache-2.0
- Bekannte Grenzen:
- Kann Hinweise anfügen
Huihui Qwen3.5 9B
- Basis:
- Qwen3.5 9B
- Methode:
- Abliteration
- Parameter:
- 9,7B
- Q4-Größe:
- 5,6 GB
- Speicher (gesch.):
- ~8 GB
- Kontext:
- 262K
- Lizenz:
- Apache-2.0
- Bekannte Grenzen:
- Keine Ablehnungsdaten auf Karte
Dolphin Mistral 24B Venice
- Basis:
- Mistral Small 24B
- Methode:
- Fine-Tune
- Parameter:
- 24,0B
- Q4-Größe:
- 14,3 GB
- Speicher (gesch.):
- 17-19 GB
- Kontext:
- 131K
- Lizenz:
- Apache-2.0
- Bekannte Grenzen:
- Prompt bestimmt Verhalten
Hermes 4.3 36B
- Basis:
- Seed-OSS 36B
- Methode:
- Post-Training
- Parameter:
- 36,2B
- Q4-Größe:
- 21,8 GB
- Speicher (gesch.):
- 25-28 GB
- Kontext:
- 524K
- Lizenz:
- Apache-2.0
- Bekannte Grenzen:
- Nicht uncensored
Hermes 4 14B
- Basis:
- Qwen3 14B
- Methode:
- Post-Training
- Parameter:
- 14,8B
- Q4-Größe:
- 9,0 GB
- Speicher (gesch.):
- 11-12 GB
- Kontext:
- 41K
- Lizenz:
- Apache-2.0
- Bekannte Grenzen:
- Nicht uncensored
Llama 3.1 8B abliterated
- Basis:
- Llama 3.1 8B
- Methode:
- Abliteration
- Parameter:
- 8,0B
- Q4-Größe:
- 4,9 GB
- Speicher (gesch.):
- 7-8 GB
- Kontext:
- 131K
- Lizenz:
- Llama-3.1-Bedingungen
- Bekannte Grenzen:
- Von 2024
R1 Distill Qwen 32B
- Basis:
- R1-Distill-Qwen-32B
- Methode:
- Abliteration
- Parameter:
- 32,8B
- Q4-Größe:
- 19,9 GB
- Speicher (gesch.):
- 23-26 GB
- Kontext:
- 131K
- Lizenz:
- Nicht getaggt
- Bekannte Grenzen:
- Von 2025, kein Lizenz-Tag
So lesen Sie die Tabelle. Die Abliteration von Qwen3.8 27B hat mit Abstand die meisten Downloads (etwa 4 Millionen), doch ihre Karte sagt, dass die Ausgabe weiterhin einen kleinen Warnhinweis enthalten kann, eine Erinnerung daran, dass „abliterated“ nicht „beantwortet alles“ bedeutet. Für kleine Rechner passen die Einträge Gemma 4 E4B und Qwen3.5 9B in etwa 8 GB. Für einige gibt es geprüfte Ollama-Tags: ollama run huihui_ai/gemma-4-abliterated:12b, ollama run huihui_ai/qwen3.5-abliterated:9b und huihui_ai/Qwen3.8-abliterated (etwa 18 GB); das Gemma-4-31B-Modell hat eine Ollama-Seite unter dem Namespace des Autors. Hermes 4.3 36B steht in der Liste, damit Sie ein steuerbares, neutral ausgerichtetes Modell neben den modifizierten sehen: Nous’ eigener Benchmark lässt etwa ein Viertel der Prompts abgelehnt. Die Llama-3.1-Bedingungen verlangen einen Hinweis „Built with Llama“ und das Präfix „Llama“ in den Namen abgeleiteter Modelle, und die R1-Distillation hat kein Lizenz-Tag; nehmen Sie also keine an. Eine Abliteration von Mistral Small 3.2 (24B) und eine von Llama 3.3 70B (etwa 42,5 GB bei Q4, für Rechner der 64-GB-Klasse) existieren ebenfalls, sind aber veraltet.
Uncensored Modelle in lokalen Apps nutzen
Der Grund, warum das wichtig ist, ist die Architektur lokaler KI. Die meisten lokalen Apps liefern kein festes Modell mit. Sie verbinden sich mit einem Backend, meist Ollama, llama.cpp oder einem OpenAI-kompatiblen Server, oder laden GGUF-Dateien Ihrer Wahl.
Unsere eigenen Reviews bestätigen das Muster über Kategorien hinweg. SillyTavern verbindet sich mit KoboldCpp, text-generation-webui, Ollama oder LM Studio. Open WebUI setzt als Frontend vor Ollama oder jede OpenAI-kompatible API. LM Studio führt GGUF-Modelle mit eingebautem Hugging-Face-Browser aus. AnythingLLM, Msty und Cline verbinden sich mit Ollama oder LM Studio. n8n hat einen eigenen Ollama-Node, und KoboldCpp führt GGUF-Dateien direkt aus. Wenn das Modell eine Einstellung ist, können Sie pro Aufgabe ein neutrales Modell gegen ein uneingeschränktes tauschen.
Was Sie gewinnen. Sie erhalten die Funktionen der App und das Modell Ihrer Wahl, offline und ohne dass ein gehosteter Anbieter die Unterhaltung mitliest. Die Tabelle zeigt, wie sich das je Kategorie auswirkt. Prüfen Sie, ob die von Ihnen genutzte Version einer App eigene Modelle akzeptiert, bevor Sie sich darauf verlassen; diese Liste ist ein Ausgangspunkt, keine Garantie.
📍 In einem Satz
Da die meisten lokalen Apps das Modell als austauschbare Einstellung behandeln, ändert die Kombination mit einem uneingeschränkten Modell, was die ganze App tut, ohne die App zu ändern.
💬 In einfachen Worten
Die App ist das Auto und das Modell der Fahrer: Setzen Sie einen Fahrer ein, der häufiger Ja sagt, und dasselbe Auto fährt an Orte, die vorher nicht möglich waren.
App-Kategorie | Beispiel-Apps | Nutzen freier Modelle |
|---|---|---|
| Chat-Clients | LM Studio, Msty, Open WebUI | Weniger abgelehnte Fragen |
| Rollenspiel und Fiktion | SillyTavern, KoboldCpp | Dunkle Themen, keine Szenenabbrüche |
| Dokumenten-RAG | AnythingLLM, Open WebUI | Inferenz bleibt auf Ihrem Gerät |
| Coding-Agenten | Cline, Aider, Continue | Code-Hilfe für Sicherheitstests |
| Automatisierung | n8n mit Ollama-Node | Eigene Pipelines, eigene Richtlinienebene |
| Persönliche Agenten | Hermes Agent, nanobot | Mehr Autonomie, braucht Schutz |
Konkrete Beispiele für die zusätzliche Flexibilität. Eine Romanautorin kann hinter SillyTavern ein abliteriertes oder steuerbares Modell für moralisch komplexe Fiktion ohne Abbrüche mitten in der Szene betreiben; das behandelt unser Leitfaden zum kreativen Schreiben ausführlich. Ein Anwalt, eine Journalistin oder ein Forscher kann AnythingLLM auf einen Ordner mit sensiblen Dokumenten richten und Fragen zu Inhalten stellen, die ein gehostetes Modell womöglich ablehnen würde, wobei die Inferenz auf Ihrem Rechner läuft. Prüfen Sie bei jeder App die Telemetrie- und Update-Einstellungen, denn Apps und Modell-Downloads können dennoch das Netzwerk nutzen. Eine Sicherheitsfachkraft kann in einer autorisierten Testumgebung einen Coding-Agenten mit einem Modell nutzen, das bei exploitnahen Fragen nicht zurückschreckt. Ein Entwickler kann einen n8n-Workflow bauen, dessen Modell eine Einstellung ist, und es ändern, ohne etwas umzuschreiben. Ein Power-User kann zwei Modelle in einer App betreiben, ein neutrales für den Alltag und ein uneingeschränktes für Aufgaben, die das erste ablehnt.
⚠️Warnung: Die Flexibilität hat einen Preis. In einem Chatfenster erzeugt ein uneingeschränktes Modell nur Text. Ist dasselbe Modell mit einem Agenten mit Datei-, Shell- oder Webzugriff verbunden, kann es auf das reagieren, was es erzeugt. Kombinieren Sie solche Setups mit Sandboxing, minimalen Rechten und menschlicher Freigabe.
💡Tipp: Sie wissen nicht, welche App Ihr Modell laden kann oder zu Ihrer Hardware passt? Filtern Sie das Verzeichnis für lokale LLM-Software nach Anwendungsfall, Betriebssystem und RAM, oder beschreiben Sie Ihren Rechner bei Ask Hans.
So betreiben Sie uncensored KI lokal
Ollama (ollama.com) ist der einfachste Weg für Kommandozeilen-Nutzer: Sie laden ein Modell per Name, und es stellt eine API bereit, die viele Apps verstehen. LM Studio (lmstudio.ai) ist der grafische Weg, mit eingebautem Hugging-Face-Browser und lokalem OpenAI-kompatiblem Server. llama.cpp (github.com/ggml-org/llama.cpp) ist die Engine unter vielen dieser Tools und führt GGUF-Dateien direkt aus. Transformers (huggingface.co/docs/transformers) lädt safetensors-Gewichte in voller Präzision in Python, was zu Forschung passt und zu allen, die Modelle auswerten oder verändern wollen.
GGUF und Quantisierung. GGUF ist das Einzeldatei-Format der llama.cpp-basierten Tools. Quantisierung speichert Gewichte mit weniger Bits: Q4_K_M ist der übliche Kompromiss und ergibt grob ein Viertel der Größe in voller Präzision bei mäßigem Qualitätsverlust. Niedrigere Quants sparen Speicher, können aber Schlussfolgern und Befolgen von Anweisungen beeinträchtigen; testen Sie daher die konkrete Datei, die Sie nutzen.
Hardware. Bei Apple Silicon teilen sich CPU und GPU den Unified Memory, sodass ein Mac mit 32 GB ein Q4-Modell mit rund 24-27B Parametern plus Kontext aufnehmen kann; lassen Sie einige Gigabyte für das System frei. Bei NVIDIA-GPUs sollte das Modell in den VRAM passen: Eine Karte mit 24 GB eignet sich für die oben genannten Modelle mit 24-31B, 8 GB für Modelle mit 4-9B. Passt das Modell nicht, lagern Schichten in den Arbeitsspeicher aus, und die Geschwindigkeit sinkt stark. Genaue Zahlen finden Sie unter wie viel VRAM ein lokales LLM braucht.
Offline-Betrieb. Sobald die Gewichte auf der Festplatte liegen, braucht keines dieser Tools Internet, um Text zu erzeugen. Das ist das wichtigste Datenschutzargument und auch der Grund, warum kein Anbieter Nutzungsregeln für eine lokale Kopie durchsetzen kann.
Können Sie ein eigenes abliteriertes Modell erstellen?
Konzeptionell ja, und es ist zugänglicher als früher. Wir beschreiben den Ablauf nur auf hoher Ebene.
- 1Ein Open-Weight-Modell auswählen
Why it matters: Wählen Sie eines, dessen Größe zu Ihrem Speicher passt, denn das Tool muss es laden. - 2Die Lizenz prüfen
Why it matters: Manche Lizenzen und Nutzungsrichtlinien schränken das Umgehen von Sicherheitsfiltern ein (die früheren Gemma-Bedingungen taten es); lesen Sie die Lizenz des jeweiligen Basismodells, bevor Sie ändern oder weiterverbreiten. - 3Die Architekturkompatibilität prüfen
Why it matters: Tools unterstützen bestimmte Architekturen; ein neues Modell funktioniert womöglich noch nicht. - 4Eine Methode wählen
Why it matters: Klassische Directional Ablation oder ein automatisiertes Tool wie Heretic mit ARA. - 5Die Modifikation ausführen
Why it matters: Automatisierte Tools durchsuchen viele Einstellungen; klassische Methoden hängen von Ihrer Schichtwahl ab. - 6Das Ergebnis auswerten
Why it matters: Messen Sie Ablehnungen und Qualitätsverlust an Prompts, auf die das Tool nicht abgestimmt wurde. - 7Mit dem Original vergleichen
Why it matters: Die Leistungsfähigkeit kann sinken, selbst wenn die Ablehnungen zurückgehen. - 8Verantwortungsvoll dokumentieren und veröffentlichen
Why it matters: Nennen Sie Methode, Zahlen, Basismodell und Lizenzkette.
Welche Risiken hat uncensored KI?
Wir beschreiben die Risiken nur so weit, wie zum Verständnis nötig, und nennen keine operativen Details.
- Hilfe bei Cyberkriminalität und Malware. Ein Modell mit weniger Ablehnungen senkt den Aufwand, Hilfe beim Schreiben von Schadcode zu bekommen. Ob es Fähigkeiten über das ohnehin Verfügbare hinaus liefert, ist umstritten.
- Phishing und Betrug. Flüssige, personalisierte Betrugstexte sind für jedes leistungsfähige Modell einfach; Ablehnungen waren eine Hürde, und sie ist hier schwächer.
- Gefährliche biologische und chemische Informationen. Das ist das folgenreichste Anliegen der politischen Debatte. Berichtete Ablehnungsraten messen die Bereitschaft zu antworten, nicht den realen Fähigkeitszuwachs, sie sind also weder Beweis für Gefahr noch für Sicherheit.
- Missbrauch im Waffenkontext. Es gilt dieselbe Vorsicht: Gemessene Befolgung ist keine nachgewiesene Fähigkeit.
- Belästigung und missbräuchliche Inhalte. Lokale Modelle können missbräuchliches Material in großem Umfang erzeugen. Darstellungen sexuellen Kindesmissbrauchs sind in den uns bekannten Rechtsordnungen strafbar. In Deutschland erfasst § 184b StGB auch realistische Darstellungen; gehen Sie daher davon aus, dass auch realistisches KI-erzeugtes Material strafbar sein kann. Erzeugen, erbitten oder speichern Sie es nicht.
- Desinformation. Weniger Ablehnungen bedeuten auch weniger Hürden für überzeugende Falschinhalte.
- Datenschutz und Datensicherheit. Lokale Inferenz hält Ihre Prompts auf Ihrem Rechner, doch Downloads sind ein eigenes Risiko: Unbekannte Repositories können schädliche Dateien enthalten, und Apps können weiterhin Netzwerkverbindungen aufbauen.
- Schädliche Modelldateien. Pickle-basierte Formate können beim Laden Code ausführen, und Scans bieten keine Garantie (siehe die Hugging-Face-Dokumentation zum Pickle-Scanning). Nutzen Sie safetensors oder GGUF von bekannten Autoren.
- Autonome Agenten mit Tool-Zugriff. Das ist die größte Verschiebung: Ein uneingeschränktes Modell mit Zugriff auf Dateien, eine Shell oder das Web kann handeln. OWASP führt Prompt Injection (LLM01) und Excessive Agency (LLM06) unter den Top-Risiken für LLM-Anwendungen.
Warum sind manche Menschen gegen KI-Guardrails?
Die stärksten Argumente für weniger restriktive Modelle verdienen eine faire Darstellung.
- Meinungsfreiheit. Befürworter argumentieren, ein Werkzeug solle nicht entscheiden, was ein Erwachsener lesen oder schreiben darf.
- Wissenschaftliche Forschung. Das Untersuchen von Modellverhalten, einschließlich Ablehnungen, erfordert Modelle, die sich verändern lassen; die Abliterations-Forschung selbst beruht auf offenen Gewichten.
- Sicherheitstests. Red Teams brauchen Modelle, die über Angriffe sprechen, um Abwehrmaßnahmen zu testen.
- Kreatives Schreiben. Fiktion braucht Schurken, Gewalt und moralische Komplexität, die übervorsichtige Modelle glätten können.
- Nutzerautonomie. Manche argumentieren, der Nutzer und nicht der Hersteller solle die Grenzen eines lokalen Werkzeugs setzen.
- Datenschutz und lokale Ausführung. Sensibles Material wird auf Ihrem Rechner verarbeitet, sodass kein gehosteter Anbieter den Prompt erhält; prüfen Sie die Telemetrie-Einstellungen jeder App.
- Übermäßige Einschränkungen vermeiden. Kritiker kommerzieller Modelle verweisen auf Ablehnungen harmloser Fragen. Eric Hartfords Essay über uncensored Modelle bringt dieses Argument vor.
Warum sind KI-Schutzmechanismen wichtig?
Die Gegenargumente sind ebenso real. Schutzmechanismen senken die Wahrscheinlichkeit, dass ein Modell bei ernsthaftem Schaden hilft, schützen verletzliche Nutzer und machen den Einsatz in Produkten vertretbar.
Der entscheidende Unterschied liegt zwischen einem Modell, das Text erzeugt, und einem Agenten, der Befehle ausführen, Dateien lesen, im Web browsen oder mit anderen Systemen interagieren kann. Schreibt ein Chat-Modell etwas Schädliches, muss immer noch ein Mensch danach handeln. Handelt ein Agent mit demselben Modell, schließt sich die Lücke zwischen Ausgabe und Folge.
Schutzmechanismen in offenen Modellen lassen sich kaum manipulationssicher machen: Die oben beschriebene Abliterations-Forschung zeigt, dass eine einzige Gewichtsbearbeitung das Ablehnungsverhalten unterdrücken kann. Das ist ein zentrales Argument für stärkere Schutzmaßnahmen auf Modellebene und für externe Kontrollen um das Modell herum.
Können Sie eigene Schutzmechanismen bauen?
Ja. Da ein lokales Modell keine Schicht auf Anbieterseite hat, ergänzen Sie Ihre eigene darum herum.
- Moderationsschichten. Lassen Sie einen Klassifikator wie Llama Guard oder ShieldGemma auf Ein- und Ausgaben laufen.
- Ein- und Ausgabefilter. Blockieren oder prüfen Sie Kategorien, die Sie in Ihrem Workflow nicht wollen.
- Sandboxing. Führen Sie Agenten in Containern oder virtuellen Maschinen ohne Zugriff auf irgendetwas aus, das Sie nicht verlieren können.
- Berechtigungsbeschränkungen. Geben Sie Agenten die minimal nötigen Rechte: schreibgeschützte Ordner, kein Netzwerk, keine Shell, wenn sie nicht erforderlich ist.
- Menschliche Freigabe. Verlangen Sie eine Bestätigung, bevor ein Agent Dateien schreibt, Befehle ausführt oder Nachrichten sendet.
- Protokollierung und Überwachung. Halten Sie fest, was der Agent getan hat und warum.
- Agentensicherheit. Behandeln Sie jedes Dokument, jede Webseite und jede E-Mail, die der Agent liest, als nicht vertrauenswürdige Eingabe, die Anweisungen enthalten kann (Prompt Injection).
Ist es legal, uncensored KI-Modelle herunterzuladen und zu nutzen?
Es gibt keine einheitliche Antwort, und dies ist keine Rechtsberatung. Zu trennen sind Besitz, Verbreitung und Nutzung, und die Antwort kann je nach Land und Verwendungszweck des Modells abweichen.
EU AI Act. Die Verordnung (EU) 2024/1689 legt Anbietern von KI-Modellen mit allgemeinem Verwendungszweck Pflichten auf, mit einer teilweisen Ausnahme für Open-Source-Modelle, die nicht für Modelle mit systemischem Risiko gilt. Die Pflichten für KI-Modelle mit allgemeinem Verwendungszweck gelten ab 2025-08-02, die Durchsetzungsbefugnisse der Kommission ab 2026-08-02. Die Leitlinien der Kommission von 2025 besagen, dass ein nachgelagerter Modifizierer erst oberhalb einer indikativen Rechenschwelle zum Anbieter wird; wir lesen Abliteration als weit darunter, doch das Kriterium ist unverbindlich. Wir konnten dem Text nicht entnehmen, ob der Digital Omnibus von 2026 die Fristen für KI mit allgemeinem Verwendungszweck geändert hat; prüfen Sie daher den aktuellen Text.
Besitz oder Nutzung. Eine Modelldatei zu besitzen ist etwas anderes, als sie zur Begehung einer Straftat zu nutzen. Das Strafrecht knüpft an bestimmte Handlungen an: Herstellung verbotener Inhalte, Betrug, Belästigung oder Werkzeuge, die für Computerkriminalität gedacht sind. Deutsche Vorschriften haben wir nur teilweise geprüft; verlassen Sie sich dafür nicht auf diesen Leitfaden.
Lizenzen und Verträge. Lizenzen fügen dem Gesetz Regeln hinzu. Die Gemma-4-Model-Cards nennen Apache-2.0 und verlinken eine Gemma-4-Lizenzseite, während frühere Gemma-Generationen die Gemma Terms und die Prohibited Use Policy nutzten, die das Umgehen von Sicherheitsfiltern verbieten; prüfen Sie die Lizenzseite des jeweiligen Basismodells. Die Llama-3.1-Lizenz verlangt einen Hinweis „Built with Llama“ und ein Namenspräfix für Ableitungen; ihre Acceptable Use Policy beschränkt Verwendungen, enthält aber nach unserer Lesart keine ausdrückliche Klausel gegen Umgehung. Die in der Tabelle aufgeführten Karten von Qwen3.5 und Qwen3.8 zeigen Apache-2.0. Lesen Sie immer die Lizenz des Basismodells, nicht nur die der Ableitung.
Datenschutz und Urheberrecht. Die lokale Verarbeitung personenbezogener Daten unterliegt weiterhin dem Datenschutzrecht, und urheberrechtliche Fragen zu den Trainingsdaten der zugrunde liegenden Modelle sind ungeklärt. Beides ändert sich nicht, wenn Ablehnungen entfernt werden.
Wird uncensored KI ein fester Bestandteil des KI-Ökosystems?
Mehrere Trends sprechen dafür. Die Modifikation durch die Community ist groß und wächst: Die oben genannten Tag-Zahlen auf Hugging Face gehen in die Tausende von Repositories. Die Werkzeuge werden automatischer: Heretic durchsucht Einstellungen für Sie, und ARA geht über eine einzelne Richtung hinaus. Neue Techniken zum Entfernen von Ablehnungen werden weiter erscheinen, ebenso Techniken, die Schutzmechanismen schwerer entfernbar machen.
Andere Entwicklungen wirken in unterschiedliche Richtungen: konfigurierbare Sicherheitsarchitekturen, die Betreibern die Wahl einer Policy lassen, kommerzielle Dienste mit weniger restriktiven Modellen, lokale KI, die die Kontrolle zunehmend beim Nutzer belässt, und eine Regulierung, die noch im Entstehen ist. Rechnen Sie mit anhaltendem Streit darüber, ob offene Gewichte je manipulationssicher werden können.
Fazit. Open-Weight-KI gibt Nutzern mehr Kontrolle über das Modellverhalten, und die App-Ebene macht diese Kontrolle praktikabel. Doch das Entfernen von Schutzmechanismen entfernt nicht die Verantwortung: Sie geht auf die Person über, die das Modell betreibt.
Quellen
- Arditi et al., Refusal in Language Models Is Mediated by a Single Direction — arXiv 2406.11717
- Heretic-Repository und Releases — github.com/p-e-w/heretic
- Maxime Labonne, Uncensor any LLM with abliteration — Hugging-Face-Blog
- Young, Comparative Analysis of LLM Abliteration Methods — arXiv 2512.13655 (nur Abstract)
- Alice, One Pass to Break Them All (Bericht 2026) — Bericht als PDF, Herstellerforschung, nicht peer-reviewed
- WIRED, Tear Down Those Guardrails! (2026-11-10/11) — wir haben nur Reposts gelesen und zitieren den Artikel, wie berichtet
- Abliter.cn — abliter.cn; Abliteration.org — abliteration.org (Seite lieferte einen Zugriffsfehler; README-Spiegel verwendet)
- Tag-Seiten von Hugging Face — abliterated, uncensored, heretic
- Ollama-Library — ollama.com/library
- Verordnung (EU) 2024/1689 (AI Act), Art. 2 Abs. 12 und Art. 53; Leitlinien der Kommission für KI-Modelle mit allgemeinem Verwendungszweck (2025)
- Gemma Prohibited Use Policy und Nutzungsbedingungen; Llama-3.1-Lizenz und Acceptable Use Policy; Qwen3-Model-Card
- Hugging-Face-Dokumentation: Pickle Scanning und Malware Scanning; OWASP Top 10 for LLM Applications
Häufig gestellte Fragen
Was ist ein uncensored KI-Modell?
Ein uncensored KI-Modell ist ein Open-Weight-Sprachmodell, dessen Ablehnungen durch Fine-Tuning oder durch Bearbeiten seiner Gewichte verringert oder entfernt wurden. Das Ergebnis ist selten vollständig: Veröffentlichte Tests bekannter modifizierter Modelle zeigen weiterhin Restablehnungen.
Was ist der Unterschied zwischen uncensored und abliterierter KI?
Uncensored beschreibt ein Ergebnis, weniger Ablehnungen. Abliterated beschreibt eine Methode, das Bearbeiten der Gewichte, um Ablehnungsverhalten zu unterdrücken. Ein abliteriertes Modell ist meist weniger eingeschränkt, doch „uncensored“ im Modellnamen beweist ohne gemessenes Ergebnis nichts.
Was ist das beste uncensored LLM?
Es gibt kein einzelnes bestes. Für kleine Rechner passen Abliterationen von Gemma und Qwen mit 4-9B in etwa 8 GB. Für GPUs mit 24 GB passen Modelle mit 24-31B wie Dolphin Mistral 24B oder die Qwen3.8-27B-Abliteration. Prüfen Sie Belege, Lizenz und jüngste Aktivität auf der Model Card und testen Sie das Modell an Ihren eigenen Aufgaben.
Sind uncensored KI-Modelle kostenlos?
Die Gewichte sind meist kostenlos herunterladbar, unter Lizenzen wie Apache-2.0 oder der Llama Community License. Hardware und Strom zahlen Sie weiterhin selbst, und manche Lizenzen enthalten Bedingungen für Nutzung und Weitergabe.
Wo kann ich uncensored Modelle herunterladen?
Hugging Face ist der wichtigste Host für Gewichte und Model Cards, und Ollama verteilt viele als sofort lauffähige Tags. ModelScope ist ein alternativer Host. Abliter.cn und Abliteration.org sind Indizes, die beim Finden von Modellen helfen, die Dateien aber nicht hosten.
Kann ich uncensored KI lokal betreiben?
Ja. Laden Sie eine GGUF-Datei oder ein Ollama-Tag herunter und führen Sie sie in Ollama, LM Studio oder llama.cpp aus. Ein 7-9B-Modell braucht etwa 8 GB Speicher, ein 24-31B-Modell bei Q4 grob 20-28 GB.
Was ist Heretic?
Heretic ist ein Open-Source-Tool von Philipp Emanuel Weidmann, das automatisch nach Einstellungen sucht, die Ablehnungen entfernen und das Modell möglichst wenig verändern. Version 2.0, veröffentlicht am 2026-11-01, machte Arbitrary-Rank Ablation zur Standardmethode.
Entfernt Abliteration alle KI-Schutzmechanismen?
Nein. Sie zielt auf Ablehnungsverhalten und garantiert nicht, dass jede Ablehnung verschwindet. Veröffentlichte Tests zeigen Restablehnungen, und die Qualität kann sinken, besonders bei Wahrhaftigkeits-Benchmarks in der ursprünglichen Forschung.
Sind uncensored Modelle gefährlich?
Sie können missbraucht werden, und das Risiko steigt, wenn ein Modell mit Werkzeugen wie Shell, Dateien oder Web verbunden ist. In einem einfachen Chatfenster erzeugt es nur Text. Nutzen Sie bei Agenten Sandboxing, minimale Rechte, menschliche Freigabe und Protokollierung.
Ist es in Europa legal, uncensored KI zu nutzen?
Es kommt auf Besitz, Verbreitung und Nutzung an. Ein Modell zu besitzen ist etwas anderes, als es zur Begehung einer Straftat zu nutzen. Der EU AI Act verpflichtet vor allem Anbieter, und Lizenzen wie die von Llama setzen vertragliche Grenzen. Dies ist keine Rechtsberatung; lassen Sie sich für Ihren Fall anwaltlich beraten.
Welche lokalen Apps können uncensored Modelle nutzen?
Jede App, die Ihnen die Modellwahl lässt, dazu gehören LM Studio, Open WebUI, SillyTavern, AnythingLLM, Msty, KoboldCpp, Cline und n8n über Ollama- oder OpenAI-kompatible Verbindungen. Prüfen Sie, ob die von Ihnen genutzte Version eigene Modelle akzeptiert.