クイックファクト
- 中核となる論文:Arditiら、「Refusal in Language Models Is Mediated by a Single Direction」(arXiv 2406.11717、2024年)。1.8Bから72Bパラメータまでの13のチャットモデルを対象。
- Heretic:Philipp Emanuel Weidmann(p-e-w)が作成。2.0.0は2026-11-01、2.1.0は2026-11-08に公開。Optunaでパラメータを探索し、拒否数とKLダイバージェンスでスコアを付けます。
- Hugging Faceのタグ件数(2026-11-13):abliterated 13,279件、uncensored 16,629件、heretic 7,058件のリポジトリ(量子化版と重複を含む)。
- 代表的なサイズ(Q4_K_M GGUF):8Bで約5 GB、12Bで約7.6 GB、24Bで約14 GB、27Bで約16.6 GB、31Bで約18.7 GB。
- メモリの目安:31BのQ4モデルは、VRAM約22〜24 GBまたはRAM 32 GBが目安です。これらは実測ではなく推定値です。
- リスクの低いファイル形式:pickleベースの.bin、.pt、.ckptファイルよりも、safetensorsとGGUFを選んでください。
無検閲AIモデルとは
2人の人が同じオープンウェイトモデルをダウンロードしたとします。1人目が際どい質問をすると、丁寧に断られます。2人目は同じベースモデルの改変版をダウンロードしており、まったく同じ質問をすると答えが返ってきます。アーキテクチャも知識も同じなのに、挙動が違います。この差こそが、無検閲AIの本質です。
これが可能なのは、オープンウェイトモデルがファイルだからです。ホスト型のチャットボットは、重み、システムプロンプト、フィルターを他者のサーバーに置いたままで、利用者は対話することしかできません。オープンウェイトモデルでは重みそのものが手に入ります。誰でもファインチューニング、マージ、量子化、編集を行い、その結果を公開できます。拒否の挙動はモデルが学習したものなので、忘れさせたり抑えたりすることができます。
ローカルAIがこれを現実的にしました。12Bや24Bのモデルが、ノートPCや1枚のGPUで、オフラインのまま、信頼できるアプリの中で動きます。2026-11-13時点のHugging Faceのタグページには、abliteratedタグが13,279件、uncensoredタグが16,629件、hereticタグが7,058件のリポジトリが表示されましたが、これらの件数には量子化版と重複が含まれます。専門のインデックスも2つあります。abliter.cnは、スキャンした25,796のリポジトリから921モデルを表示し、abliteration.orgは19,000を超えるモデルのカタログがあると説明しています。収録の基準が違うため、これらの数字は同じものを表していません。
このテーマはニュースにもなっています。Heretic 2.0は2026-11-01に公開され、従来の単一方向の手法に代わってツールのデフォルトになりました。WIREDは2026-11-10にコミュニティを取り上げた記事を掲載しました(私たちは転載しか読めなかったため、報道として引用します)。2026-11-05に公開されたGemma 4 31Bの改変モデルは、拒否の大幅な減少を謳っています。その数値は後述の節で検討します。
このガイドは、まず現象から入り、続いて用語、仕組み、ツールを説明します。全体を貫く考え方は、これらのモデルをローカルアプリの交換可能な部品として捉えることです。アプリは文書、音声、エージェント、使いやすい画面を提供し、モデルは何に答えるかを決めます。両者を組み合わせると、ホスト型サービスにはない柔軟性が得られますが、同時にホスト型サービスが提供するセーフティネットもなくなります。
📍 一文で説明
無検閲AIモデルとは、ファインチューニングまたは重みの編集によって、元のモデルより拒否するリクエストが少なくなるよう改変されたオープンウェイトの言語モデルです。
💬 簡潔に説明
モデルを自分のものとなるファイルだと考えてください。誰かがそのファイルを編集して「はい」と答えやすくし、あなたはその編集済みファイルを自分のアプリで動かせます。
「無検閲」は実際に何を意味するか
これらの言葉は緩く使われており、そのせいで宣伝どおりに動かないものをダウンロードしてしまう人が出ます。各用語が技術的に何を意味するかを整理します。
📍 一文で説明
「無検閲」は結果(拒否が少ないこと)を表し、「アブリタレーション済み」は手法(重みの編集)を表すため、モデルはどちらか一方だけに当てはまることがあります。
💬 簡潔に説明
無検閲は期待する結果、アブリタレーションはその作り方、ジェイルブレイクは変更されていないモデルに仕掛ける小細工です。
用語 | 意味 | 技術的な保証 |
|---|---|---|
| 無検閲(Uncensored) | 内容の拒否が少ない、またはない | なし |
| フィルターなし(Unfiltered) | 出力フィルターの制限が緩い | なし |
| 非アライン(Unaligned) | アライメント学習が少ない、または異なる | なし |
| アブリタレーション済み | アブレーション手法で重みを編集 | 手法のみ |
| ジェイルブレイク | プロンプトで挙動を回避する | なし(重みは不変) |
| 制限なし(Unrestricted) | 宣伝用の用語 | なし |
ジェイルブレイクだけは性質が違います。変更するのはモデルではなくプロンプトなので、次の会話はまっさらな状態から始まります。ほかの用語は、重みに対して行われた何かを表しています。
⚠️注意: 名前に「uncensored」と入っているモデルが、必ずしも拒否を失っているとは限りません。モデルカードに測定された拒否率と、その測定方法が示されているか確認してください。
💡ヒント: 2つのものがよく混同されます。ステアラブルなモデル(HermesやDolphin)は、システムプロンプトで挙動を決められます。アブリタレーション済みのモデルは、重みから拒否の挙動が取り除かれています。
AIモデルが拒否を学ぶ仕組み
事前学習では、膨大なコーパスからテキストを予測できるようにモデルを訓練します。その結果できるのは、能力は高いものの方向性のないシステムで、ほとんど何でも続きを書いてしまいます。続いてインストラクションチューニングと教師ありファインチューニング(SFT)で、サンプルの会話を学習させ、質問に役立つ形式で答えられるようにします。
選好学習が安全層を加えます。RLHF(人間のフィードバックによる強化学習)では、人間の評価者が回答を比較し、報酬モデルがその好みを学習し、モデルはそれに向けて最適化されます。DPO(直接選好最適化)は、別個の報酬モデルなしで似た結果に到達します。安全性データセットは、有害なリクエストと拒否の応答を対にしているため、モデルは特定の種類のリクエストは断るべきだと学びます。これが拒否学習です。
この挙動はどこに存在するのでしょうか。2か所です。システムプロンプトは実行時に先頭に付加されるテキストで、変更できます。モデルの重みの挙動は学習中に埋め込まれるもので、重みに手を加えない限り変更できません。システムプロンプトだけではモデルに答えさせられないことがあるのに、重みの編集ならそれができるのはこのためです。
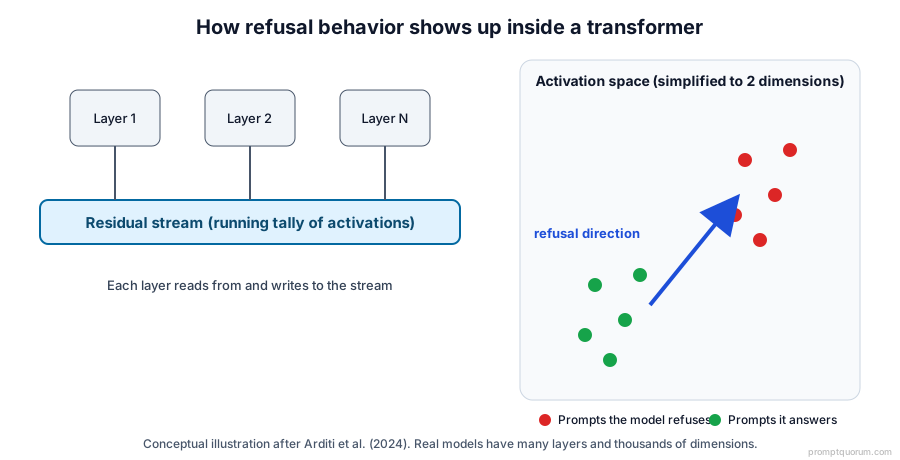
図は、アブリタレーションを可能にする考え方を示しています。トランスフォーマーの内部では、各層が「残差ストリーム」と呼ばれる共有の累計に対して読み書きを行います。研究によれば、拒否に関する信号の多くは、このストリーム上の1つの方向に沿って存在すると考えられています。
アブリタレーションとは
科学的な土台はArditiら(2024)の「Refusal in Language Models Is Mediated by a Single Direction」(arXiv 2406.11717)です。著者らは、1.8Bから72Bパラメータの13のオープンなチャットモデルをテストしました。結論は、これらのモデルでは拒否が残差ストリーム上の単一の方向によって媒介されている、というものです。
方向の見つけ方。有害なプロンプトの集合と無害なプロンプトの集合でモデルを動かし、選んだ層とトークン位置で内部の活性化を記録して、2つの平均の差を計算します。この平均の差のベクトルが、拒否方向の候補になります。
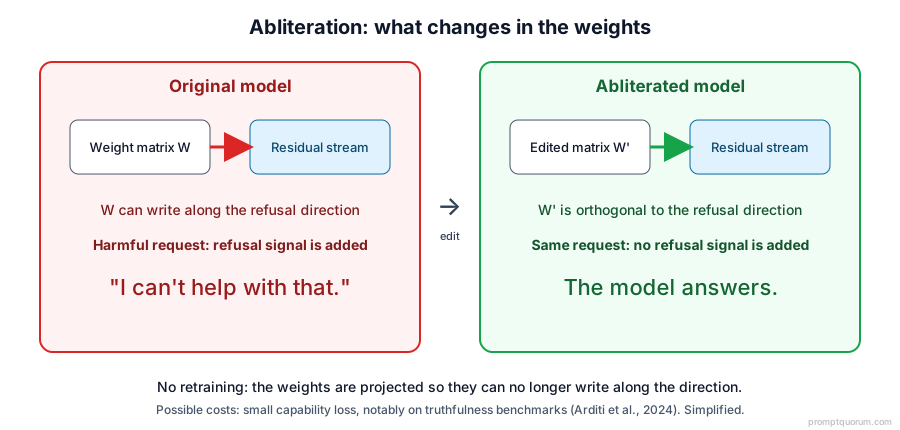
方向の取り除き方。方向性アブレーションは、実行時に活性化からその方向を射影して取り除きます。重みの直交化は同じ効果を恒久的に実現します。残差ストリームに書き込む重み行列を、その方向に書き込めないように変更するのです。編集後のモデルは再学習が不要で、ファイルの見た目はほかのモデルと変わりません。
失われるもの。著者らは、ほとんどのベンチマークで能力の低下は小さいと報告していますが、TruthfulQAは例外で、約1〜3.5ポイント一貫して低下しました。また、方向の選択手法はヒューリスティックだとも述べています。Maxime Labonneの実践ガイドでは、測定したすべてのベンチマークでアブリタレーションにより数値が下がり、DPOによる「修復」ステップで大部分は回復したものの全部ではなく、層の選択には判断力が要ることが分かりました。
数値についての注意。セキュリティ企業のAliceは、5つのモデルをテストし、アブリタレーション後の遵守率が98.0%(550プロンプト中539)、前が5.8%だったと報告するレポートを公開しました。また、6つのモデルファミリーで96〜100%だったと報告するブログ記事も公開しています。これらの数値は企業による報告で、LLMの判定者が採点したものであり、査読を受けておらず、実世界での能力向上ではなく、答える意思を測っています。証拠ではなく、1つのデータ点として扱ってください。
📍 一文で説明
アブリタレーションは、活性化の差から拒否方向を推定し、モデルがその方向に書き込めないよう重みを編集します。
💬 簡潔に説明
拒否がモデル内部のダイヤルだとすれば、アブリタレーションはそのダイヤルを見つけて取り除く作業であり、モデルに新しいことを教えるわけではありません。
Heretic 2.0:アブリタレーションの次世代
開発者と概要。Hereticは、Philipp Emanuel Weidmann(GitHubハンドルはp-e-w)が作成したオープンソースのコマンドラインツールです。人間に層や強度を選ばせる代わりに、探索を自動化します。
従来のアプローチ。Hereticは、TPEサンプラーを備えたハイパーパラメータ最適化ライブラリのOptunaを使い、多数のアブリタレーション設定を試します。差し替え可能なスコアラーが各試行を評価します。デフォルトでは、キーワードのスコアラーで拒否を数え、無害なプロンプトでの元のモデルとのKLダイバージェンスを測定するため、探索は、ほかをできるだけ変えずに拒否だけを取り除く設定を探します。実際に重みを編集する部品がモディファイアです。
2.0での変更点。バージョン2.0.0は2026-11-01に公開されました(2.1.0は2026-11-08)。デフォルトのモディファイアは任意ランク・アブレーション(ARA)になりました。従来の方向性アブレーションは、射影アブリタレーションとノルム保存のオプション付きで引き続き使えます。このリリースでは、プラグインシステム、ヘッドレス動作、プラグインとしてのBERTベースの拒否スコアラーも追加されました(デフォルトのスコアラーは引き続きキーワードベースです)。Heretic 1.xの設定ファイルは2.xでは動作しません。
ARAとは何か。作者自身のプルリクエストによれば、ARAは拒否方向を使いません。3つの目標に対してL-BFGSオプティマイザで、モジュールごとの行列の編集を学習します。無害なプロンプトの出力はそのままにすること、有害なプロンプトの出力を無害なものに一致させること、そして元の有害な出力から遠ざけることです。単一の方向はランク1の編集ですが、ARAはより高いランクの編集を許容するため、1次元ではない拒否の挙動も捉えられます。詳細な解説は「近日」公開予定のプレプリントとされており、品質に関する主張は作者自身のもので、独立した検証は行われていません。
ハードウェアとトレードオフ。このツールはモデル全体を読み込んで多数の試行を実行するため、改変するモデルを動かせるだけのメモリと時間が必要です。品質のトレードオフはほかの手法と同じ傾向です。16モデルに対する4つのツールの比較研究(Young、arXiv 2512.13655、アブストラクトを確認)は、GSM8Kの変化が+1.5から-18.8ポイント、HereticのKL値が0.04から1.65だったと報告しており、結果はモデルによって大きく異なります。
⚠️注意: 2.0に関するいくつかの詳細はサードパーティのブログ記事に見られますが、リポジトリとは照合できませんでした。リポジトリ、リリースノート、作者のプルリクエストに書かれていることだけを事実として述べ、それ以外は「報告によれば」と明示します。
無検閲モデルを作るその他の方法
アブリタレーションだけが方法ではありません。表は主なアプローチを比較しています。マージの行は意図的に慎重にしています。マージが拒否を取り除く手法であると記した一次情報は見つかりませんでした。
手法 | 変更される対象 | 学習が必要か | 主なトレードオフ |
|---|---|---|---|
| 無検閲ファインチューニング | 重み(新しいデータ経由) | 必要 | 計算量とデータ品質 |
| アブリタレーション | 重み(単一方向) | 不要 | 一部の能力低下 |
| 自動アブリタレーション | 重み(探索した設定) | 不要 | 試行時間とメモリ |
| モデルマージ | 複数モデルの混合 | 不要 | 拒否への効果は未確認 |
| 選好最適化 | 重み(選好経由) | 必要 | ペアのデータが必要 |
最もよく知られたファインチューニングのアプローチは、Eric HartfordのDolphinシリーズです。学習データから拒否型の回答を取り除き、挙動はシステムプロンプトに任せます。ファインチューニングはLoRAアダプタでも行えます。また、公表された研究では、少量の有害なファインチューニングで安全性学習を元に戻せると報告されています(Qi et al.、Lermen et al.)。ノルム保存型の双射影アブリタレーションのような新しい重み編集の派生手法は、副作用を減らそうとするもので、DPOによる「修復」は、編集後に品質を回復するために使われます。
主要な無検閲AIモデルファミリー
Dolphin(cognitivecomputationsと、より新しいdphn組織)は、最もよく知られたファインチューニング系列です。現時点で確認済みのエントリはDolphin-Mistral-24B-Venice-Editionです。モデルカードには、システムプロンプトが挙動を決めるとあるため、ステアラブルであり、拒否がないことが保証されているわけではありません。
Hermes(NousResearch)は無検閲のファミリーではありません。Hermes 4のモデルは中立的にアライメントされ、ステアラブルです。Nous Research自身のRefusalBenchは、Hermes 4.3 36Bのカードで報告されているとおり、このモデルがテストプロンプトの約72〜75%に答えたことを示しており、約4分の1は依然として拒否されます。すべてのHermesモデルを無検閲に分類しないでください。
Qwenのアブリタレーション版はダウンロード数の上位を占めます。確認済みで最もダウンロードされているエントリはHuihui-Qwen3.8-27B-abliteratedで、約400万ダウンロードあります。検索:Hugging FaceでのQwen abliterated。
Gemmaのアブリタレーション版は最も新しい分野です。Gemma 4の改変モデルは、通常のアブリタレーション版と、HereticおよびARAによる版の両方があります。検索:Gemma abliterated。そのうちGemma 4 31BのARAモデルは拒否の大幅な減少を謳っており、後述で検討します。
Llamaのアブリタレーション版は、ほとんどが古いものです。私たちの2026-11-13の確認では、Llama 3.1と3.3より新しいものでダウンロード数の多いものはなく、最もダウンロードされている8Bのエントリは2024年のものです。検索:Llama abliterated。
Mistral、DeepSeek、GLM。Mistral Small 3.2 24Bのアブリタレーション版があります。DeepSeekとGLMについては、最新モデルのアブリタレーション版は存在しますが、それぞれ約284 GBと321 GBあり、一般向けハードウェアの範囲外です。実用的なのは、古い32BのDeepSeek R1ディスティルだけです。
Gemma 4 31Bの主張への批判的な読み方。モデルカードは、拒否が100プロンプト中99件から28件に減ったと報告しています(Heretic v2.0.0 ARA、KLダイバージェンス0.0845)。これは72%の相対的な減少ですが、同時に100件のテストプロンプトのうち28件は検出器に引っかかったままです。検出器は「sorry」や「illegal」などの約34個のキーワードのリストで、100トークンで切り詰めた応答に適用されます。そのため、免責文付きの有用な回答は拒否として数えられ、これらの語を含まない回答拒否はコンプライアンスとして数えられます。テストセットは1つのデータセットからの100プロンプトで、元のモデルは99/100、KLの数値は無害なプロンプトのみで測定されているため、能力については何も語りません。カードは再現性を謳っていますが、その再現ファイルには、コミットされていないローカルのHereticビルドを使ったという警告があります。独立した評価は見つかりませんでした。同じベースの別の31B再パックは、KL 0.054で10/100と報告していますが、作者、実行、設定の異なる結果は比較できません。
💡ヒント: 拒否率の数値は、ベンチマークの数値と同じように読んでください。何を拒否と数えたのか、プロンプトは何件か、応答はどこまでの長さを許したのか、誰がテストしたのかを確認しましょう。
無検閲AIモデルはどこでダウンロードできるか
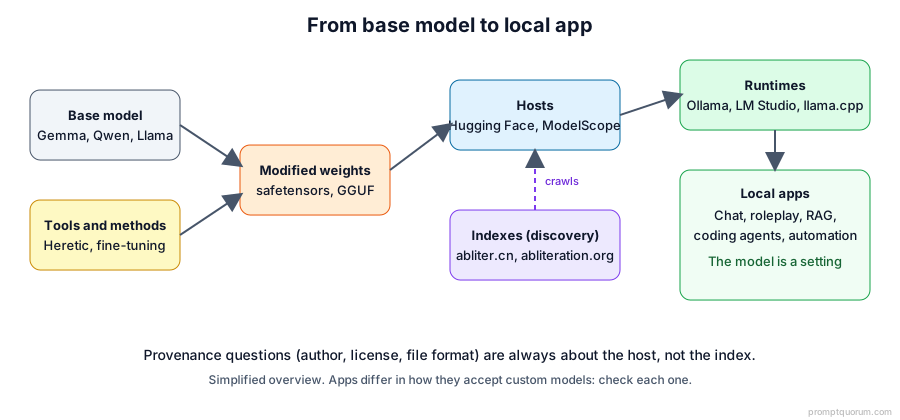
ホスティングプラットフォームは、ファイルそのものを保管して配信します。専門のインデックスは、ホスティングプラットフォームをクロールして、発見のための層を加えるだけです。インデックスは候補を見つける助けになりますが、ダウンロードするファイルは依然としてホストから届くため、出所の問題は常にホストと作者についてのものです。
プラットフォーム | 役割 | ウェブサイト |
|---|---|---|
| Hugging Face | 重みとモデルカード | huggingface.co |
| Ollama | ローカルでの実行と配布 | ollama.com |
| ModelScope | 代替のリポジトリ | modelscope.cn |
| GitHub | ツールとソースコード | github.com |
| Abliter.cn | モデル発見用インデックス | abliter.cn |
| Abliteration.org | カタログと分析 | abliteration.org |
実行する前に確認してください。safetensorsとGGUFのファイルを選んでください。pickleベースの形式(.bin、.pt、.pkl、.ckpt)は、読み込み時にコードを実行する可能性があり、Hugging Faceのドキュメントは、信頼できる作者とsafetensorsを推奨しています。見知らぬリポジトリでtrust_remote_codeを有効にしないでください。モデルカードにベースモデルと手法が明記されているか、ベースモデルの系譜が公式リポジトリまでたどれるかを確認し、作者がハッシュを公開している場合は照合し、ライセンスを読んでください。Hugging Faceは2 GB未満のリポジトリファイルにマルウェアスキャンを実行するため、大きな重みファイルはその対象外かもしれません(ドキュメントについての私たちの解釈)。信頼できる量子化提供者による量子化版が保証するのはファイル形式であり、元の作者の主張ではありません。huihui_aiやrichardyoungなどのOllamaの名前空間は、ユーザーによるアップロードであり、ライブラリで審査されたモデルではありません。
ダウンロードする価値のある無検閲モデル
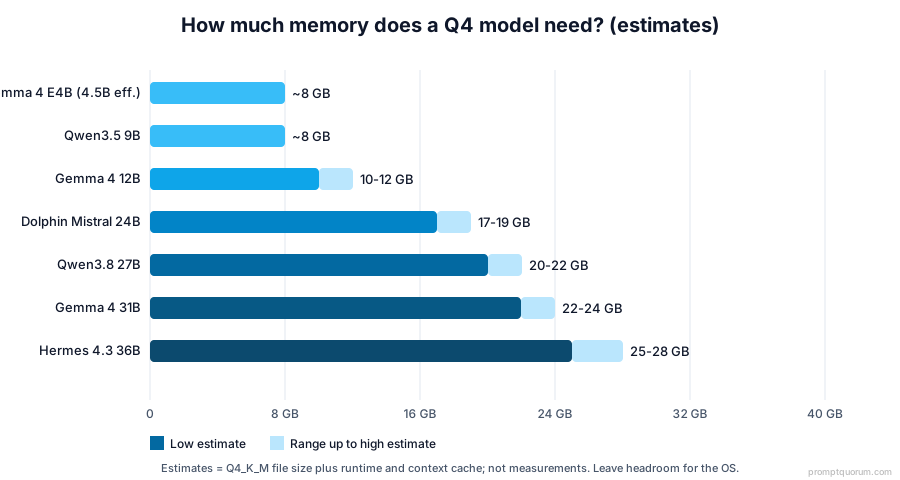
2026-11-13に、古い記事ではなくHugging Face APIとモデルカードを基に、現行の10のリポジトリを確認しました。サイズは、リポジトリが公開している場合のQ4_K_M GGUFのファイルサイズです。メモリの数値は実測ではなく、私たちの推定(ファイルサイズにランタイムとキャッシュを加えたもの)です。ダウンロード数と日付は常に変動するため、この表はスナップショットであり、記事とは別に更新する必要があります。
Gemma 4 31B ARA Heretic
- ベース:
- Gemma 4 31B-it
- 手法:
- Heretic 2.0 ARA
- パラメータ:
- 30.7B
- Q4サイズ:
- 18.7 GB
- メモリ(推定):
- VRAM 22〜24 GB
- コンテキスト:
- 262K
- ライセンス:
- Apache-2.0
- 既知の制約:
- 独立した検証は見つからず
Gemma 4 E4B Heretic
- ベース:
- Gemma 4 E4B-it
- 手法:
- Heretic ARA
- パラメータ:
- 実効4.5B
- Q4サイズ:
- 5.3 GB
- メモリ(推定):
- 約8 GB
- コンテキスト:
- 131K
- ライセンス:
- Apache-2.0
- 既知の制約:
- 再パック者自身のテスト
Huihui Gemma 4 12B
- ベース:
- Gemma 4 12B-it
- 手法:
- アブリタレーション
- パラメータ:
- 12.0B
- Q4サイズ:
- 7.6 GB
- メモリ(推定):
- 10〜12 GB
- コンテキスト:
- 128〜256K
- ライセンス:
- Apache-2.0
- 既知の制約:
- カード記載:「概念実証」
Huihui Qwen3.8 27B
- ベース:
- Qwen3.8 27B
- 手法:
- アブリタレーション
- パラメータ:
- 27.3B
- Q4サイズ:
- 16.6 GB
- メモリ(推定):
- 20〜22 GB
- コンテキスト:
- 262K
- ライセンス:
- Apache-2.0
- 既知の制約:
- 免責文が付く場合あり
Huihui Qwen3.5 9B
- ベース:
- Qwen3.5 9B
- 手法:
- アブリタレーション
- パラメータ:
- 9.7B
- Q4サイズ:
- 5.6 GB
- メモリ(推定):
- 約8 GB
- コンテキスト:
- 262K
- ライセンス:
- Apache-2.0
- 既知の制約:
- カードに拒否データなし
Dolphin Mistral 24B Venice
- ベース:
- Mistral Small 24B
- 手法:
- ファインチューニング
- パラメータ:
- 24.0B
- Q4サイズ:
- 14.3 GB
- メモリ(推定):
- 17〜19 GB
- コンテキスト:
- 131K
- ライセンス:
- Apache-2.0
- 既知の制約:
- プロンプトで挙動を設定
Hermes 4.3 36B
- ベース:
- Seed-OSS 36B
- 手法:
- ポストトレーニング
- パラメータ:
- 36.2B
- Q4サイズ:
- 21.8 GB
- メモリ(推定):
- 25〜28 GB
- コンテキスト:
- 524K
- ライセンス:
- Apache-2.0
- 既知の制約:
- 無検閲ではない
Hermes 4 14B
- ベース:
- Qwen3 14B
- 手法:
- ポストトレーニング
- パラメータ:
- 14.8B
- Q4サイズ:
- 9.0 GB
- メモリ(推定):
- 11〜12 GB
- コンテキスト:
- 41K
- ライセンス:
- Apache-2.0
- 既知の制約:
- 無検閲ではない
Llama 3.1 8B abliterated
- ベース:
- Llama 3.1 8B
- 手法:
- アブリタレーション
- パラメータ:
- 8.0B
- Q4サイズ:
- 4.9 GB
- メモリ(推定):
- 7〜8 GB
- コンテキスト:
- 131K
- ライセンス:
- Llama 3.1の規約
- 既知の制約:
- 2024年の古いモデル
R1 Distill Qwen 32B
- ベース:
- R1-Distill-Qwen-32B
- 手法:
- アブリタレーション
- パラメータ:
- 32.8B
- Q4サイズ:
- 19.9 GB
- メモリ(推定):
- 23〜26 GB
- コンテキスト:
- 131K
- ライセンス:
- タグなし
- 既知の制約:
- 2025年の古いモデル、ライセンスタグなし
表の読み方。Qwen3.8 27Bのアブリタレーション版は、ダウンロード数が群を抜いて多く(約400万)ですが、カードには、出力に小さな免責の警告が付く場合があると書かれており、「アブリタレーション済み」が「何にでも答える」を意味しないことを思い出させます。小さなマシンでは、Gemma 4 E4BとQwen3.5 9Bのエントリが約8 GBに収まります。一部には確認済みのOllamaタグがあります。ollama run huihui_ai/gemma-4-abliterated:12b、ollama run huihui_ai/qwen3.5-abliterated:9b、huihui_ai/Qwen3.8-abliterated(約18 GB)です。Gemma 4 31Bのモデルは、作者の名前空間にOllamaのページがあります。Hermes 4.3 36Bを載せているのは、ステアラブルで中立的にアライメントされたモデルを、改変モデルと並べて見られるようにするためです。Nous Research自身のベンチマークでは、約4分の1のプロンプトが拒否されたままです。Llama 3.1の規約は、「Built with Llama」の表示と、派生モデル名の先頭に「Llama」を付けることを求めており、R1ディスティルにはライセンスタグがないため、ライセンスがあると決めつけないでください。Mistral Small 3.2のアブリタレーション版(24B)と、Llama 3.3 70Bのアブリタレーション版(Q4で約42.5 GB、64 GBクラスのマシン向け)もありますが、古いものです。
ローカルアプリで無検閲モデルを使う
これが重要な理由は、ローカルAIのアーキテクチャにあります。ほとんどのローカルアプリは、固定のモデルを同梱していません。バックエンド(通常はOllama、llama.cpp、またはOpenAI互換サーバー)に接続するか、自分で選んだGGUFファイルを読み込みます。
私たち自身のレビューでも、カテゴリを問わずこのパターンが確認できます。SillyTavernは、KoboldCpp、text-generation-webui、Ollama、LM Studioに接続します。Open WebUIは、Ollamaや任意のOpenAI互換APIの前面に立ちます。LM Studioは、Hugging Faceブラウザを内蔵してGGUFモデルを実行します。AnythingLLM、Msty、Clineは、OllamaやLM Studioに接続します。n8nには専用のOllamaノードがあり、KoboldCppはGGUFファイルを直接実行します。モデルが設定項目であれば、タスクごとに中立的なモデルと制限のないモデルを切り替えられます。
得られるもの。アプリの機能と、自分で選んだモデルが、オフラインで、会話を読むホスト型の事業者なしに手に入ります。表は、カテゴリごとにそれがどう働くかを示しています。頼る前に、お使いのアプリのバージョンがカスタムモデルを受け付けるか確認してください。このリストは出発点であり、保証ではありません。
📍 一文で説明
ほとんどのローカルアプリはモデルを交換可能な設定として扱うため、制限のないモデルと組み合わせると、アプリ自体を変えずに、アプリ全体の振る舞いが変わります。
💬 簡潔に説明
アプリは車、モデルは運転手です。「はい」と言いやすい運転手に替えれば、同じ車がこれまで行かなかった場所へ行きます。
アプリのカテゴリ | アプリの例 | 制限のないモデルで増えること |
|---|---|---|
| チャットクライアント | LM Studio, Msty, Open WebUI | 拒否される質問が減る |
| ロールプレイと創作 | SillyTavern, KoboldCpp | ダークな題材、場面途中の拒否なし |
| 文書RAG | AnythingLLM, Open WebUI | 推論は端末内で完結 |
| コーディングエージェント | Cline, Aider, Continue | セキュリティテストのコード支援 |
| 自動化 | n8n(Ollamaノード) | 独自のパイプライン、独自のポリシー層 |
| パーソナルエージェント | Hermes Agent, nanobot | 自律性が増す、安全対策が必要 |
柔軟性が増す具体例。小説家は、SillyTavernの背後でアブリタレーション済みまたはステアラブルなモデルを動かして、場面の途中で拒否されることなく、道徳的に複雑なフィクションを書けます。これについては私たちの創作ガイドで詳しく扱っています。弁護士、ジャーナリスト、研究者は、機密文書のフォルダをAnythingLLMに向け、ホスト型モデルなら議論を断るかもしれない内容について質問でき、推論はマシン上で実行されます。各アプリのテレメトリーとアップデートの設定を確認してください。アプリやモデルのダウンロードでは、引き続きネットワークが使われることがあります。セキュリティの専門家は、承認されたテスト環境の中で、エクスプロイトに近い質問をためらわないモデルを使ったコーディングエージェントを使えます。開発者は、モデルを設定項目にしたn8nのワークフローを作り、何も書き換えずにモデルを変更できます。パワーユーザーは、1つのアプリで2つのモデルを動かし、日常の作業には中立的なモデルを、前者が断るタスクには制限のないモデルを使えます。
⚠️注意: この柔軟性には代償があります。チャット画面では、制限のないモデルが生成するのはテキストだけです。ファイル、シェル、Webにアクセスできるエージェントに接続すると、同じモデルが自分の生成した内容に基づいて行動できます。こうした構成には、サンドボックス、最小権限、人による承認を組み合わせてください。
💡ヒント: どのアプリが自分のモデルを読み込めるか、またハードウェアに合うか分からない場合は、ローカルLLMソフトウェアディレクトリを用途、OS、RAMで絞り込むか、Ask Hansにマシンの構成を伝えてください。
無検閲AIをローカルで動かす方法
Ollama(ollama.com)は、コマンドラインで使う方に最も簡単な方法です。名前を指定してモデルを取得すると、多くのアプリが理解できるAPIを提供します。LM Studio(lmstudio.ai)はグラフィカルな方法で、Hugging FaceブラウザとローカルのOpenAI互換サーバーを内蔵しています。llama.cpp(github.com/ggml-org/llama.cpp)は、これらのツールの多くの土台となるエンジンで、GGUFファイルを直接実行します。Transformers(huggingface.co/docs/transformers)は、完全精度のsafetensors重みをPythonで読み込み、研究や、モデルを評価・改変するつもりの方に向いています。
GGUFと量子化。GGUFは、llama.cppベースのツールが使う単一ファイル形式です。量子化は、より少ないビット数で重みを保存します。Q4_K_Mが一般的な妥協点で、品質への影響は小さいまま、完全精度の約4分の1のサイズになります。量子化を下げるとメモリは節約できますが、推論や指示追従に悪影響が出ることがあるため、実際に使うファイルをテストしてください。
ハードウェア。Apple Siliconでは、ユニファイドメモリがCPUとGPUで共有されるため、32 GBのMacなら、約24〜27BパラメータのQ4モデルとコンテキストを保持できます。システム用に数GBは残してください。NVIDIAのGPUでは、モデルがVRAMに収まる必要があります。24 GBのカードなら上記の24〜31Bのモデルに適しており、8 GBなら4〜9Bのモデルに適しています。モデルが収まらない場合、層がシステムRAMにあふれ、速度が急激に落ちます。正確な数値は、ローカルLLMに必要なVRAMを参照してください。
オフライン動作。重みがディスクにあれば、これらのツールはテキストの生成にインターネットを必要としません。これが主なプライバシー上の論拠であり、同時に、事業者がローカルのコピーに利用規則を強制できない理由でもあります。
自分でアブリタレーション済みモデルを作れるか
概念的には可能で、以前より取り組みやすくなっています。ここでは、ワークフローを概要のレベルでのみ説明します。
- 1オープンウェイトのモデルを選ぶ
Why it matters: ツールがモデルを読み込む必要があるため、メモリに収まるサイズのものを選びます。 - 2ライセンスを確認する
Why it matters: 一部のライセンスや利用ポリシーは安全フィルターの回避を制限しています(以前のGemma規約も同様でした)。改変や再配布の前に、正確なベースモデルのライセンスを読んでください。 - 3アーキテクチャの互換性を確認する
Why it matters: ツールは特定のアーキテクチャに対応しており、新しいモデルはまだ動かないことがあります。 - 4手法を選ぶ
Why it matters: 従来の方向性アブレーションか、ARAを備えたHereticなどの自動ツールを選びます。 - 5改変を実行する
Why it matters: 自動ツールは多数の設定を探索します。従来の手法は、自分の層の選択に依存します。 - 6結果を評価する
Why it matters: ツールがチューニングに使わなかったプロンプトで、拒否と品質低下を測定します。 - 7元のモデルと比較する
Why it matters: 拒否が減っても、能力は下がることがあります。 - 8文書化し、責任を持って公開する
Why it matters: 手法、数値、ベースモデル、ライセンスの系譜を明記します。
無検閲AIのリスク
リスクは、理解に必要な範囲で説明し、実行手順にあたる詳細は示しません。
- サイバー犯罪とマルウェアへの加担。拒否の少ないモデルは、悪意のあるコードを書く手助けを得るための手間を減らします。すでに入手可能なものを超えて能力が増すかどうかは、議論があります。
- フィッシングと詐欺。流暢で個人に合わせた詐欺文は、能力のあるモデルなら簡単に作れます。拒否は障壁の1つでしたが、その効果は弱まっています。
- 危険な生物・化学情報。これは政策論争で最も重大な懸念です。報告されている拒否率の数値は、答える意思を測っているのであって、実世界での能力向上ではないため、危険性にも安全性にも証明にはなりません。
- 兵器関連の悪用。同じ注意が当てはまります。測定された遵守率は、実証された能力ではありません。
- 嫌がらせと虐待的なコンテンツ。ローカルモデルは、虐待的な素材を大量に生成できます。児童性的虐待コンテンツは、私たちが把握している法域では犯罪です。ドイツでは刑法第184b条(§ 184b StGB)が写実的な描写も対象としているため、写実的なAI生成素材も処罰されうるものと考えてください。生成、依頼、保存はしないでください。
- 誤情報。拒否が少ないことは、説得力のある虚偽のコンテンツを作る障壁が少ないことでもあります。
- プライバシーとデータセキュリティ。ローカル推論ではプロンプトがマシン上にとどまりますが、ダウンロードは別のリスクです。見慣れないリポジトリには悪意のあるファイルが含まれていることがあり、アプリがネットワーク通信を行う場合もあります。
- 悪意のあるモデルファイル。pickleベースの形式は、読み込み時にコードを実行する可能性があり、スキャンは保証になりません(Hugging Faceのpickleスキャンに関するドキュメントを参照)。既知の作者によるsafetensorsまたはGGUFを使ってください。
- ツールにアクセスできる自律エージェント。これが最大の変化です。ファイル、シェル、Webに接続された制限のないモデルは、行動できます。OWASPは、プロンプトインジェクション(LLM01)と過剰な権限(LLM06)を、LLMアプリケーションの主要なリスクに挙げています。
ガードレールに反対する人がいる理由
制限の緩いモデルを支持する最も強い論拠は、公正に述べるに値します。
- 表現の自由。支持者は、成人が何を読み、何を書くかをツールが決めるべきではないと主張します。
- 科学研究。拒否を含むモデルの挙動を研究するには、改変できるモデルが必要です。アブリタレーションの研究自体が、オープンウェイトに依存しています。
- セキュリティテスト。レッドチームには、防御をテストするために、攻撃について議論できるモデルが必要です。
- 創作。フィクションには、悪役、暴力、道徳的な複雑さが必要で、慎重すぎるモデルはそれを平板にしてしまうことがあります。
- ユーザーの自律。ローカルのツールの限界は、ベンダーではなくユーザーが決めるべきだという意見もあります。
- プライバシーとローカル実行。機密性の高い素材はお使いのマシン上で処理されるため、ホスト型の事業者にプロンプトが渡ることはありません。各アプリのテレメトリ設定を確認してください。
- 過度な制限の回避。商用モデルへの批判者は、無害な質問への拒否を挙げます。Eric Hartfordの無検閲モデルに関するエッセイはこの論点を述べています。
AIの安全対策が重要な理由
反対の論拠も同じくらい現実的です。安全対策は、モデルが深刻な害に加担する可能性を減らし、弱い立場のユーザーを守り、製品への導入を正当化できるものにします。
重要な区別は、テキストを生成するモデルと、コマンドを実行し、ファイルを読み、Webを閲覧し、他のシステムとやり取りできるエージェントの違いです。チャットモデルが有害なものを書いても、それに基づいて行動するのは人間です。同じモデルを使うエージェントが行動すれば、出力と結果の間の隔たりはなくなります。
オープンモデルの安全対策を改ざん耐性のあるものにするのは難しく、上記のアブリタレーションの研究は、1回の重みの編集で拒否の挙動を抑え込めることを示しています。これは、より強力なモデルレベルの保護と、モデルの外側の制御を求める中心的な論拠です。
自分で安全対策を作れるか
はい。ローカルのモデルには事業者側の層がないため、自分でその周りに追加します。
- モデレーション層。入力と出力に対して、Llama GuardやShieldGemmaなどの分類器を実行します。
- 入力と出力のフィルタリング。自分のワークフローに入れたくないカテゴリを、ブロックするかレビューします。
- サンドボックス。エージェントは、失ってよいもの以外にアクセスできないコンテナや仮想マシンの中で実行します。
- 権限の制限。エージェントには、必要最小限の権限だけを与えます。読み取り専用フォルダ、ネットワークなし、必要な場合を除きシェルなし、です。
- 人による承認。エージェントがファイルを書き込む、コマンドを実行する、メッセージを送る前に、確認を必須にします。
- ログと監視。エージェントが何をなぜ行ったかの記録を残します。
- エージェントのセキュリティ。エージェントが読むすべての文書、Webページ、メールを、指示が含まれているかもしれない信頼できない入力(プロンプトインジェクション)として扱います。
無検閲AIモデルのダウンロードと使用は合法か
単一の答えはなく、これは法的助言ではありません。切り分けるべき問いは、所持、配布、使用であり、答えは国やモデルの用途によって異なりえます。
EU AI法。規則(EU)2024/1689は、汎用AIモデルの提供者に義務を課しており、オープンソースモデルには部分的な適用除外がありますが、システミックリスクのあるモデルには適用されません。汎用AIモデルの義務は2025-08-02から、欧州委員会の執行権限は2026-08-02から適用されます。欧州委員会の2025年のガイドラインは、下流の改変者が提供者になるのは、目安となる計算量のしきい値を超える場合だけだとしています。私たちはアブリタレーションがそれをはるかに下回ると解釈していますが、この基準は拘束力がありません。2026年のデジタルオムニバスが汎用AIの期日を変更したかどうかは、条文から確認できなかったため、最新の条文を確認してください。
所持と使用の違い。モデルファイルを所有することと、それを使って犯罪を行うことは別の問題です。刑法は、禁止されたコンテンツの作成、詐欺、嫌がらせ、コンピュータ犯罪のために設計されたツールなど、特定の行為に結び付きます。私たちはドイツの規定を部分的にしか確認していないため、それらについてこのガイドに頼らないでください。
ライセンスと契約。ライセンスは、法律の上に規則を加えます。Gemma 4のモデルカードはApache-2.0を記載し、Gemma 4のライセンスページへのリンクを示しています。以前のGemma世代はGemma利用規約と利用禁止ポリシーを用いており、これらは安全フィルターの回避を禁じています。正確なベースモデルのライセンスページを確認してください。Llama 3.1のライセンスは、「Built with Llama」の表示と、派生モデルの名前の接頭辞を求めており、利用を制限する許容利用ポリシーがありますが、私たちの解釈では、明示的な回避禁止条項はありません。表に挙げたQwen3.5とQwen3.8のカードは、Apache-2.0と記載しています。派生モデルだけでなく、常にベースモデルのライセンスを読んでください。
データ保護と著作権。個人データをローカルで処理しても、データ保護法の対象になり、元になったモデルの学習データに関する著作権の問題は未解決です。拒否を取り除いても、どちらも変わりません。
無検閲AIはAIエコシステムの恒久的な一部になるか
いくつかの傾向は「はい」を示しています。コミュニティによる改変は大規模で、拡大しています。上記のHugging Faceのタグ件数は数千のリポジトリに及びます。ツールはより自動化が進んでいます。Hereticは設定を代わりに探索し、ARAは単一の方向を超えます。拒否を取り除く新しい技術は今後も登場し続け、安全対策をより取り除きにくくする技術も同様です。
ほかの動きは別の方向に引っ張ります。デプロイする側がポリシーを選べる設定可能な安全アーキテクチャ、制限の緩いモデルを提供する商用サービス、ユーザーの手に制御を委ねることが増えるローカルAI、そしてまだ形成途上の規制です。オープンウェイトが改ざん耐性を持てるのかについて、議論は今後も続くでしょう。
結論。オープンウェイトのAIは、ユーザーにモデルの挙動に対するより大きな制御を与えており、アプリ層がその制御を実用的にします。しかし、安全対策を取り除いても責任はなくなりません。モデルを動かす人に移るのです。
出典
- Arditiら、Refusal in Language Models Is Mediated by a Single Direction — arXiv 2406.11717
- Hereticのリポジトリとリリース — github.com/p-e-w/heretic
- Maxime Labonne、Uncensor any LLM with abliteration — Hugging Faceブログ
- Young、Comparative Analysis of LLM Abliteration Methods — arXiv 2512.13655(アブストラクトのみ)
- Alice、One Pass to Break Them All(2026年のレポート)— レポートPDF、ベンダーによる調査で査読なし
- WIRED、Tear Down Those Guardrails!(2026-11-10/11)— 転載のみ確認し、報道として引用しています
- Abliter.cn — abliter.cn、Abliteration.org — abliteration.org(サイトはアクセスエラーを返したため、READMEのミラーを使用)
- Hugging Faceのタグページ — abliterated、uncensored、heretic
- Ollamaライブラリ — ollama.com/library
- 規則(EU)2024/1689(AI法)第2条(12)および第53条、汎用AIモデルに関する欧州委員会のガイドライン(2025年)
- Gemma利用禁止ポリシーおよび規約、Llama 3.1のライセンスと許容利用ポリシー、Qwen3のモデルカード
- Hugging Faceのドキュメント:Pickle ScanningとMalware Scanning、OWASP Top 10 for LLM Applications
よくある質問
無検閲AIモデルとは何ですか?
無検閲AIモデルとは、ファインチューニングまたは重みの編集によって、拒否を減らした、あるいは取り除いたオープンウェイトの言語モデルです。結果が完全であることはまれで、よく知られた改変モデルの公開テストでも、拒否が残る例が示されています。
無検閲AIとアブリタレーション済みAIの違いは何ですか?
無検閲は結果、つまり拒否が少ないことを表します。アブリタレーション済みは手法、つまり拒否の挙動を抑えるために重みを編集することを表します。アブリタレーション済みのモデルは通常、制限が緩くなりますが、測定された結果がなければ、モデル名の「uncensored」は何も証明しません。
最高の無検閲LLMはどれですか?
唯一の最高はありません。小さなマシンなら、4〜9BのGemmaとQwenのアブリタレーション版が約8 GBに収まります。24 GBのGPUなら、Dolphin Mistral 24BやQwen3.8 27Bのアブリタレーション版などの24〜31Bのモデルが収まります。モデルカードで根拠、ライセンス、最近の活動を確認し、自分のタスクでテストしてください。
無検閲AIモデルは無料ですか?
重みは通常、Apache-2.0やLlamaコミュニティライセンスなどの下で無料でダウンロードできます。ハードウェアと電気代は自己負担で、ライセンスによっては利用と再配布に条件が付きます。
無検閲モデルはどこでダウンロードできますか?
Hugging Faceが重みとモデルカードの主なホストで、Ollamaは多くをすぐに実行できるタグとして配布しています。ModelScopeは代替のホストです。Abliter.cnとAbliteration.orgは、モデルの発見を助けるインデックスで、ファイルをホストしません。
無検閲AIをローカルで動かせますか?
はい。GGUFファイルまたはOllamaのタグをダウンロードして、Ollama、LM Studio、llama.cppで実行します。7〜9Bのモデルには約8 GBのメモリが必要で、24〜31Bのモデルには、Q4でおよそ20〜28 GBが必要です。
Hereticとは何ですか?
Hereticは、Philipp Emanuel Weidmannによるオープンソースのツールで、モデルをできるだけ変えずに拒否を取り除く設定を自動で探索します。2026-11-01に公開されたバージョン2.0で、任意ランク・アブレーション(ARA)がデフォルトの手法になりました。
アブリタレーションはAIの安全対策をすべて取り除きますか?
いいえ。拒否の挙動を対象にしますが、すべての拒否が消えることは保証しません。公開されているテストでは拒否が残っており、特に元の研究では、真実性のベンチマークで、品質が低下することがあります。
無検閲モデルは危険ですか?
悪用される可能性があり、シェル、ファイル、Webなどのツールに接続すると、リスクが高まります。通常のチャット画面では、テキストを生成するだけです。エージェントには、サンドボックス、最小権限、人による承認、ログを使ってください。
ヨーロッパで無検閲AIを使うのは合法ですか?
所持、配布、使用によって異なります。モデルを所有することと、それを使って犯罪を行うことは別です。EU AI法は主に提供者に義務を課しており、Llamaなどのライセンスは契約上の制限を加えます。これは法的助言ではありません。個別の事情については弁護士にご相談ください。
無検閲モデルを使えるローカルアプリはどれですか?
モデルを選べるアプリならどれでも使えます。LM Studio、Open WebUI、SillyTavern、AnythingLLM、Msty、KoboldCpp、Cline、n8nが、OllamaまたはOpenAI互換の接続を通じて対応します。お使いのバージョンがカスタムモデルを受け付けるか確認してください。