Fatos rápidos
- Artigo central: Arditi et al., "Refusal in Language Models Is Mediated by a Single Direction" (arXiv 2406.11717, 2024), 13 modelos de chat de 1,8B a 72B de parâmetros.
- Heretic: criado por Philipp Emanuel Weidmann (p-e-w); a 2.0.0 foi publicada em 2026-11-01 e a 2.1.0 em 2026-11-08; usa o Optuna para buscar parâmetros e pontua recusas e divergência KL.
- Contagens de tags no Hugging Face (2026-11-13): abliterated 13.279; uncensored 16.629; heretic 7.058 repositórios, incluindo quants e duplicatas.
- Tamanhos típicos (GGUF Q4_K_M): 8B cerca de 5 GB; 12B cerca de 7,6 GB; 24B cerca de 14 GB; 27B cerca de 16,6 GB; 31B cerca de 18,7 GB.
- Estimativa de memória: um modelo Q4 de 31B pede cerca de 22-24 GB de VRAM ou 32 GB de RAM; são estimativas, não medições.
- Formatos de arquivo de menor risco: prefira safetensors e GGUF a arquivos .bin, .pt ou .ckpt baseados em pickle.
O que são modelos de IA sem censura?
Duas pessoas baixam o mesmo modelo de pesos abertos. A primeira faz uma pergunta no limite e recebe uma recusa educada. A segunda baixou uma cópia modificada do mesmo modelo base, faz a mesma pergunta e recebe uma resposta. Mesma arquitetura, mesmo conhecimento, comportamento diferente. Essa diferença é toda a história da IA sem censura.
Isso é possível porque modelos de pesos abertos são arquivos. Um chatbot hospedado mantém pesos, prompt de sistema e filtros nos servidores de outra pessoa, então você só pode conversar com ele. Um modelo de pesos abertos entrega os pesos. Qualquer pessoa pode fazer fine-tuning, mesclar, quantizar ou editar esses pesos e publicar o resultado. O comportamento de recusa é algo que o modelo aprendeu, então pode ser desaprendido ou suprimido.
A IA local torna isso prático. Um modelo de 12B ou 24B hoje roda em um notebook ou em uma única GPU, offline, dentro de apps em que você já confia. As páginas de tags do Hugging Face listavam em 2026-11-13 13.279 repositórios com a tag abliterated, 16.629 com uncensored e 7.058 com heretic, embora essas contagens incluam quantizações e duplicatas. Existem também dois índices especializados: o abliter.cn mostrava 921 modelos de 25.796 repositórios analisados, e o abliteration.org descreve um catálogo com mais de 19.000 modelos. Eles usam regras de inclusão diferentes, então os números não descrevem a mesma coisa.
O tema também está nas notícias. O Heretic 2.0 foi lançado em 2026-11-01 e substituiu a técnica clássica de direção única como padrão da ferramenta. A WIRED publicou um perfil da comunidade em 2026-11-10 (só conseguimos ler republicações dele, então o citamos como reportado). Um modelo Gemma 4 31B modificado, publicado em 2026-11-05, afirma uma grande queda nas recusas; examinamos seus números abaixo.
Este guia começa pelo fenômeno e depois explica os termos, a ciência e as ferramentas. Uma ideia o atravessa: pense nesses modelos como um componente intercambiável em apps locais. O app oferece documentos, voz, agentes e uma interface utilizável; o modelo decide o que vai responder. Combiná-los dá uma flexibilidade que nenhum serviço hospedado oferece, e também remove a rede de segurança que um serviço hospedado proporciona.
📍 Em uma frase
Modelos de IA sem censura são modelos de linguagem de pesos abertos modificados, por fine-tuning ou por edição dos pesos, para que recusem menos pedidos do que o original.
💬 Em termos simples
Pense em um modelo como um arquivo seu. Alguém pode editar esse arquivo para que ele diga sim com mais frequência, e você pode executar o arquivo editado nos seus próprios apps.
O que "sem censura" realmente significa?
As palavras são usadas de forma solta, e é assim que as pessoas acabam baixando algo que não se comporta como anunciado. Veja o que cada termo significa tecnicamente.
📍 Em uma frase
"Sem censura" descreve um resultado (menos recusas), enquanto "abliterado" descreve um método (edição de pesos), então um modelo pode ser um sem ser o outro.
💬 Em termos simples
Sem censura é o que você espera, abliterado é como foi feito, e jailbroken é um truque aplicado a um modelo inalterado.
Termo | O que significa | Garantia técnica? |
|---|---|---|
| Uncensored | Menos recusas de conteúdo, ou nenhuma | Não |
| Unfiltered | Filtragem de saída menos restritiva | Não |
| Unaligned | Treino de alinhamento reduzido ou diferente | Não |
| Abliterated | Pesos editados com técnica de ablação | Só o método |
| Jailbroken | Comportamento contornado por prompt | Não, pesos intactos |
| Unrestricted | Termo de marketing | Não |
O jailbreak é o ponto fora da curva: ele muda o prompt, não o modelo, então a próxima conversa começa limpa. Os outros termos descrevem algo feito nos pesos.
⚠️Aviso: Um modelo com "uncensored" no nome não perdeu necessariamente suas recusas. Verifique se o model card mostra uma taxa de recusa medida e como ela foi medida.
💡Dica: Duas coisas diferentes costumam ser confundidas: um modelo direcionável (Hermes, Dolphin) deixa o prompt de sistema definir o comportamento, enquanto um modelo abliterado teve o comportamento de recusa removido dos pesos.
Como os modelos de IA aprendem a recusar pedidos
O pré-treinamento ensina o modelo a prever texto a partir de um corpus enorme. Ele produz um sistema capaz, mas sem direção, que continua quase qualquer coisa. O ajuste por instruções e o fine-tuning supervisionado (SFT) então o treinam com conversas de exemplo para que responda perguntas em um formato útil.
O treinamento por preferências adiciona a camada de segurança. No RLHF (aprendizado por reforço com feedback humano), avaliadores humanos comparam respostas, um modelo de recompensa aprende suas preferências e o modelo é otimizado nessa direção. O DPO (otimização direta de preferências) chega a um resultado semelhante sem um modelo de recompensa separado. Conjuntos de dados de segurança associam pedidos nocivos a recusas, e assim o modelo aprende que certos tipos de pedido devem ser recusados: isso é o treinamento de recusa.
Onde esse comportamento mora? Em dois lugares. Um prompt de sistema é texto adicionado no início em tempo de execução, e você pode alterá-lo. O comportamento nos pesos do modelo é embutido durante o treinamento, e você não consegue mudá-lo sem mexer nos pesos. É por isso que só o prompt de sistema às vezes não faz um modelo responder, e por que edições nos pesos conseguem.
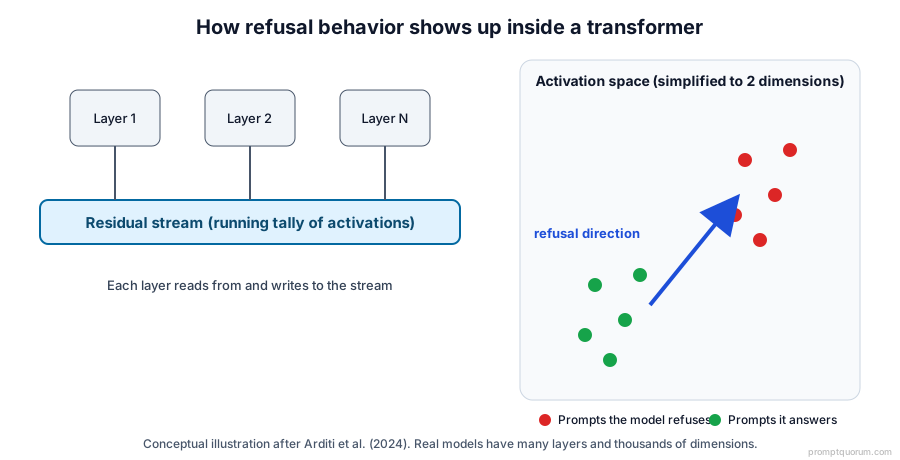
O diagrama mostra a ideia que torna a abliteração possível. Dentro de um transformer, cada camada lê de um registro compartilhado e escreve nele, chamado fluxo residual. Pesquisas sugerem que, no caso das recusas, boa parte do sinal está ao longo de uma única direção nesse fluxo.
O que é abliteração?
A base científica é Arditi et al. (2024), "Refusal in Language Models Is Mediated by a Single Direction" (arXiv 2406.11717). Os autores testaram 13 modelos de chat abertos entre 1,8B e 72B de parâmetros. A conclusão: nesses modelos, a recusa é mediada por uma única direção no fluxo residual.
Como a direção é encontrada. Execute o modelo em um conjunto de prompts nocivos e em um conjunto de prompts inofensivos, registre as ativações internas em uma camada e posição de token escolhidas e calcule a diferença das duas médias. Esse vetor de diferença de médias é a direção de recusa candidata.
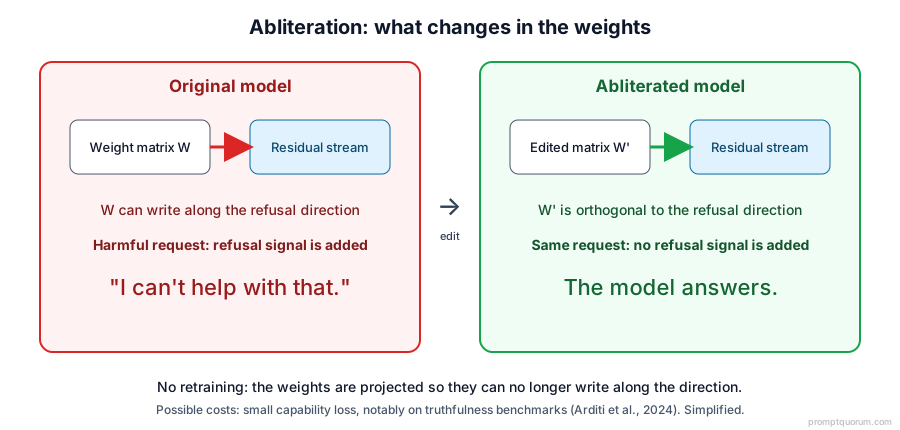
Como ela é removida. A ablação direcional projeta essa direção para fora das ativações em tempo de execução. A ortogonalização de pesos obtém o mesmo efeito de forma permanente: as matrizes de pesos que escrevem no fluxo residual são modificadas para não poderem mais escrever ao longo da direção. O modelo editado não precisa de retreinamento, e seu arquivo parece o de qualquer outro modelo.
O que se perde. Os autores relatam pequenas quedas de capacidade na maioria dos benchmarks, com exceção do TruthfulQA: ele caiu de forma consistente, cerca de 1 a 3,5 pontos. Eles também descrevem seu método de seleção de direção como heurístico. O guia prático de Maxime Labonne constatou que a abliteração reduziu todos os benchmarks que ele mediu, que uma etapa de "cura" com DPO recuperou a maior parte, mas não tudo, e que escolher a camada exige julgamento.
Um aviso sobre os números. A empresa de segurança Alice publicou um relatório que testou cinco modelos e relatou 98,0% de conformidade após a abliteração (539 de 550 prompts) contra 5,8% antes, e um post de blog que relata 96-100% em seis famílias de modelos. Esses números são reportados pela própria empresa, foram avaliados por um LLM como juiz, não passaram por revisão por pares e medem a disposição de responder, não o ganho real de capacidade. Trate-os como um dado, não como prova.
📍 Em uma frase
A abliteração estima uma direção de recusa a partir de diferenças de ativação e edita os pesos para que o modelo não possa mais escrever ao longo dela.
💬 Em termos simples
Se recusar é um botão dentro do modelo, a abliteração encontra o botão e o remove, sem ensinar nada de novo ao modelo.
Heretic 2.0: a próxima geração da abliteração
Quem e o quê. O Heretic é uma ferramenta de linha de comando de código aberto criada por Philipp Emanuel Weidmann (usuário p-e-w no GitHub). Em vez de pedir a um humano que escolha camadas e intensidades, ela automatiza a busca.
A abordagem original. O Heretic usa o Optuna, uma biblioteca de otimização de hiperparâmetros com amostrador TPE, para testar muitas configurações de abliteração. Scorers plugáveis avaliam cada tentativa. Por padrão, ele conta recusas com um scorer de palavras-chave e mede a divergência KL em relação ao modelo original em prompts inofensivos, de modo que a busca procura configurações que removam recusas alterando todo o resto o mínimo possível. Os modificadores são os componentes que de fato editam os pesos.
O que mudou na 2.0. A versão 2.0.0 foi publicada em 2026-11-01 (a 2.1.0 veio em 2026-11-08). O modificador padrão agora é a Arbitrary-Rank Ablation (ARA); a ablação direcional clássica, com opções de abliteração projetada e preservação de norma, continua disponível. A versão também traz um sistema de plugins, operação headless e um scorer de recusa baseado em BERT como plugin (o scorer padrão continua sendo o de palavras-chave). Arquivos de configuração do Heretic 1.x não funcionam na 2.x.
O que é a ARA. Segundo o pull request do próprio autor, a ARA não usa direções de recusa. Ela aprende edições de matriz por módulo com um otimizador L-BFGS, com três objetivos: não alterar as saídas para prompts inofensivos, fazer as saídas para prompts nocivos se parecerem com as dos inofensivos e afastá-las das antigas saídas nocivas. Uma única direção é uma edição de posto um; a ARA permite edições de posto mais alto, e por isso pode capturar um comportamento de recusa que não é unidimensional. A descrição completa ainda é apresentada como um preprint "em breve", então as afirmações de qualidade são do próprio autor e não foram verificadas de forma independente.
Hardware e trade-offs. A ferramenta carrega o modelo completo e executa muitas tentativas, então você precisa de memória suficiente para rodar o modelo que está modificando, além de tempo. Os trade-offs de qualidade seguem o padrão de outros métodos: um estudo comparativo de quatro ferramentas em 16 modelos (Young, arXiv 2512.13655, resumo lido) relata variações no GSM8K de +1,5 a -18,8 pontos e valores de KL do Heretic de 0,04 a 1,65, ou seja, os resultados dependem muito do modelo.
⚠️Aviso: Vários detalhes da 2.0 aparecem em posts de blog de terceiros que não conseguimos confirmar no repositório. Afirmamos apenas o que o repositório, as notas de versão ou o pull request do autor dizem, e identificamos o restante como reportado.
Outras formas de criar modelos sem censura
A abliteração não é o único caminho. A tabela compara as principais abordagens. A linha de mesclagem é deliberadamente cautelosa: não encontramos nenhuma fonte primária que documente mesclas como método para remover recusas.
Método | O que altera | Exige treino? | Principal trade-off |
|---|---|---|---|
| Fine-tuning sem censura | Pesos, via novos dados | Sim | Computação e qualidade dos dados |
| Abliteração | Pesos, uma direção | Não | Alguma perda de capacidade |
| Abliteração automatizada | Pesos, configs buscadas | Não | Tempo de tentativas e memória |
| Mesclagem de modelos | Combina vários modelos | Não | Não verificado para recusas |
| Otimização de preferências | Pesos, via preferências | Sim | Exige dados pareados |
A abordagem de fine-tuning mais conhecida é a linha Dolphin, de Eric Hartford, que filtra respostas no estilo de recusa dos dados de treinamento e depende do prompt de sistema para o comportamento. O fine-tuning também pode ser feito com adaptadores LoRA, e pesquisas publicadas relatam que o treinamento de segurança pode ser desfeito com pequenas quantidades de fine-tuning nocivo (Qi et al., Lermen et al.). Variantes mais novas de edição de pesos, como a abliteração biprojetada com preservação de norma, tentam reduzir danos colaterais, e a "cura" com DPO é usada para recuperar qualidade depois de uma edição.
As famílias mais importantes de modelos de IA sem censura
Dolphin (cognitivecomputations e a organização mais nova, dphn) é a linha de fine-tuning mais conhecida. A entrada verificada atual é o Dolphin-Mistral-24B-Venice-Edition. O card diz que o prompt de sistema define o comportamento, ou seja, ele é direcionável, e não garantidamente sem recusas.
Hermes (NousResearch) não é uma família sem censura. Os modelos Hermes 4 têm alinhamento neutro e são direcionáveis. O RefusalBench da própria Nous, conforme relatado no card do Hermes 4.3 36B, mostra que o modelo respondeu a cerca de 72-75% dos prompts de teste, ou seja, cerca de um quarto ainda é recusado. Não classifique todo modelo Hermes como sem censura.
As variantes abliteradas do Qwen dominam os downloads. A entrada verificada mais baixada é a Huihui-Qwen3.8-27B-abliterated, com cerca de 4 milhões de downloads. Busca: Qwen abliterated no Hugging Face.
As variantes abliteradas do Gemma são a área mais nova. Modelos Gemma 4 modificados aparecem com abliteração simples e com Heretic e ARA. Busca: Gemma abliterated. Um deles, um modelo Gemma 4 31B ARA, afirma uma grande redução de recusas, examinada abaixo.
As variantes abliteradas do Llama são em sua maioria mais antigas. Nada mais novo que Llama 3.1 e 3.3 tem grandes números de downloads na nossa checagem de 2026-11-13, e a entrada de 8B mais baixada é de 2024. Busca: Llama abliterated.
Mistral, DeepSeek e GLM. Existe uma abliteração do Mistral Small 3.2 24B. Para DeepSeek e GLM, existem versões abliteradas dos modelos mais novos, mas com cerca de 284 GB e 321 GB, o que está fora do alcance de hardware de consumo; só um destilado mais antigo do DeepSeek R1 em 32B é viável.
Uma leitura crítica da afirmação do Gemma 4 31B. O model card relata recusas caindo de 99 em 100 prompts para 28 em 100 (Heretic v2.0.0 ARA, divergência KL de 0,0845). Isso é uma redução relativa de 72%, e também significa que 28 em 100 prompts de teste ainda acionaram o detector. O detector é uma lista de cerca de 34 palavras-chave como "sorry" e "illegal", aplicada a respostas truncadas em 100 tokens, então uma resposta útil com um aviso conta como recusa e uma não resposta sem essas palavras conta como conformidade. O conjunto de teste tem 100 prompts de um único dataset, o original marcou 99/100 e o valor de KL é medido apenas em prompts inofensivos, então não diz nada sobre capacidade. O card promete reprodutibilidade, mas o próprio arquivo de reprodução avisa que foi usada uma build local do Heretic sem commit. Não encontramos nenhuma avaliação independente. Outro repack de 31B sobre a mesma base relata 10/100 com KL 0,054, mas resultados de autores, execuções e configurações diferentes não são comparáveis.
💡Dica: Leia números de recusa como números de benchmark: pergunte o que contou como recusa, quantos prompts, qual o tamanho máximo permitido da resposta e quem executou o teste.
Onde baixar modelos de IA sem censura?
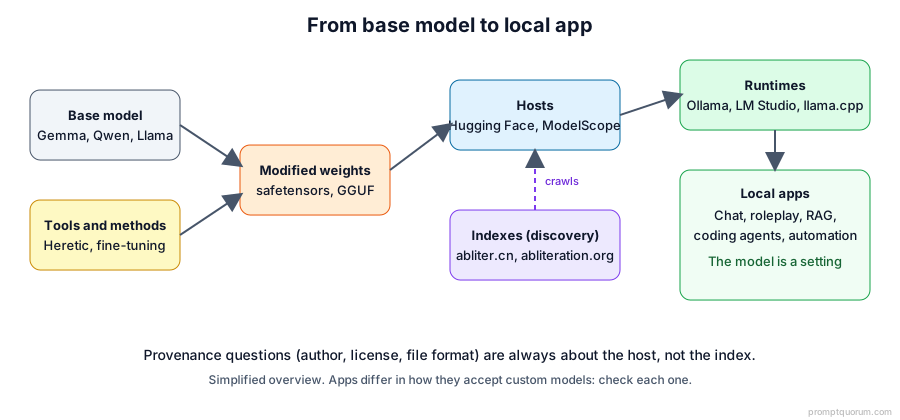
Uma plataforma de hospedagem armazena e serve os próprios arquivos. Um índice especializado apenas rastreia plataformas de hospedagem e acrescenta uma camada de descoberta. Um índice pode ajudar a achar candidatos, mas o arquivo que você baixa ainda vem do host, então as questões de procedência sempre dizem respeito ao host e ao autor.
Plataforma | Função | Site |
|---|---|---|
| Hugging Face | Pesos e model cards | huggingface.co |
| Ollama | Executar e distribuir localmente | ollama.com |
| ModelScope | Repositório alternativo | modelscope.cn |
| GitHub | Ferramentas e código-fonte | github.com |
| Abliter.cn | Índice de descoberta de modelos | abliter.cn |
| Abliteration.org | Catálogo e análises | abliteration.org |
Verifique antes de executar. Prefira arquivos safetensors e GGUF. Formatos baseados em pickle (.bin, .pt, .pkl, .ckpt) podem executar código ao serem carregados, e a documentação do Hugging Face recomenda autores confiáveis e safetensors. Nunca ative trust_remote_code em um repositório desconhecido. Confira se o model card nomeia o modelo base e o método e se a cadeia do modelo base leva ao repositório oficial, compare os hashes dos arquivos quando o autor os publicar e leia a licença. O Hugging Face executa uma varredura de malware em arquivos de repositório com menos de 2 GB, então arquivos de pesos grandes podem ficar fora dela (nossa leitura da documentação). Cópias quantizadas de quantizadores conhecidos atestam o formato do arquivo, não as afirmações do autor original. Namespaces do Ollama como huihui_ai e richardyoung são uploads de usuários, não modelos verificados pela biblioteca.
Quais modelos sem censura valem o download?
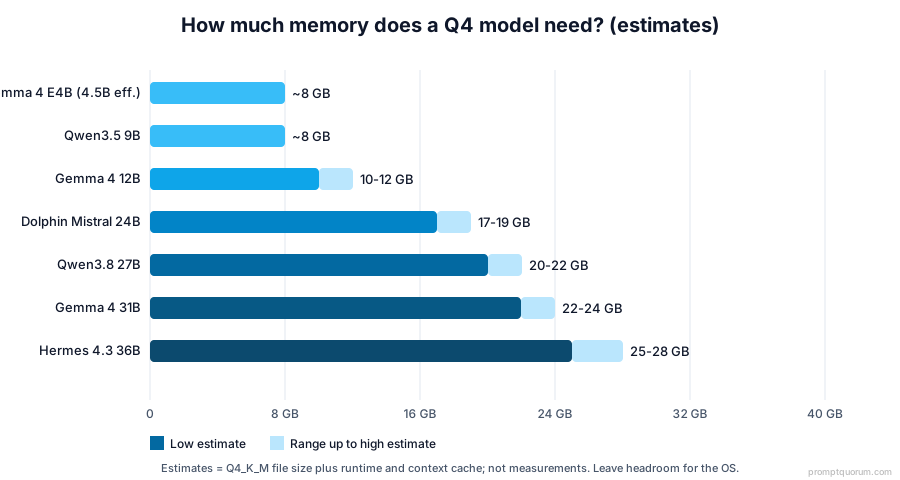
Verificamos dez repositórios atuais em 2026-11-13 na API do Hugging Face e nos model cards, e não em artigos antigos. Os tamanhos são os de arquivos GGUF Q4_K_M quando o repositório os publica; os valores de memória são estimativas nossas (tamanho do arquivo mais runtime e cache), não medições. Contagens de downloads e datas mudam o tempo todo, então esta tabela é um retrato do momento e deve ser atualizada independentemente do artigo.
Gemma 4 31B ARA Heretic
- Base:
- Gemma 4 31B-it
- Método:
- Heretic 2.0 ARA
- Params:
- 30.7B
- Tam. Q4:
- 18.7 GB
- Memória (est.):
- 22-24 GB VRAM
- Contexto:
- 262K
- Licença:
- Apache-2.0
- Limites conhecidos:
- Sem teste independente
Gemma 4 E4B Heretic
- Base:
- Gemma 4 E4B-it
- Método:
- Heretic ARA
- Params:
- 4.5B ef.
- Tam. Q4:
- 5.3 GB
- Memória (est.):
- ~8 GB
- Contexto:
- 131K
- Licença:
- Apache-2.0
- Limites conhecidos:
- Testes do próprio repackager
Huihui Gemma 4 12B
- Base:
- Gemma 4 12B-it
- Método:
- Abliteração
- Params:
- 12.0B
- Tam. Q4:
- 7.6 GB
- Memória (est.):
- 10-12 GB
- Contexto:
- 128-256K
- Licença:
- Apache-2.0
- Limites conhecidos:
- Card: "proof-of-concept"
Huihui Qwen3.8 27B
- Base:
- Qwen3.8 27B
- Método:
- Abliteração
- Params:
- 27.3B
- Tam. Q4:
- 16.6 GB
- Memória (est.):
- 20-22 GB
- Contexto:
- 262K
- Licença:
- Apache-2.0
- Limites conhecidos:
- Pode incluir avisos
Huihui Qwen3.5 9B
- Base:
- Qwen3.5 9B
- Método:
- Abliteração
- Params:
- 9.7B
- Tam. Q4:
- 5.6 GB
- Memória (est.):
- ~8 GB
- Contexto:
- 262K
- Licença:
- Apache-2.0
- Limites conhecidos:
- Sem dados de recusa no card
Dolphin Mistral 24B Venice
- Base:
- Mistral Small 24B
- Método:
- Fine-tune
- Params:
- 24.0B
- Tam. Q4:
- 14.3 GB
- Memória (est.):
- 17-19 GB
- Contexto:
- 131K
- Licença:
- Apache-2.0
- Limites conhecidos:
- O prompt define o comportamento
Hermes 4.3 36B
- Base:
- Seed-OSS 36B
- Método:
- Pós-treinamento
- Params:
- 36.2B
- Tam. Q4:
- 21.8 GB
- Memória (est.):
- 25-28 GB
- Contexto:
- 524K
- Licença:
- Apache-2.0
- Limites conhecidos:
- Não é sem censura
Hermes 4 14B
- Base:
- Qwen3 14B
- Método:
- Pós-treinamento
- Params:
- 14.8B
- Tam. Q4:
- 9.0 GB
- Memória (est.):
- 11-12 GB
- Contexto:
- 41K
- Licença:
- Apache-2.0
- Limites conhecidos:
- Não é sem censura
Llama 3.1 8B abliterated
- Base:
- Llama 3.1 8B
- Método:
- Abliteração
- Params:
- 8.0B
- Tam. Q4:
- 4.9 GB
- Memória (est.):
- 7-8 GB
- Contexto:
- 131K
- Licença:
- Termos do Llama 3.1
- Limites conhecidos:
- Datado, 2024
R1 Distill Qwen 32B
- Base:
- R1-Distill-Qwen-32B
- Método:
- Abliteração
- Params:
- 32.8B
- Tam. Q4:
- 19.9 GB
- Memória (est.):
- 23-26 GB
- Contexto:
- 131K
- Licença:
- Sem tag
- Limites conhecidos:
- Datado, 2025, sem tag de licença
Como ler a tabela. A abliteração do Qwen3.8 27B tem de longe mais downloads (cerca de 4 milhões), mas seu card diz que a saída ainda pode trazer um pequeno aviso, um lembrete de que "abliterado" não significa "responde qualquer coisa". Para máquinas pequenas, as entradas Gemma 4 E4B e Qwen3.5 9B cabem em cerca de 8 GB. Existem tags verificadas do Ollama para alguns: ollama run huihui_ai/gemma-4-abliterated:12b, ollama run huihui_ai/qwen3.5-abliterated:9b e huihui_ai/Qwen3.8-abliterated (cerca de 18 GB); o modelo Gemma 4 31B tem uma página no Ollama sob o namespace do autor. O Hermes 4.3 36B aparece para que você veja um modelo direcionável, de alinhamento neutro, ao lado dos modificados: o benchmark da própria Nous deixa cerca de um quarto dos prompts recusados. Os termos do Llama 3.1 exigem um aviso "Built with Llama" e o prefixo "Llama" nos nomes de modelos derivados, e o destilado R1 não tem tag de licença, então não presuma uma. Existem também uma abliteração do Mistral Small 3.2 (24B) e uma do Llama 3.3 70B (cerca de 42,5 GB em Q4, para máquinas da classe de 64 GB), mas são datadas.
Use modelos sem censura dentro de apps locais
O motivo pelo qual isso importa é a arquitetura da IA local. A maioria dos apps locais não traz um modelo fixo. Eles se conectam a um backend, geralmente Ollama, llama.cpp ou um servidor compatível com OpenAI, ou carregam arquivos GGUF que você escolhe.
Nossas próprias análises confirmam o padrão em várias categorias. O SillyTavern se conecta ao KoboldCpp, ao text-generation-webui, ao Ollama ou ao LM Studio. O Open WebUI funciona como interface para o Ollama ou qualquer API compatível com OpenAI. O LM Studio executa modelos GGUF com um navegador do Hugging Face embutido. AnythingLLM, Msty e Cline se conectam ao Ollama ou ao LM Studio. O n8n tem um nó dedicado ao Ollama, e o KoboldCpp executa arquivos GGUF diretamente. Quando o modelo é uma configuração, você pode trocar um modelo neutro por um sem restrições conforme a tarefa.
O que você ganha. Você obtém os recursos do app e o modelo da sua escolha, offline, sem um provedor hospedado lendo a conversa. A tabela mostra como isso se dá por categoria. Confirme que a versão do app que você usa aceita modelos personalizados antes de depender dela; esta lista é um ponto de partida, não uma garantia.
📍 Em uma frase
Como a maioria dos apps locais trata o modelo como uma configuração intercambiável, combiná-los com um modelo sem restrições muda o que o app inteiro fará, sem mudar o app.
💬 Em termos simples
O app é o carro e o modelo é o motorista: coloque um motorista que diz sim com mais frequência e o mesmo carro vai a lugares aonde antes não ia.
Categoria de app | Apps de exemplo | Ganho sem restrições |
|---|---|---|
| Clientes de chat | LM Studio, Msty, Open WebUI | Menos perguntas recusadas |
| Roleplay e ficção | SillyTavern, KoboldCpp | Temas sombrios, sem recusa no meio da cena |
| RAG de documentos | AnythingLLM, Open WebUI | A inferência fica no seu dispositivo |
| Agentes de código | Cline, Aider, Continue | Ajuda com código de teste de segurança |
| Automação | n8n com nó Ollama | Pipelines próprios, camada de política própria |
| Agentes pessoais | Hermes Agent, nanobot | Mais autonomia, exige salvaguardas |
Exemplos concretos da flexibilidade extra. Um romancista pode executar um modelo abliterado ou direcionável por trás do SillyTavern para uma ficção moralmente complexa, sem recusas no meio da cena, o que nosso guia de escrita criativa aborda em profundidade. Um advogado, jornalista ou pesquisador pode apontar o AnythingLLM para uma pasta de documentos sensíveis e fazer perguntas sobre conteúdo que um modelo hospedado poderia se recusar a discutir, com a inferência rodando na sua máquina. Verifique as configurações de telemetria e de atualização de cada app, pois apps e downloads de modelos ainda podem usar a rede. Um profissional de segurança pode usar um agente de código com um modelo que não hesita diante de perguntas próximas a exploits dentro de um ambiente de teste autorizado. Um desenvolvedor pode montar um fluxo no n8n cujo modelo é uma configuração e trocá-lo sem reescrever nada. Um usuário avançado pode executar dois modelos em um mesmo app, um neutro para o dia a dia e um sem restrições para as tarefas que o primeiro recusa.
⚠️Aviso: A flexibilidade tem um preço. Em uma janela de chat, um modelo sem restrições só produz texto. Conectado a um agente com acesso a arquivos, shell ou web, o mesmo modelo pode agir sobre o que gera. Combine essas configurações com sandbox, privilégio mínimo e aprovação humana.
💡Dica: Não sabe qual app consegue carregar seu modelo ou cabe no seu hardware? Filtre o Diretório de software de LLM local por caso de uso, sistema operacional e RAM, ou descreva sua máquina ao Ask Hans.
Como executar IA sem censura localmente
O Ollama (ollama.com) é o caminho mais simples para quem usa a linha de comando: baixe um modelo pelo nome e ele serve uma API que muitos apps entendem. O LM Studio (lmstudio.ai) é o caminho gráfico, com um navegador do Hugging Face embutido e um servidor local compatível com OpenAI. O llama.cpp (github.com/ggml-org/llama.cpp) é o motor por baixo de muitas dessas ferramentas e executa arquivos GGUF diretamente. O Transformers (huggingface.co/docs/transformers) carrega pesos safetensors em precisão total em Python, o que serve para pesquisa e para quem pretende avaliar ou modificar modelos.
GGUF e quantização. GGUF é o formato de arquivo único usado por ferramentas baseadas no llama.cpp. A quantização armazena os pesos com menos bits: Q4_K_M é o meio-termo usual, com cerca de um quarto do tamanho em precisão total e um custo modesto de qualidade. Quants menores economizam memória, mas podem prejudicar o raciocínio e o seguimento de instruções, então teste o arquivo específico que você usa.
Hardware. No Apple Silicon, a memória unificada é compartilhada entre CPU e GPU, então um Mac de 32 GB comporta um modelo Q4 de cerca de 24-27B de parâmetros mais o contexto; deixe vários gigabytes para o sistema. Em GPUs NVIDIA, o modelo deve caber na VRAM: uma placa de 24 GB serve para os modelos de 24-31B acima, e uma de 8 GB serve para modelos de 4-9B. Se o modelo não cabe, camadas vão para a RAM do sistema e a velocidade cai muito. Para números exatos, veja quanta VRAM um LLM local precisa.
Operação offline. Com os pesos no disco, nenhuma dessas ferramentas precisa de internet para gerar texto. Esse é o principal argumento de privacidade, e também o motivo de nenhum provedor poder impor regras de uso a uma cópia local.
Dá para criar o seu próprio modelo abliterado?
Conceitualmente, sim, e é mais acessível do que já foi. Descrevemos o fluxo apenas em alto nível.
- 1Escolha um modelo de pesos abertos
Why it matters: Escolha um cujo tamanho caiba na sua memória, porque a ferramenta precisa carregá-lo. - 2Verifique a licença
Why it matters: Algumas licenças e políticas de uso restringem contornar filtros de segurança (os Gemma Terms anteriores faziam isso); leia a licença exata do modelo base antes de modificar ou redistribuir. - 3Verifique a compatibilidade de arquitetura
Why it matters: As ferramentas suportam arquiteturas específicas; um modelo novo pode ainda não funcionar. - 4Escolha um método
Why it matters: Ablação direcional clássica ou uma ferramenta automatizada como o Heretic com ARA. - 5Execute a modificação
Why it matters: Ferramentas automatizadas buscam muitas configurações; métodos clássicos dependem da sua escolha de camada. - 6Avalie o resultado
Why it matters: Meça recusas e perda de qualidade em prompts nos quais a ferramenta não fez ajustes. - 7Compare com o original
Why it matters: A capacidade pode cair mesmo quando as recusas diminuem. - 8Documente e publique com responsabilidade
Why it matters: Informe o método, os números, o modelo base e a cadeia de licenças.
Quais são os riscos da IA sem censura?
Descrevemos os riscos no nível necessário para entendê-los e não damos nenhum detalhe operacional.
- Crime cibernético e ajuda com malware. Um modelo com menos recusas reduz o esforço necessário para obter ajuda na escrita de código malicioso. Se isso acrescenta capacidade além do que já está disponível é uma questão em debate.
- Phishing e fraude. Texto de golpe fluente e personalizado é fácil para qualquer modelo capaz; as recusas eram um ponto de atrito, e ele é mais fraco aqui.
- Informações biológicas e químicas perigosas. Esta é a preocupação de maior risco no debate de políticas. Os números de taxa de recusa reportados medem a disposição de responder, não o ganho real, então não provam nem perigo nem segurança.
- Uso indevido relacionado a armas. Vale a mesma cautela: conformidade medida não é capacidade demonstrada.
- Assédio e conteúdo abusivo. Modelos locais podem gerar material abusivo em escala. Material de abuso sexual infantil é crime nas jurisdições que conhecemos. Na Alemanha, o § 184b StGB também abrange representações realistas, então presuma que material realista gerado por IA pode ser punível. Não gere, não peça nem armazene esse material.
- Desinformação. Menos recusas também significa menos barreiras para produzir conteúdo falso persuasivo.
- Privacidade e segurança de dados. A inferência local mantém seus prompts na sua máquina, mas os downloads são um risco separado: repositórios desconhecidos podem conter arquivos maliciosos, e os apps ainda podem fazer chamadas de rede.
- Arquivos de modelo maliciosos. Formatos baseados em pickle podem executar código ao serem carregados, e a verificação não é uma garantia (veja a documentação do Hugging Face sobre varredura de pickle). Use safetensors ou GGUF de autores conhecidos.
- Agentes autônomos com acesso a ferramentas. Esta é a maior mudança: um modelo sem restrições conectado a arquivos, a um shell ou à web pode agir. A OWASP lista a injeção de prompt (LLM01) e a agência excessiva (LLM06) entre os principais riscos de aplicações com LLM.
Por que algumas pessoas são contra as barreiras de proteção da IA?
Os argumentos mais fortes a favor de modelos menos restritivos merecem ser expostos de forma justa.
- Liberdade de expressão. Defensores argumentam que uma ferramenta não deveria decidir o que um adulto pode ler ou escrever.
- Pesquisa científica. Estudar o comportamento dos modelos, inclusive as recusas, exige modelos que possam ser modificados; a própria pesquisa sobre abliteração depende de pesos abertos.
- Testes de segurança. Red teams precisam de modelos que discutam ataques para testar as defesas.
- Escrita criativa. A ficção precisa de vilões, violência e complexidade moral que modelos excessivamente cautelosos podem achatar.
- Autonomia do usuário. Alguns argumentam que o usuário, e não o fornecedor, deveria definir os limites de uma ferramenta local.
- Privacidade e execução local. O material sensível é processado na sua máquina, então nenhum provedor hospedado recebe o prompt; confira as configurações de telemetria de cada app.
- Evitar restrições excessivas. Críticos de modelos comerciais citam recusas de perguntas inofensivas. O ensaio de Eric Hartford sobre modelos sem censura faz esse argumento.
Por que as salvaguardas de IA são importantes?
Os contra-argumentos são igualmente reais. As salvaguardas reduzem a chance de um modelo ajudar em danos graves, protegem usuários vulneráveis e tornam defensável a implantação em produtos.
A distinção-chave é entre um modelo que gera texto e um agente que pode executar comandos, ler arquivos, navegar na web ou interagir com outros sistemas. Se um modelo de chat escreve algo nocivo, uma pessoa ainda precisa agir com base nisso. Se um agente com o mesmo modelo age, a distância entre saída e consequência desaparece.
É difícil tornar as salvaguardas de modelos abertos resistentes à adulteração: a pesquisa sobre abliteração apresentada acima mostra que uma única edição de pesos pode suprimir o comportamento de recusa. Esse é um argumento central a favor de proteções mais fortes no nível do modelo e de controles externos em torno dele.
Dá para criar suas próprias salvaguardas?
Sim. Como um modelo local não tem camada do lado do provedor, você adiciona as suas ao redor dele.
- Camadas de moderação. Execute um classificador como o Llama Guard ou o ShieldGemma nas entradas e saídas.
- Filtragem de entrada e saída. Bloqueie ou revise as categorias que você não quer no seu fluxo de trabalho.
- Sandbox. Execute agentes em contêineres ou máquinas virtuais sem acesso a nada que você não possa se dar ao luxo de perder.
- Restrições de permissão. Dê aos agentes o privilégio mínimo de que precisam: pastas somente leitura, sem rede, sem shell, a menos que seja necessário.
- Aprovação humana. Exija confirmação antes de um agente gravar arquivos, executar comandos ou enviar mensagens.
- Registro e monitoramento. Mantenha um registro do que o agente fez e por quê.
- Segurança de agentes. Trate todo documento, página web ou e-mail que o agente lê como entrada não confiável que pode conter instruções (injeção de prompt).
É legal baixar e usar modelos de IA sem censura?
Não há uma resposta única, e isto não é aconselhamento jurídico. As questões a separar são posse, distribuição e uso, e a resposta pode variar por país e conforme o uso dado ao modelo.
AI Act da UE. O Regulamento (UE) 2024/1689 impõe obrigações aos provedores de modelos de IA de uso geral, com uma isenção parcial para modelos de código aberto que não se aplica a modelos com risco sistêmico. As obrigações para modelos de IA de uso geral valem a partir de 2025-08-02, e os poderes de fiscalização da Comissão a partir de 2026-08-02. As diretrizes de 2025 da Comissão dizem que um modificador a jusante só se torna provedor acima de um limite indicativo de computação; entendemos que a abliteração fica muito abaixo disso, mas o critério não é vinculante. Não conseguimos confirmar pelo texto se o Digital Omnibus de 2026 alterou as datas para IA de uso geral, então consulte o texto vigente.
Posse versus uso. Ter um arquivo de modelo é diferente de usá-lo para cometer um delito. O direito penal se liga a atos específicos: produzir conteúdo proibido, fraude, assédio ou ferramentas feitas para crime informático. Analisamos apenas parcialmente as disposições alemãs, então não confie neste guia para elas.
Licenças e contratos. As licenças acrescentam regras sobre a lei. Os model cards do Gemma 4 listam Apache-2.0 e apontam para uma página de licença do Gemma 4, enquanto as gerações anteriores do Gemma usavam os Gemma Terms e a Prohibited Use Policy, que proíbem contornar filtros de segurança; confira a página de licença do modelo base exato. A licença do Llama 3.1 exige um aviso "Built with Llama" e um prefixo no nome dos modelos derivados, com uma política de uso aceitável que restringe usos mas, na nossa leitura, não tem cláusula explícita contra contorno. Os model cards do Qwen3.5 e do Qwen3.8 da tabela indicam Apache-2.0. Leia sempre a licença do modelo base, e não só a do derivado.
Proteção de dados e direitos autorais. Processar dados pessoais localmente continua sujeito à lei de proteção de dados, e as questões de direitos autorais sobre os dados de treinamento dos modelos subjacentes não estão resolvidas. Nenhuma delas muda quando as recusas são removidas.
A IA sem censura está se tornando parte permanente do ecossistema de IA?
Várias tendências indicam que sim. A modificação pela comunidade é grande e crescente: as contagens de tags do Hugging Face acima chegam a milhares de repositórios. As ferramentas estão ficando mais automáticas: o Heretic busca as configurações por você, e a ARA vai além de uma única direção. Novas técnicas para remover recusas continuarão surgindo, e também técnicas que tornam as salvaguardas mais difíceis de remover.
Outros desenvolvimentos puxam em direções diferentes: arquiteturas de segurança configuráveis que deixam quem implanta escolher uma política, serviços comerciais que oferecem modelos menos restritos, IA local que cada vez mais dá o controle ao usuário e uma regulação que ainda está tomando forma. Espere um debate contínuo sobre se pesos abertos poderão algum dia ser tornados resistentes à adulteração.
Conclusão. A IA de pesos abertos está dando aos usuários mais controle sobre o comportamento dos modelos, e a camada do app torna esse controle prático. Mas remover salvaguardas não remove a responsabilidade: ela é transferida para quem executa o modelo.
Fontes
- Arditi et al., Refusal in Language Models Is Mediated by a Single Direction — arXiv 2406.11717
- Repositório e releases do Heretic — github.com/p-e-w/heretic
- Maxime Labonne, Uncensor any LLM with abliteration — blog do Hugging Face
- Young, Comparative Analysis of LLM Abliteration Methods — arXiv 2512.13655 (apenas o resumo)
- Alice, One Pass to Break Them All (relatório de 2026) — PDF do relatório, pesquisa de fornecedor, sem revisão por pares
- WIRED, Tear Down Those Guardrails! (2026-11-10/11) — lemos apenas republicações e citamos como reportado
- Abliter.cn — abliter.cn; Abliteration.org — abliteration.org (o site retornou erro de acesso; usado o espelho do README)
- Páginas de tags do Hugging Face — abliterated, uncensored, heretic
- Biblioteca do Ollama — ollama.com/library
- Regulamento (UE) 2024/1689 (AI Act), art. 2(12) e 53; diretrizes da Comissão para modelos de IA de uso geral (2025)
- Gemma Prohibited Use Policy e Terms; licença e política de uso aceitável do Llama 3.1; model card do Qwen3
- Documentação do Hugging Face: Pickle Scanning e Malware Scanning; OWASP Top 10 for LLM Applications
Perguntas frequentes
O que é um modelo de IA sem censura?
Um modelo de IA sem censura é um modelo de linguagem de pesos abertos cujas recusas foram reduzidas ou removidas, por fine-tuning ou pela edição dos pesos. O resultado raramente é total: testes publicados de modelos modificados conhecidos ainda mostram recusas residuais.
Qual a diferença entre IA sem censura e abliterada?
Sem censura descreve um resultado, menos recusas. Abliterada descreve um método, a edição dos pesos para suprimir o comportamento de recusa. Um modelo abliterado costuma ser menos restrito, mas "uncensored" no nome de um modelo não prova nada sem um resultado medido.
Qual é o melhor LLM sem censura?
Não existe um único melhor. Para máquinas pequenas, abliterações de Gemma e Qwen de 4-9B cabem em cerca de 8 GB. Para GPUs de 24 GB, cabem modelos de 24-31B como o Dolphin Mistral 24B ou a abliteração do Qwen3.8 27B. Confira no model card as evidências, a licença e a atividade recente, e teste o modelo nas suas próprias tarefas.
Modelos de IA sem censura são gratuitos?
Os pesos geralmente podem ser baixados de graça, sob licenças como Apache-2.0 ou a licença comunitária do Llama. Você ainda paga pelo hardware e pela energia, e algumas licenças trazem condições de uso e redistribuição.
Onde posso baixar modelos sem censura?
O Hugging Face é o principal host de pesos e model cards, e o Ollama distribui muitos como tags prontas para executar. O ModelScope é um host alternativo. Abliter.cn e Abliteration.org são índices que ajudam a descobrir modelos, mas não hospedam os arquivos.
Posso executar IA sem censura localmente?
Sim. Baixe um arquivo GGUF ou uma tag do Ollama e execute no Ollama, no LM Studio ou no llama.cpp. Um modelo de 7-9B precisa de cerca de 8 GB de memória, e um de 24-31B precisa de aproximadamente 20-28 GB em Q4.
O que é o Heretic?
O Heretic é uma ferramenta de código aberto de Philipp Emanuel Weidmann que busca automaticamente configurações que removem recusas alterando o modelo o mínimo possível. A versão 2.0, publicada em 2026-11-01, tornou a Arbitrary-Rank Ablation seu método padrão.
A abliteração remove todas as salvaguardas da IA?
Não. Ela atinge o comportamento de recusa e não garante que toda recusa desapareça. Testes publicados mostram recusas residuais, e a qualidade pode diminuir, principalmente em benchmarks de veracidade na pesquisa original.
Modelos sem censura são perigosos?
Podem ser mal utilizados, e o risco aumenta quando o modelo é conectado a ferramentas como shell, arquivos ou web. Em uma janela de chat comum, ele só gera texto. Use sandbox, privilégio mínimo, aprovação humana e registro para agentes.
É legal usar IA sem censura na Europa?
Depende de posse, distribuição e uso. Ter um modelo é diferente de usá-lo para cometer um delito. O AI Act da UE obriga principalmente os provedores, e licenças como a do Llama acrescentam limites contratuais. Isto não é aconselhamento jurídico; consulte um advogado para o seu caso.
Quais apps locais podem usar modelos sem censura?
Qualquer app que permita escolher o modelo, o que inclui LM Studio, Open WebUI, SillyTavern, AnythingLLM, Msty, KoboldCpp, Cline e n8n por meio de conexões com o Ollama ou compatíveis com OpenAI. Verifique se a versão que você usa aceita modelos personalizados.