주요 사실
- 핵심 논문: Arditi et al., “Refusal in Language Models Is Mediated by a Single Direction”(arXiv 2406.11717, 2024). 1.8B~72B 파라미터의 채팅 모델 13개를 다뤘습니다.
- Heretic: Philipp Emanuel Weidmann(p-e-w)이 개발했습니다. 2.0.0은 2026-11-01에, 2.1.0은 2026-11-08에 공개되었습니다. Optuna로 파라미터를 탐색하며 거부 횟수와 KL divergence로 점수를 매깁니다.
- Hugging Face 태그 수(2026-11-13): abliterated 13,279개, uncensored 16,629개, heretic 7,058개 저장소(양자화 버전과 중복 포함).
- 일반적인 크기(Q4_K_M GGUF): 8B 약 5 GB, 12B 약 7.6 GB, 24B 약 14 GB, 27B 약 16.6 GB, 31B 약 18.7 GB.
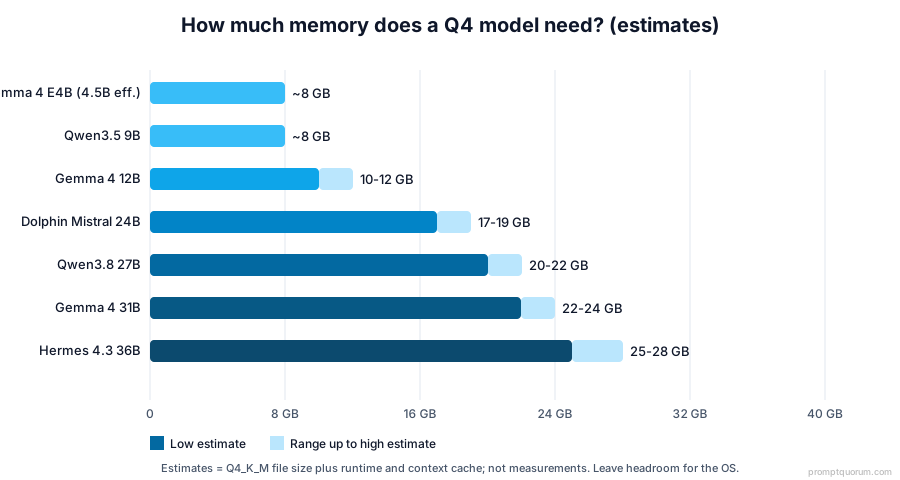
- 메모리 추정: 31B Q4 모델은 대략 VRAM 22-24 GB 또는 RAM 32 GB가 필요합니다. 실측이 아닌 추정치입니다.
- 위험이 낮은 파일 형식: pickle 기반의 .bin, .pt, .ckpt 파일보다 safetensors와 GGUF를 권장합니다.
검열 없는 AI 모델이란?
두 사람이 같은 오픈 웨이트 모델을 내려받습니다. 첫 번째 사람이 경계선상의 질문을 하자 정중한 거부 답변이 돌아옵니다. 두 번째 사람은 같은 기반 모델을 수정한 사본을 내려받아 똑같은 질문을 하고, 답변을 받습니다. 구조도 지식도 같지만 동작이 다릅니다. 이 차이가 검열 없는 AI의 전부입니다.
오픈 웨이트 모델이 파일이기 때문에 가능한 일입니다. 호스팅되는 챗봇은 가중치, 시스템 프롬프트, 필터를 다른 사람의 서버에 두므로 대화만 할 수 있습니다. 오픈 웨이트 모델은 가중치를 직접 내려받을 수 있습니다. 누구든 파인튜닝, 병합, 양자화, 편집을 한 뒤 결과물을 공개할 수 있습니다. 거부 동작은 모델이 학습한 것이므로 지우거나 억제할 수 있습니다.
로컬 AI가 이를 현실로 만듭니다. 이제 12B나 24B 모델도 노트북이나 GPU 한 장에서 오프라인으로, 이미 신뢰하는 앱 안에서 돌아갑니다. 2026-11-13 기준 Hugging Face 태그 페이지에는 abliterated 태그 저장소 13,279개, uncensored 16,629개, heretic 7,058개가 있었지만 양자화 버전과 중복이 포함된 수치입니다. 전문 인덱스도 두 곳 있습니다. abliter.cn은 스캔한 저장소 25,796개 중 모델 921개를 보여 주었고, abliteration.org는 19,000개가 넘는 모델의 카탈로그라고 소개합니다. 포함 기준이 달라서 숫자가 같은 대상을 가리키지는 않습니다.
이 주제는 뉴스에서도 다뤄지고 있습니다. Heretic 2.0이 2026-11-01에 출시되어 기존의 단일 방향 기법을 도구의 기본값에서 대체했습니다. WIRED는 2026-11-10에 이 커뮤니티를 다룬 기사를 실었습니다(재게시본만 읽을 수 있어서 보도된 내용으로 인용합니다). 2026-11-05에 공개된 Gemma 4 31B 수정 모델은 거부가 크게 줄었다고 주장하며, 그 수치는 아래에서 살펴봅니다.
이 가이드는 현상에서 출발해 용어, 원리, 도구를 차례로 설명합니다. 한 가지 생각이 글 전체를 관통합니다. 이런 모델을 로컬 앱에서 바꿔 끼울 수 있는 부품으로 보라는 것입니다. 앱은 문서, 음성, 에이전트, 사용하기 쉬운 인터페이스를 제공하고, 모델은 무엇에 답할지를 정합니다. 둘을 조합하면 호스팅 서비스에서는 얻을 수 없는 유연성이 생기지만, 호스팅 서비스가 제공하는 안전망도 사라집니다.
📍 한 문장으로
검열 없는 AI 모델은 파인튜닝이나 가중치 편집으로 수정되어 원본보다 적은 요청을 거부하는 오픈 웨이트 언어 모델입니다.
💬 쉽게 말하면
모델을 내가 가진 파일이라고 생각해 보세요. 누군가 그 파일을 고쳐 더 자주 “예”라고 답하게 만들 수 있고, 고쳐진 파일은 내 앱에서 그대로 실행할 수 있습니다.
“검열 없음”의 실제 의미
이 용어들은 느슨하게 쓰이며, 그래서 광고와 다르게 동작하는 모델을 내려받게 됩니다. 각 용어가 기술적으로 무엇을 뜻하는지 정리했습니다.
📍 한 문장으로
“Uncensored”는 결과(거부가 적음)를, “abliterated”는 방법(가중치 편집)을 가리키므로 한쪽에만 해당하는 모델도 있을 수 있습니다.
💬 쉽게 말하면
Uncensored는 바라는 결과이고, abliterated는 만든 방식이며, jailbroken은 바뀌지 않은 모델에 거는 속임수입니다.
용어 | 의미 | 기술적 보장 여부 |
|---|---|---|
| Uncensored | 콘텐츠 거부가 적거나 없음 | 없음 |
| Unfiltered | 출력 필터링이 덜 엄격함 | 없음 |
| Unaligned | 정렬 학습이 줄었거나 다름 | 없음 |
| Abliterated | 절제 기법으로 가중치를 편집함 | 방법만 해당 |
| Jailbroken | 프롬프트로 동작을 우회함 | 없음, 가중치 그대로 |
| Unrestricted | 마케팅 용어 | 없음 |
탈옥(jailbreaking)은 예외입니다. 모델이 아니라 프롬프트를 바꾸기 때문에 다음 대화는 깨끗한 상태에서 시작합니다. 나머지 용어는 가중치에 가한 작업을 가리킵니다.
⚠️경고: 이름에 “uncensored”가 들어 있는 모델이 반드시 거부 동작을 잃은 것은 아닙니다. 모델 카드에 측정된 거부율과 측정 방법이 있는지 확인하세요.
💡팁: 두 가지는 자주 혼동됩니다. 조종 가능한(steerable) 모델(Hermes, Dolphin)은 시스템 프롬프트로 동작을 정하고, abliterated 모델은 가중치에서 거부 동작이 제거된 모델입니다.
AI 모델은 어떻게 요청 거부를 학습하는가
사전 학습(pretraining)은 방대한 말뭉치에서 다음 텍스트를 예측하도록 모델을 가르칩니다. 그 결과 성능은 좋지만 방향성이 없어 거의 무엇이든 이어서 써 내려가는 시스템이 만들어집니다. 이어서 인스트럭션 튜닝과 지도 파인튜닝(SFT)으로 예시 대화를 학습시켜 질문에 도움이 되는 형식으로 답하게 합니다.
선호도 학습이 안전 계층을 더합니다. RLHF(인간 피드백 기반 강화학습)에서는 사람 평가자가 답변을 비교하고, 보상 모델이 그 선호를 학습하며, 모델은 그 방향으로 최적화됩니다. DPO(직접 선호 최적화)는 별도의 보상 모델 없이 비슷한 결과에 도달합니다. 안전 데이터셋은 유해한 요청과 거부 답변을 짝지어, 특정 유형의 요청은 거절해야 한다는 것을 모델이 배우게 합니다. 이것이 거부 학습(refusal training)입니다.
이 동작은 어디에 있을까요? 두 곳입니다. 시스템 프롬프트는 실행 시점에 앞에 붙는 텍스트이며 바꿀 수 있습니다. 모델 가중치 동작은 학습 중에 새겨지므로 가중치를 건드리지 않고는 바꿀 수 없습니다. 시스템 프롬프트만으로는 모델이 답하게 만들지 못하는 경우가 있고, 가중치 편집은 가능한 이유가 여기에 있습니다.
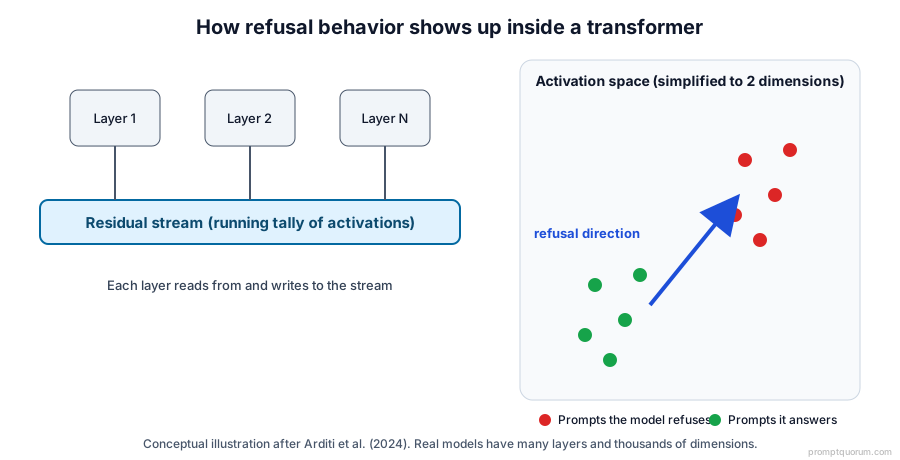
다이어그램은 abliteration을 가능하게 하는 아이디어를 보여 줍니다. 트랜스포머 안에서 모든 레이어는 잔차 스트림이라는 공유된 누적 값을 읽고 씁니다. 연구에 따르면 거부 신호의 상당 부분이 이 스트림의 한 방향을 따라 놓여 있습니다.
Abliteration이란?
과학적 토대는 Arditi et al.(2024)의 “Refusal in Language Models Is Mediated by a Single Direction”(arXiv 2406.11717)입니다. 저자들은 1.8B~72B 파라미터의 오픈 채팅 모델 13개를 테스트했고, 이 모델들에서는 거부가 잔차 스트림의 단일 방향으로 매개된다는 결과를 얻었습니다.
방향을 찾는 방법. 유해한 프롬프트 집합과 무해한 프롬프트 집합으로 모델을 실행하고, 선택한 레이어와 토큰 위치에서 내부 활성화를 기록한 뒤 두 평균의 차이를 계산합니다. 이 평균 차이 벡터가 거부 방향의 후보입니다.
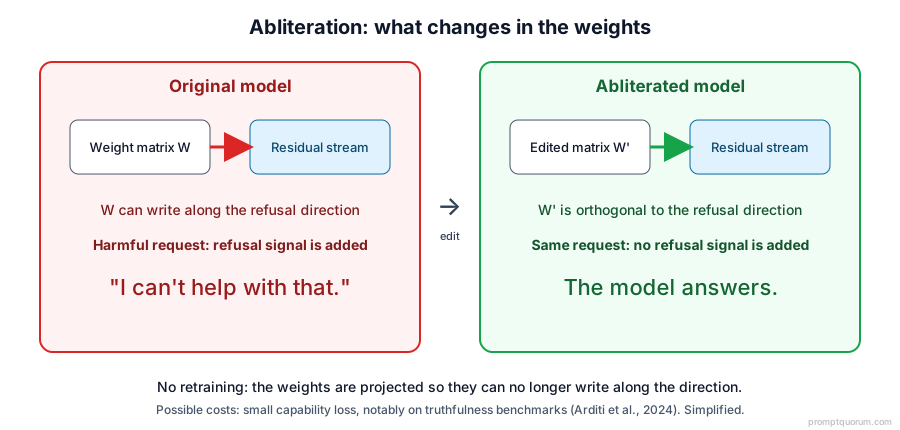
방향을 제거하는 방법. 방향 절제(directional ablation)는 실행 시점에 활성화에서 이 방향을 투영해 제거합니다. 가중치 직교화(weight orthogonalization)는 같은 효과를 영구적으로 얻는 방식입니다. 잔차 스트림에 값을 쓰는 가중치 행렬을 수정해 더 이상 그 방향으로 쓰지 못하게 합니다. 편집된 모델은 재학습이 필요 없고, 파일은 다른 모델과 똑같아 보입니다.
잃는 것. 저자들은 대부분의 벤치마크에서 성능 저하가 작았고 TruthfulQA만 예외로 대략 1~3.5점 일관되게 떨어졌다고 보고합니다. 또한 방향 선택 방법을 휴리스틱이라고 설명합니다. Maxime Labonne의 실전 가이드는 abliteration이 그가 측정한 모든 벤치마크를 낮췄고, DPO “힐링” 단계로 대부분 회복되지만 전부는 아니며, 레이어를 고르는 데 판단이 필요하다고 밝혔습니다.
수치에 대한 주의. 보안 업체 Alice는 모델 5개를 테스트해 abliteration 이후 준수율이 98.0%(550개 프롬프트 중 539개)였고 이전에는 5.8%였다는 보고서와, 6개 모델 계열에서 96-100%였다는 블로그 글을 냈습니다. 이 수치는 업체가 보고한 것이고 LLM 심사자가 채점했으며 동료 심사를 거치지 않았고, 실제 능력 향상이 아니라 답하려는 의지를 측정합니다. 증명이 아니라 하나의 참고 자료로 보세요.
📍 한 문장으로
Abliteration은 활성화 차이로 거부 방향을 추정하고, 모델이 그 방향으로 값을 쓰지 못하도록 가중치를 편집합니다.
💬 쉽게 말하면
거부가 모델 내부의 다이얼이라면, abliteration은 그 다이얼을 찾아 없애며 모델에 새로운 것을 가르치지는 않습니다.
Heretic 2.0: 차세대 Abliteration
누가 무엇을. Heretic은 Philipp Emanuel Weidmann(GitHub 핸들 p-e-w)이 만든 오픈 소스 명령줄 도구입니다. 사람이 레이어와 강도를 고르게 하는 대신 탐색을 자동화합니다.
기존 방식. Heretic은 TPE 샘플러를 쓰는 하이퍼파라미터 최적화 라이브러리 Optuna로 여러 abliteration 설정을 시도합니다. 교체 가능한 스코어러가 각 시도를 평가합니다. 기본적으로 키워드 스코어러로 거부 횟수를 세고, 무해한 프롬프트에서 원본 모델과의 KL divergence를 측정합니다. 따라서 탐색은 거부를 없애면서 나머지는 최대한 적게 바꾸는 설정을 찾습니다. 모디파이어는 실제로 가중치를 편집하는 구성 요소입니다.
2.0에서 달라진 점. 2.0.0 버전은 2026-11-01에 공개되었고(2.1.0은 2026-11-08), 기본 모디파이어는 이제 Arbitrary-Rank Ablation(ARA)입니다. 투영 abliteration과 노름 보존 옵션이 있는 기존 방향 절제도 계속 쓸 수 있습니다. 이번 릴리스에는 플러그인 시스템, 헤드리스 실행, 플러그인 형태의 BERT 기반 거부 스코어러도 추가되었습니다(기본 스코어러는 여전히 키워드 방식). Heretic 1.x 설정 파일은 2.x에서 동작하지 않습니다.
ARA란. 개발자 본인의 풀 리퀘스트에 따르면 ARA는 거부 방향을 사용하지 않습니다. L-BFGS 최적화기로 모듈별 행렬 편집을 학습하며 목표는 세 가지입니다. 무해한 프롬프트의 출력은 그대로 두고, 유해한 프롬프트의 출력이 무해한 출력과 일치하게 만들고, 기존의 유해한 출력에서는 멀어지게 합니다. 단일 방향은 랭크 1 편집이고, ARA는 더 높은 랭크의 편집을 허용하므로 1차원이 아닌 거부 동작도 포착할 수 있습니다. 전체 설명은 “곧” 나올 프리프린트로 예고된 상태이므로, 품질에 관한 주장은 개발자 본인의 것이며 독립적으로 검증되지 않았습니다.
하드웨어와 트레이드오프. 이 도구는 전체 모델을 불러와 여러 번 시도를 실행하므로, 수정하려는 모델을 돌릴 만큼의 메모리와 시간이 필요합니다. 품질 면의 트레이드오프는 다른 방법과 비슷합니다. 16개 모델에서 4개 도구를 비교한 연구(Young, arXiv 2512.13655, 초록만 확인)는 GSM8K 변화가 +1.5점에서 -18.8점, Heretic의 KL 값이 0.04에서 1.65라고 보고하며, 결과가 모델에 크게 좌우됨을 보여 줍니다.
⚠️경고: 2.0의 일부 세부 내용은 서드파티 블로그 글에 나오지만 저장소와 대조할 수 없었습니다. 저장소, 릴리스 노트, 개발자의 풀 리퀘스트에 있는 내용만 사실로 서술하고, 나머지는 보도된 내용으로 표시합니다.
검열 없는 모델을 만드는 다른 방법
Abliteration이 유일한 길은 아닙니다. 표는 주요 접근법을 비교합니다. 병합 행은 일부러 신중하게 적었습니다. 병합을 거부 제거 방법으로 문서화한 1차 출처를 찾지 못했습니다.
방법 | 바뀌는 대상 | 학습 필요 여부 | 주요 트레이드오프 |
|---|---|---|---|
| 검열 없는 파인튜닝 | 가중치(새 데이터로) | 필요 | 연산량과 데이터 품질 |
| Abliteration | 가중치(단일 방향) | 불필요 | 일부 성능 저하 |
| 자동화 abliteration | 가중치(탐색된 설정) | 불필요 | 시도 시간과 메모리 |
| 모델 병합 | 여러 모델을 혼합 | 불필요 | 거부 제거는 미검증 |
| 선호도 최적화 | 가중치(선호도로) | 필요 | 짝지은 데이터 필요 |
가장 잘 알려진 파인튜닝 접근법은 Eric Hartford의 Dolphin 계열로, 학습 데이터에서 거부식 답변을 걸러 내고 동작은 시스템 프롬프트에 맡깁니다. 파인튜닝은 LoRA 어댑터로도 할 수 있으며, 발표된 연구들은 소량의 유해 파인튜닝만으로 안전 학습이 무력화될 수 있다고 보고합니다(Qi et al., Lermen et al.). 노름 보존 이중 투영 abliteration 같은 새로운 가중치 편집 변형은 부수적 손상을 줄이려 하고, 편집 후 품질을 회복하는 데에는 DPO “힐링”이 쓰입니다.
가장 중요한 검열 없는 AI 모델 계열
Dolphin(cognitivecomputations와 새로운 dphn 조직)은 파인튜닝 계열 중 가장 잘 알려져 있습니다. 현재 검증된 항목은 Dolphin-Mistral-24B-Venice-Edition입니다. 모델 카드에 따르면 시스템 프롬프트가 동작을 정하므로, 거부가 전혀 없다고 보장되는 것이 아니라 조종 가능한 모델입니다.
Hermes(NousResearch)는 검열 없는 계열이 아닙니다. Hermes 4 모델은 중립적으로 정렬되어 있고 조종 가능합니다. Nous의 자체 RefusalBench가 Hermes 4.3 36B 카드에 보고한 바에 따르면 이 모델은 테스트 프롬프트의 약 72-75%에 답했고, 즉 약 4분의 1은 여전히 거부합니다. 모든 Hermes 모델을 검열 없는 모델로 분류하지 마세요.
Qwen abliterated 변형이 다운로드를 압도합니다. 검증된 항목 중 가장 많이 내려받은 것은 약 400만 다운로드의 Huihui-Qwen3.8-27B-abliterated입니다. 검색: Hugging Face의 Qwen abliterated.
Gemma abliterated 변형은 가장 새로운 영역입니다. Gemma 4 수정 모델은 일반 abliteration 버전과 Heretic·ARA 버전으로 나와 있습니다. 검색: Gemma abliterated. 그중 Gemma 4 31B ARA 모델은 거부가 크게 줄었다고 주장하며, 아래에서 살펴봅니다.
Llama abliterated 변형은 대부분 오래되었습니다. 2026-11-13에 우리가 확인한 바로는 Llama 3.1과 3.3보다 새로운 버전 중 다운로드 수가 많은 것은 없고, 가장 많이 받은 8B 항목은 2024년 것입니다. 검색: Llama abliterated.
Mistral, DeepSeek, GLM. Mistral Small 3.2 24B abliteration이 있습니다. DeepSeek와 GLM은 최신 모델의 abliterated 버전이 있지만 각각 약 284 GB와 321 GB로 일반 소비자 하드웨어로는 감당할 수 없으며, 실용적인 것은 32B의 이전 DeepSeek R1 distill뿐입니다.
Gemma 4 31B 주장에 대한 비판적 검토. 모델 카드는 거부가 100개 프롬프트 중 99개에서 28개로 줄었다고 보고합니다(Heretic v2.0.0 ARA, KL divergence 0.0845). 상대적으로 72% 감소이지만, 테스트 프롬프트 100개 중 28개는 여전히 탐지기에 걸렸다는 뜻이기도 합니다. 탐지기는 “sorry”, “illegal” 같은 약 34개 키워드 목록이고 100토큰으로 잘린 응답에 적용되므로, 면책 문구가 붙은 유용한 답변도 거부로 집계되고, 이 단어가 없는 회피성 답변은 준수로 집계됩니다. 테스트 세트는 한 데이터셋에서 뽑은 프롬프트 100개이고, 원본은 99/100이었으며, KL 수치는 무해한 프롬프트에서만 측정했기 때문에 성능에 대해서는 아무것도 말해 주지 않습니다. 카드는 재현 가능성을 약속하지만, 재현 파일 스스로 커밋되지 않은 로컬 Heretic 빌드를 사용했다고 경고합니다. 독립적인 평가는 찾지 못했습니다. 같은 기반 모델의 다른 31B 리팩은 KL 0.054에서 10/100을 보고하지만, 저자, 실행, 설정이 다른 결과는 서로 비교할 수 없습니다.
💡팁: 거부 수치는 벤치마크 수치처럼 읽으세요. 무엇을 거부로 셌는지, 프롬프트가 몇 개인지, 응답을 얼마나 길게 허용했는지, 누가 테스트했는지를 물어보세요.
검열 없는 AI 모델은 어디서 내려받을 수 있나?
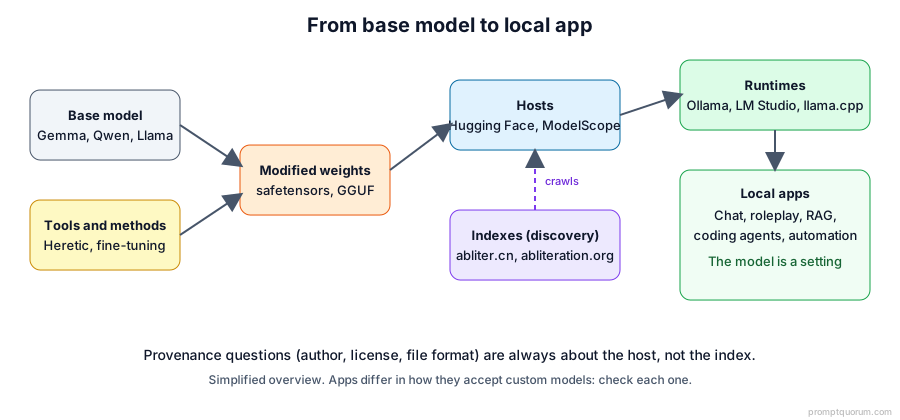
호스팅 플랫폼은 파일 자체를 저장하고 제공합니다. 전문 인덱스는 호스팅 플랫폼을 크롤링해 탐색 계층만 더합니다. 인덱스는 후보를 찾는 데 도움이 되지만 내려받는 파일은 여전히 호스트에서 오므로, 출처에 관한 질문은 언제나 호스트와 제작자에 대한 것입니다.
플랫폼 | 역할 | 웹사이트 |
|---|---|---|
| Hugging Face | 가중치와 모델 카드 | huggingface.co |
| Ollama | 로컬 실행 및 배포 | ollama.com |
| ModelScope | 대체 저장소 | modelscope.cn |
| GitHub | 도구와 소스 코드 | github.com |
| Abliter.cn | 모델 탐색 인덱스 | abliter.cn |
| Abliteration.org | 카탈로그와 분석 | abliteration.org |
실행하기 전에 확인하세요. safetensors와 GGUF 파일을 권장합니다. pickle 기반 형식(.bin, .pt, .pkl, .ckpt)은 불러올 때 코드를 실행할 수 있으며, Hugging Face 문서도 신뢰할 수 있는 제작자와 safetensors를 권장합니다. 낯선 저장소에서는 trust_remote_code를 절대 켜지 마세요. 모델 카드에 기반 모델과 방법이 명시되어 있는지, 기반 모델 계보가 공식 저장소로 이어지는지 확인하고, 제작자가 해시를 공개했다면 파일 해시를 대조하고, 라이선스를 읽으세요. Hugging Face는 2 GB 미만의 저장소 파일에 대해 악성코드 검사를 실행하므로 큰 가중치 파일은 검사 범위 밖일 수 있습니다(문서에 대한 우리의 해석). 평판 좋은 양자화 제작자의 양자화본은 파일 형식을 보증할 뿐, 원 제작자의 주장을 보증하지 않습니다. huihui_ai, richardyoung 같은 Ollama 네임스페이스는 사용자 업로드이며 라이브러리에서 검증한 모델이 아닙니다.
내려받을 만한 검열 없는 모델은?
2026-11-13에 이전 글이 아니라 Hugging Face API와 모델 카드를 기준으로 현재 저장소 10곳을 확인했습니다. 크기는 저장소가 공개한 경우 Q4_K_M GGUF 파일 크기이고, 메모리 수치는 실측이 아니라 우리의 추정치(파일 크기에 런타임과 캐시를 더한 값)입니다. 다운로드 수와 날짜는 계속 바뀌므로 이 표는 스냅샷이며 글과 별도로 갱신해야 합니다.
Gemma 4 31B ARA Heretic
- 기반:
- Gemma 4 31B-it
- 방법:
- Heretic 2.0 ARA
- 파라미터:
- 30.7B
- Q4 크기:
- 18.7 GB
- 메모리(추정):
- VRAM 22-24 GB
- 컨텍스트:
- 262K
- 라이선스:
- Apache-2.0
- 알려진 한계:
- 독립 테스트 없음
Gemma 4 E4B Heretic
- 기반:
- Gemma 4 E4B-it
- 방법:
- Heretic ARA
- 파라미터:
- 유효 4.5B
- Q4 크기:
- 5.3 GB
- 메모리(추정):
- 약 8 GB
- 컨텍스트:
- 131K
- 라이선스:
- Apache-2.0
- 알려진 한계:
- 리패키저 자체 테스트
Huihui Gemma 4 12B
- 기반:
- Gemma 4 12B-it
- 방법:
- Abliteration
- 파라미터:
- 12.0B
- Q4 크기:
- 7.6 GB
- 메모리(추정):
- 10-12 GB
- 컨텍스트:
- 128-256K
- 라이선스:
- Apache-2.0
- 알려진 한계:
- 카드: “개념 증명”
Huihui Qwen3.8 27B
- 기반:
- Qwen3.8 27B
- 방법:
- Abliteration
- 파라미터:
- 27.3B
- Q4 크기:
- 16.6 GB
- 메모리(추정):
- 20-22 GB
- 컨텍스트:
- 262K
- 라이선스:
- Apache-2.0
- 알려진 한계:
- 면책 문구가 붙을 수 있음
Huihui Qwen3.5 9B
- 기반:
- Qwen3.5 9B
- 방법:
- Abliteration
- 파라미터:
- 9.7B
- Q4 크기:
- 5.6 GB
- 메모리(추정):
- 약 8 GB
- 컨텍스트:
- 262K
- 라이선스:
- Apache-2.0
- 알려진 한계:
- 카드에 거부 데이터 없음
Dolphin Mistral 24B Venice
- 기반:
- Mistral Small 24B
- 방법:
- 파인튜닝
- 파라미터:
- 24.0B
- Q4 크기:
- 14.3 GB
- 메모리(추정):
- 17-19 GB
- 컨텍스트:
- 131K
- 라이선스:
- Apache-2.0
- 알려진 한계:
- 프롬프트가 동작을 정함
Hermes 4.3 36B
- 기반:
- Seed-OSS 36B
- 방법:
- 포스트 트레이닝
- 파라미터:
- 36.2B
- Q4 크기:
- 21.8 GB
- 메모리(추정):
- 25-28 GB
- 컨텍스트:
- 524K
- 라이선스:
- Apache-2.0
- 알려진 한계:
- 검열 없는 모델 아님
Hermes 4 14B
- 기반:
- Qwen3 14B
- 방법:
- 포스트 트레이닝
- 파라미터:
- 14.8B
- Q4 크기:
- 9.0 GB
- 메모리(추정):
- 11-12 GB
- 컨텍스트:
- 41K
- 라이선스:
- Apache-2.0
- 알려진 한계:
- 검열 없는 모델 아님
Llama 3.1 8B abliterated
- 기반:
- Llama 3.1 8B
- 방법:
- Abliteration
- 파라미터:
- 8.0B
- Q4 크기:
- 4.9 GB
- 메모리(추정):
- 7-8 GB
- 컨텍스트:
- 131K
- 라이선스:
- Llama 3.1 약관
- 알려진 한계:
- 2024년 모델
R1 Distill Qwen 32B
- 기반:
- R1-Distill-Qwen-32B
- 방법:
- Abliteration
- 파라미터:
- 32.8B
- Q4 크기:
- 19.9 GB
- 메모리(추정):
- 23-26 GB
- 컨텍스트:
- 131K
- 라이선스:
- 태그 없음
- 알려진 한계:
- 2025년 모델, 라이선스 태그 없음
표 읽는 법. Qwen3.8 27B abliteration은 다운로드 수가 압도적으로 많지만(약 400만) 카드에는 출력에 작은 면책 경고가 붙을 수 있다고 적혀 있습니다. “abliterated”가 “무엇이든 답한다”는 뜻은 아니라는 점을 보여 줍니다. 작은 컴퓨터에는 Gemma 4 E4B와 Qwen3.5 9B 항목이 약 8 GB에 들어갑니다. 일부는 검증된 Ollama 태그가 있습니다. ollama run huihui_ai/gemma-4-abliterated:12b, ollama run huihui_ai/qwen3.5-abliterated:9b, huihui_ai/Qwen3.8-abliterated(약 18 GB)이며, Gemma 4 31B 모델은 제작자의 네임스페이스에 Ollama 페이지가 있습니다. Hermes 4.3 36B는 조종 가능한 중립 정렬 모델을 수정 모델 옆에서 비교해 볼 수 있도록 넣었습니다. Nous의 자체 벤치마크에서도 프롬프트의 약 4분의 1은 거부됩니다. Llama 3.1 약관은 “Built with Llama” 표기와 파생 모델 이름 앞의 “Llama” 접두어를 요구하며, R1 distill에는 라이선스 태그가 없으므로 라이선스가 있다고 가정하지 마세요. Mistral Small 3.2 abliteration(24B)과 Llama 3.3 70B abliteration(Q4에서 약 42.5 GB, 64 GB급 컴퓨터용)도 있지만 오래된 모델입니다.
로컬 앱 안에서 검열 없는 모델 사용하기
이것이 중요한 이유는 로컬 AI의 구조에 있습니다. 대부분의 로컬 앱은 고정된 모델을 내장하지 않습니다. 백엔드(주로 Ollama, llama.cpp, OpenAI 호환 서버)에 연결하거나 사용자가 고른 GGUF 파일을 불러옵니다.
자체 리뷰에서도 이 패턴이 여러 범주에 걸쳐 확인됩니다. SillyTavern은 KoboldCpp, text-generation-webui, Ollama, LM Studio에 연결됩니다. Open WebUI는 Ollama나 OpenAI 호환 API 앞단에서 동작합니다. LM Studio는 내장 Hugging Face 브라우저로 GGUF 모델을 실행합니다. AnythingLLM, Msty, Cline은 Ollama나 LM Studio에 연결됩니다. n8n에는 전용 Ollama 노드가 있고, KoboldCpp는 GGUF 파일을 직접 실행합니다. 모델이 하나의 설정이라면 작업마다 중립 모델과 제한 없는 모델을 바꿔 쓸 수 있습니다.
얻는 것. 앱의 기능과 내가 고른 모델을 함께, 오프라인에서, 대화를 읽는 호스팅 사업자 없이 쓸 수 있습니다. 표는 범주별로 이것이 어떻게 나타나는지 보여 줍니다. 사용하는 앱 버전이 커스텀 모델을 받아들이는지 확인한 뒤에 의존하세요. 이 목록은 출발점이지 보장이 아닙니다.
📍 한 문장으로
대부분의 로컬 앱은 모델을 바꿔 끼울 수 있는 설정으로 다루기 때문에, 제한 없는 모델과 짝지으면 앱을 바꾸지 않고도 앱 전체가 할 수 있는 일이 달라집니다.
💬 쉽게 말하면
앱은 자동차이고 모델은 운전자입니다. 더 자주 “예”라고 답하는 운전자로 바꾸면 같은 차가 전에는 가지 않던 곳으로 갑니다.
앱 범주 | 예시 앱 | 제한 없는 모델이 더하는 것 |
|---|---|---|
| 채팅 클라이언트 | LM Studio, Msty, Open WebUI | 거부되는 질문이 줄어듦 |
| 롤플레이와 소설 | SillyTavern, KoboldCpp | 어두운 주제, 장면 중 거부 없음 |
| 문서 RAG | AnythingLLM, Open WebUI | 추론이 기기 안에서 이루어짐 |
| 코딩 에이전트 | Cline, Aider, Continue | 보안 테스트 코드 지원 |
| 자동화 | Ollama 노드를 쓰는 n8n | 맞춤 파이프라인, 자체 정책 계층 |
| 개인 에이전트 | Hermes Agent, nanobot | 더 높은 자율성, 안전장치 필요 |
유연성의 구체적인 예. 소설가는 SillyTavern 뒤에서 abliterated 모델이나 조종 가능한 모델을 돌려 장면 도중 거부 없이 도덕적으로 복잡한 소설을 쓸 수 있으며, 이는 창작 글쓰기 가이드에서 자세히 다룹니다. 변호사, 기자, 연구자는 AnythingLLM을 민감한 문서 폴더에 연결해, 호스팅 모델이라면 논의를 거절할 수 있는 내용에 대해서도 추론이 컴퓨터에서 실행되는 상태로 질문할 수 있습니다. 앱마다 텔레메트리와 업데이트 설정을 확인하세요. 앱과 모델 다운로드는 여전히 네트워크를 사용할 수 있기 때문입니다. 보안 전문가는 승인된 테스트 환경 안에서 익스플로잇과 맞닿은 질문을 망설이지 않는 모델로 코딩 에이전트를 쓸 수 있습니다. 개발자는 모델이 설정인 n8n 워크플로를 만들어 아무것도 다시 쓰지 않고 모델을 바꿀 수 있습니다. 고급 사용자는 한 앱에서 모델 두 개를 돌려, 일상 작업에는 중립 모델을, 첫 번째 모델이 거절하는 작업에는 제한 없는 모델을 쓸 수 있습니다.
⚠️경고: 유연성에는 대가가 따릅니다. 채팅 창에서 제한 없는 모델은 텍스트만 생성합니다. 파일, 셸, 웹에 접근하는 에이전트에 연결하면 같은 모델이 자신이 생성한 내용을 실행에 옮길 수 있습니다. 이런 구성에는 샌드박싱, 최소 권한, 사람의 승인을 함께 적용하세요.
💡팁: 어떤 앱이 내 모델을 불러올 수 있는지, 내 하드웨어에 맞는지 모르겠다면 로컬 LLM 소프트웨어 디렉터리를 사용 목적, OS, RAM으로 필터링하거나, 내 컴퓨터를 Ask Hans에 설명해 보세요.
검열 없는 AI를 로컬에서 실행하는 방법
Ollama(ollama.com)는 명령줄 사용자에게 가장 간단한 방법입니다. 이름으로 모델을 받으면 많은 앱이 이해하는 API를 제공합니다. LM Studio(lmstudio.ai)는 그래픽 방식으로, 내장 Hugging Face 브라우저와 로컬 OpenAI 호환 서버를 갖추고 있습니다. llama.cpp(github.com/ggml-org/llama.cpp)는 이런 도구 다수의 기반 엔진이며 GGUF 파일을 직접 실행합니다. Transformers(huggingface.co/docs/transformers)는 Python에서 전체 정밀도의 safetensors 가중치를 불러오며, 연구하거나 모델을 평가·수정하려는 사람에게 맞습니다.
GGUF와 양자화. GGUF는 llama.cpp 기반 도구가 쓰는 단일 파일 형식입니다. 양자화는 더 적은 비트로 가중치를 저장하는 방식이며, Q4_K_M이 일반적인 절충안으로 전체 정밀도 크기의 약 4분의 1에 품질 저하는 크지 않습니다. 더 낮은 양자화는 메모리를 아끼지만 추론과 지시 따르기에 영향을 줄 수 있으므로, 사용하는 파일을 직접 테스트하세요.
하드웨어. Apple Silicon에서는 통합 메모리를 CPU와 GPU가 공유하므로 32 GB Mac에는 약 24-27B 파라미터의 Q4 모델과 컨텍스트를 올릴 수 있습니다. 시스템용으로 몇 GB는 남겨 두세요. NVIDIA GPU에서는 모델이 VRAM에 들어가야 합니다. 24 GB 카드는 위의 24-31B 모델에, 8 GB는 4-9B 모델에 맞습니다. 모델이 들어가지 않으면 레이어가 시스템 RAM으로 넘어가 속도가 급격히 떨어집니다. 정확한 수치는 로컬 LLM에 필요한 VRAM을 참고하세요.
오프라인 동작. 가중치가 디스크에 있으면 이 도구들은 텍스트 생성에 인터넷이 필요 없습니다. 이것이 개인정보 보호의 핵심 논거이자, 어떤 사업자도 로컬 사본에 사용 규칙을 강제할 수 없는 이유입니다.
나만의 abliterated 모델을 만들 수 있을까?
개념적으로는 가능하며, 예전보다 접근하기 쉬워졌습니다. 워크플로는 개략적으로만 설명합니다.
- 1오픈 웨이트 모델 선택
Why it matters: 도구가 모델을 불러와야 하므로 내 메모리에 맞는 크기를 고르세요. - 2라이선스 확인
Why it matters: 일부 라이선스와 사용 정책은 안전 필터 우회를 제한합니다(이전 Gemma 약관이 그랬습니다). 수정하거나 재배포하기 전에 정확한 기반 모델 라이선스를 읽으세요. - 3아키텍처 호환성 확인
Why it matters: 도구는 특정 아키텍처만 지원하므로 새 모델은 아직 동작하지 않을 수 있습니다. - 4방법 선택
Why it matters: 기존 방향 절제 또는 ARA를 쓰는 Heretic 같은 자동화 도구 중에서 고릅니다. - 5수정 실행
Why it matters: 자동화 도구는 여러 설정을 탐색하고, 기존 방법은 사용자가 고른 레이어에 의존합니다. - 6결과 평가
Why it matters: 도구가 튜닝하지 않은 프롬프트로 거부율과 품질 저하를 측정하세요. - 7원본과 비교
Why it matters: 거부가 줄어도 성능은 떨어질 수 있습니다. - 8문서화와 책임 있는 공개
Why it matters: 방법, 수치, 기반 모델, 라이선스 계보를 밝히세요.
검열 없는 AI의 위험은 무엇인가?
위험을 이해하는 데 필요한 수준에서만 설명하며, 실행에 관한 세부 정보는 제공하지 않습니다.
- 사이버 범죄와 악성코드 지원. 거부가 적은 모델은 악성 코드 작성을 도움받는 데 드는 노력을 낮춥니다. 이미 구할 수 있는 것 이상의 능력을 더하는지는 논쟁 중입니다.
- 피싱과 사기. 유창하고 개인화된 사기 문구는 어떤 유능한 모델이든 쉽게 만듭니다. 거부는 하나의 마찰 요인이었고 이 영역에서는 그 효과가 약합니다.
- 위험한 생물·화학 정보. 정책 논쟁에서 가장 파급력이 큰 우려입니다. 보고된 거부율 수치는 답하려는 의지를 측정할 뿐 실제 능력 향상을 측정하지 않으므로, 위험이나 안전 어느 쪽의 증거도 아닙니다.
- 무기 관련 오용. 같은 주의가 적용됩니다. 측정된 준수율은 입증된 능력이 아닙니다.
- 괴롭힘과 학대성 콘텐츠. 로컬 모델은 학대성 콘텐츠를 대량으로 생성할 수 있습니다. 아동 성착취물은 우리가 아는 관할권에서 형사 범죄입니다. 독일에서는 형법 § 184b(StGB)가 사실적 묘사물도 포함하므로, 사실적인 AI 생성물도 처벌될 수 있다고 가정하세요. 생성, 요청, 저장하지 마세요.
- 허위 정보. 거부가 적다는 것은 설득력 있는 허위 콘텐츠를 만드는 장벽이 낮아진다는 뜻이기도 합니다.
- 개인정보와 데이터 보안. 로컬 추론은 프롬프트를 컴퓨터에 머물게 하지만, 내려받는 파일은 별개의 위험입니다. 낯선 저장소에는 악성 파일이 있을 수 있고, 앱이 네트워크 호출을 할 수도 있습니다.
- 악성 모델 파일. pickle 기반 형식은 불러올 때 코드를 실행할 수 있고 스캔이 보장은 아닙니다(Hugging Face의 pickle 스캔 문서 참조). 알려진 제작자의 safetensors나 GGUF를 사용하세요.
- 도구에 접근하는 자율 에이전트. 가장 큰 변화입니다. 파일, 셸, 웹에 연결된 제한 없는 모델은 직접 행동할 수 있습니다. OWASP는 프롬프트 인젝션(LLM01)과 과도한 권한 위임(LLM06)을 LLM 애플리케이션의 주요 위험으로 꼽고 있습니다.
왜 일부 사람들은 AI 가드레일에 반대하는가?
제한이 덜한 모델을 옹호하는 가장 강력한 논거는 공정하게 서술할 가치가 있습니다.
- 표현의 자유. 옹호하는 쪽은 도구가 성인이 무엇을 읽고 쓸 수 있는지 결정해서는 안 된다고 주장합니다.
- 과학 연구. 거부를 포함한 모델 동작을 연구하려면 수정할 수 있는 모델이 필요합니다. abliteration 연구 자체도 오픈 웨이트에 의존합니다.
- 보안 테스트. 레드팀에는 방어를 테스트하기 위해 공격을 논의할 수 있는 모델이 필요합니다.
- 창작 글쓰기. 소설에는 지나치게 조심스러운 모델이 밋밋하게 만들 수 있는 악당, 폭력, 도덕적 복잡성이 필요합니다.
- 사용자 자율성. 로컬 도구의 한계는 업체가 아니라 사용자가 정해야 한다는 주장이 있습니다.
- 개인정보 보호와 로컬 실행. 민감한 자료는 내 컴퓨터에서 처리되므로 어떤 호스팅 사업자도 프롬프트를 받지 않습니다. 앱마다 텔레메트리 설정을 확인하세요.
- 과도한 제한 회피. 상용 모델을 비판하는 쪽은 무해한 질문에 대한 거부 사례를 듭니다. Eric Hartford의 검열 없는 모델에 관한 에세이가 이 논거를 펼칩니다.
AI 안전장치가 중요한 이유는?
반론도 똑같이 현실적입니다. 안전장치는 모델이 심각한 피해를 돕게 될 가능성을 줄이고, 취약한 사용자를 보호하며, 제품에 배포하는 것을 정당화할 수 있게 해 줍니다.
핵심 구분은 텍스트를 생성하는 모델과 명령을 실행하고 파일을 읽고 웹을 탐색하고 다른 시스템과 상호작용할 수 있는 에이전트 사이에 있습니다. 채팅 모델이 해로운 내용을 쓰더라도 그것을 실행에 옮기는 것은 여전히 사람입니다. 같은 모델을 쓰는 에이전트가 행동하면 출력과 결과 사이의 간격이 사라집니다.
오픈 모델의 안전장치는 변조 방지로 만들기 어렵습니다. 위의 abliteration 연구는 한 번의 가중치 편집으로 거부 동작을 억제할 수 있음을 보여 줍니다. 이는 더 강한 모델 수준의 보호와 모델 바깥의 통제를 뒷받침하는 핵심 논거입니다.
나만의 안전장치를 만들 수 있을까?
네. 로컬 모델에는 사업자 쪽 계층이 없으므로, 모델 주위에 직접 추가합니다.
- 모더레이션 계층. Llama Guard나 ShieldGemma 같은 분류기를 입력과 출력에 적용합니다.
- 입출력 필터링. 워크플로에 넣고 싶지 않은 범주를 차단하거나 검토합니다.
- 샌드박싱. 잃으면 안 되는 것에는 접근할 수 없도록 컨테이너나 가상 머신에서 에이전트를 실행합니다.
- 권한 제한. 에이전트에는 필요한 최소 권한만 줍니다. 읽기 전용 폴더, 네트워크 없음, 필요하지 않으면 셸 없음.
- 사람의 승인. 에이전트가 파일을 쓰거나 명령을 실행하거나 메시지를 보내기 전에 확인을 요구합니다.
- 로깅과 모니터링. 에이전트가 무엇을 왜 했는지 기록을 남깁니다.
- 에이전트 보안. 에이전트가 읽는 모든 문서, 웹 페이지, 이메일을 지시문이 들어 있을 수 있는 신뢰할 수 없는 입력(프롬프트 인젝션)으로 취급합니다.
검열 없는 AI 모델을 내려받고 사용하는 것은 합법인가?
하나의 답은 없으며, 법률 자문이 아닙니다. 소지, 배포, 사용을 구분해서 물어야 하며, 답은 국가와 모델을 무엇에 쓰는지에 따라 달라질 수 있습니다.
EU AI Act. 규정(EU) 2024/1689는 범용 AI 모델 제공자에게 의무를 부과하며, 오픈 소스 모델에는 부분적 면제가 있지만 시스템 리스크가 있는 모델에는 적용되지 않습니다. 범용 AI 모델에 대한 의무는 2025-08-02부터, 위원회의 집행 권한은 2026-08-02부터 적용됩니다. 위원회의 2025년 가이드라인은 하위 단계의 수정자가 잠정적 연산 기준을 넘을 때만 제공자가 된다고 설명합니다. 우리는 abliteration이 그 기준을 훨씬 밑돈다고 보지만 이 기준은 구속력이 없습니다. 2026년 Digital Omnibus가 범용 AI 날짜를 바꾸었는지는 본문으로 확인하지 못했으므로 현행 조문을 확인하세요.
소지와 사용의 차이. 모델 파일을 소유하는 것은 그것을 범죄에 사용하는 것과 다릅니다. 형사법은 금지된 콘텐츠 생성, 사기, 괴롭힘, 컴퓨터 범죄용으로 설계된 도구 같은 특정 행위에 적용됩니다. 독일 규정은 일부만 검토했으므로 이 가이드를 근거로 삼지 마세요.
라이선스와 계약. 라이선스는 법 위에 규칙을 더합니다. Gemma 4 모델 카드는 Apache-2.0을 표기하고 Gemma 4 라이선스 페이지를 링크하는 반면, 이전 Gemma 세대는 안전 필터 우회를 금지하는 Gemma 약관과 금지 사용 정책을 사용했습니다. 정확한 기반 모델의 라이선스 페이지를 확인하세요. Llama 3.1 라이선스는 파생 모델에 “Built with Llama” 표기와 모델 이름 접두어를 요구하며, 사용을 제한하는 허용 가능한 사용 정책이 있지만 우리가 읽기로는 명시적인 우회 금지 조항은 없습니다. 표에 나열된 Qwen3.5와 Qwen3.8 카드는 Apache-2.0을 표기합니다. 파생 모델뿐 아니라 기반 모델의 라이선스도 항상 읽으세요.
데이터 보호와 저작권. 개인정보를 로컬에서 처리하더라도 데이터 보호법의 적용을 받으며, 기반 모델의 학습 데이터에 관한 저작권 문제는 아직 해결되지 않았습니다. 거부 동작을 없앤다고 해서 어느 쪽도 달라지지 않습니다.
검열 없는 AI는 AI 생태계의 영구적인 일부가 되고 있는가?
여러 흐름이 그렇다고 가리킵니다. 커뮤니티의 수정 작업은 규모가 크고 커지고 있습니다. 위의 Hugging Face 태그 수는 수천 개 저장소에 이릅니다. 도구는 점점 자동화되고 있습니다. Heretic은 설정을 대신 탐색하고, ARA는 단일 방향을 넘어섭니다. 거부를 제거하는 새로운 기법이 계속 나올 것이고, 안전장치를 제거하기 어렵게 만드는 기법도 마찬가지입니다.
다른 방향으로 작용하는 흐름도 있습니다. 배포자가 정책을 고를 수 있는 구성 가능한 안전 아키텍처, 제한이 덜한 모델을 제공하는 상용 서비스, 점점 더 사용자에게 통제권을 주는 로컬 AI, 아직 형성 중인 규제가 그렇습니다. 오픈 웨이트를 변조 방지로 만들 수 있는지를 둘러싼 논쟁은 계속될 것으로 보입니다.
결론. 오픈 웨이트 AI는 사용자에게 모델 동작에 대한 더 큰 통제권을 주고 있고, 앱 계층이 그 통제를 실용적으로 만듭니다. 하지만 안전장치를 없앤다고 책임이 사라지지는 않습니다. 책임은 모델을 실행하는 사람에게 넘어갑니다.
출처
- Arditi et al., Refusal in Language Models Is Mediated by a Single Direction — arXiv 2406.11717
- Heretic 저장소와 릴리스 — github.com/p-e-w/heretic
- Maxime Labonne, Uncensor any LLM with abliteration — Hugging Face 블로그
- Young, Comparative Analysis of LLM Abliteration Methods — arXiv 2512.13655 (초록만 확인)
- Alice, One Pass to Break Them All(2026년 보고서) — 보고서 PDF, 업체 연구이며 동료 심사 없음
- WIRED, Tear Down Those Guardrails!(2026-11-10/11) — 재게시본으로만 읽었으며 보도된 대로 인용함
- Abliter.cn — abliter.cn; Abliteration.org — abliteration.org(사이트가 접근 오류를 반환하여 README 미러를 사용)
- Hugging Face 태그 페이지 — abliterated, uncensored, heretic
- Ollama 라이브러리 — ollama.com/library
- 규정(EU) 2024/1689(AI Act) 제2조 12항 및 제53조; 범용 AI 모델에 관한 위원회 가이드라인(2025)
- Gemma 금지 사용 정책 및 약관; Llama 3.1 라이선스 및 허용 가능한 사용 정책; Qwen3 모델 카드
- Hugging Face 문서: Pickle Scanning 및 Malware Scanning; OWASP Top 10 for LLM Applications
자주 묻는 질문
검열 없는 AI 모델이란 무엇입니까?
검열 없는 AI 모델은 파인튜닝이나 가중치 편집으로 거부를 줄이거나 없앤 오픈 웨이트 언어 모델입니다. 결과가 완전한 경우는 드뭅니다. 잘 알려진 수정 모델에 대한 공개 테스트에서도 잔여 거부가 확인됩니다.
검열 없는 AI와 abliterated AI는 어떻게 다릅니까?
Uncensored는 결과, 즉 거부가 적다는 것을 가리킵니다. Abliterated는 방법, 즉 거부 동작을 억제하도록 가중치를 편집하는 것을 가리킵니다. Abliterated 모델은 보통 제한이 덜하지만, 측정된 결과 없이 모델 이름에 “uncensored”가 들어 있다는 것만으로는 아무것도 증명되지 않습니다.
가장 좋은 검열 없는 LLM은 무엇입니까?
단 하나의 최선은 없습니다. 작은 컴퓨터에는 4-9B Gemma와 Qwen abliteration이 약 8 GB에 들어갑니다. 24 GB GPU에는 Dolphin Mistral 24B나 Qwen3.8 27B abliteration 같은 24-31B 모델이 맞습니다. 모델 카드에서 근거, 라이선스, 최근 활동을 확인하고 내 작업으로 직접 테스트하세요.
검열 없는 AI 모델은 무료입니까?
가중치는 보통 Apache-2.0이나 Llama 커뮤니티 라이선스 같은 라이선스로 무료로 내려받을 수 있습니다. 하드웨어와 전기 요금은 여전히 부담해야 하며, 일부 라이선스에는 사용과 재배포에 조건이 붙습니다.
검열 없는 모델은 어디서 내려받을 수 있습니까?
Hugging Face가 가중치와 모델 카드의 주요 호스트이고, Ollama는 많은 모델을 바로 실행할 수 있는 태그로 배포합니다. ModelScope는 대체 호스트입니다. Abliter.cn과 Abliteration.org는 모델을 찾는 데 도움이 되는 인덱스이며 파일을 호스팅하지는 않습니다.
검열 없는 AI를 로컬에서 실행할 수 있습니까?
네. GGUF 파일이나 Ollama 태그를 받아 Ollama, LM Studio, llama.cpp에서 실행합니다. 7-9B 모델은 메모리 약 8 GB, 24-31B 모델은 Q4에서 대략 20-28 GB가 필요합니다.
Heretic이란 무엇입니까?
Heretic은 Philipp Emanuel Weidmann이 만든 오픈 소스 도구로, 모델을 최대한 적게 바꾸면서 거부를 제거하는 설정을 자동으로 탐색합니다. 2026-11-01에 공개된 2.0 버전은 Arbitrary-Rank Ablation을 기본 방식으로 삼았습니다.
Abliteration은 모든 AI 안전장치를 제거합니까?
아닙니다. 거부 동작을 겨냥하며 모든 거부가 사라진다고 보장하지 않습니다. 공개된 테스트에서 잔여 거부가 확인되고 품질이 떨어질 수 있으며, 원 연구에서는 특히 진실성 벤치마크에서 그랬습니다.
검열 없는 모델은 위험합니까?
오용될 수 있고, 모델이 셸, 파일, 웹 같은 도구에 연결되면 위험이 커집니다. 일반 채팅 창에서는 텍스트만 생성합니다. 에이전트에는 샌드박싱, 최소 권한, 사람의 승인, 로깅을 적용하세요.
유럽에서 검열 없는 AI를 사용하는 것은 합법입니까?
소지, 배포, 사용에 따라 다릅니다. 모델을 소유하는 것은 그것을 범죄에 사용하는 것과 다릅니다. EU AI Act는 주로 제공자에게 의무를 부과하며, Llama 같은 라이선스는 계약상의 제한을 더합니다. 법률 자문이 아니므로 구체적인 사안은 변호사와 상담하세요.
어떤 로컬 앱에서 검열 없는 모델을 쓸 수 있습니까?
모델을 고를 수 있는 앱이면 모두 가능하며, LM Studio, Open WebUI, SillyTavern, AnythingLLM, Msty, KoboldCpp, Cline, n8n이 Ollama 또는 OpenAI 호환 연결을 통해 해당됩니다. 사용하는 버전이 커스텀 모델을 받아들이는지 확인하세요.