重要なポイント
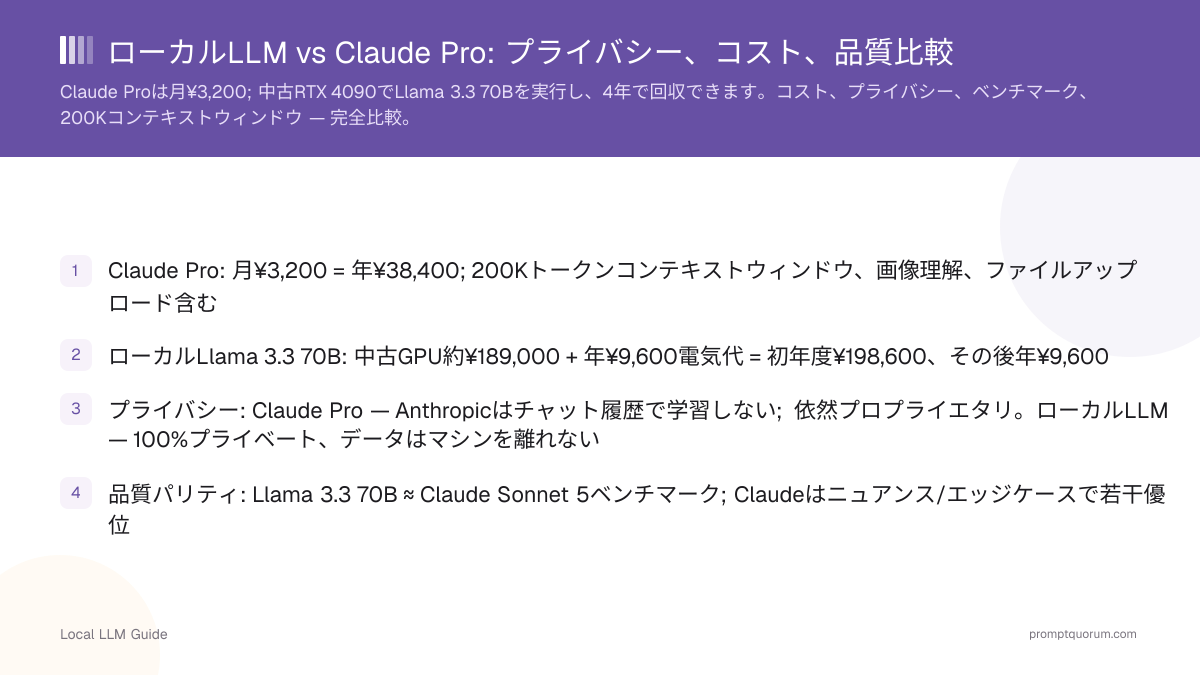
- Claude Pro: 月¥3,200 = 年¥38,400; 200Kトークンコンテキストウィンドウ、画像理解、ファイルアップロード含む
- ローカルLlama 3.3 70B: 中古dual RTX 4070s約¥105,000(推奨)+ 年¥9,600電気代 = 初年度¥114,600、その後年¥9,600。中古RTX 4090は現在¥380,000~490,000(NVIDIAが2026年に生産終了)。
- プライバシー: Claude Pro — Anthropicはチャット履歴で学習しない; 依然プロプライエタリ。ローカルLLM — 100%プライベート、データはマシンを離れない
- 品質パリティ: Llama 3.3 70B ≈ Claude Sonnet 5ベンチマーク; Claudeはニュアンス/エッジケースで若干優位
- コンテキストウィンドウ: Claude Pro 200Kトークン対 Llama 3.3 70B 128Kトークン(ドキュメント向けに依然優秀)
- 5年TCO: Claude Pro ¥192,000 対 dual RTX 4070sのローカル(¥105,000 GPU + ¥48,000電気代)= ¥153,000 — Claudeより安い。中古RTX 4090(¥380,000~490,000 + ¥48,000)は5年で回収できない可能性があります。
- ローカル利点: 無制限クエリ、レート制限なし、オフライン対応、モデル所有権
- Claude Pro利点: マルチモーダル優秀(画像)、リアルタイム更新、インフラストラクチャオーバーヘッドなし
重要な事実
- Claude Pro価格: 月¥3,200(年¥38,400)、ハードウェア不要
- Llama 3.3 70Bハードウェア: dual RTX 4070s(中古約¥105,000、推奨)またはRTX 4090(中古¥380,000~490,000 — NVIDIAが2026年に生産終了)
- 5年TCO: Claude Pro ¥192,000 対 ローカル約¥153,000(dual RTX 4070s)— ローカルの方が安い。中古RTX 4090(約¥435,000)は5年で回収できない可能性。
- MMULスコア: Claude Sonnet 5 97% 対 Llama 3.3 70B 96%
- コンテキストウィンドウ: Claude Pro 200Kトークン対 Llama 3.3 128Kトークン
- 損益分岐点: 約44ヶ月(dual RTX 4070s)— その後、ローカルは永遠に安い。中古RTX 4090は5年枠を超えます。
Claude ProとローカルLLMの価格差は?
Claude Proは月¥3,200でハードウェア不要; ローカルLlama 3.3 70Bは推奨のdual RTX 4070sで初期投資約¥105,000、またはNVIDIAが生産終了した中古RTX 4090で¥380,000~490,000、加えて年¥9,600電気代。 初年度は絶対額ではClaude Proの方が安いですが、dual 4070sの損益分岐点は約44ヶ月です。
5年総所有コスト: Claude Pro ¥192,000 対 ローカルLlama(中古dual RTX 4070s)¥153,000 対 ローカルLlama(中古RTX 4090)¥428,000~538,000。初年度: Claude Pro ¥38,400 対 ローカル ¥114,600(4070s)または¥389,600~499,600(4090)。3年目: Claude Pro ¥115,200 対 ローカル ¥133,800(4070s)または¥409,200~519,200(4090)。5年目: Claude Pro ¥192,000 対 ローカル ¥153,000(4070s)または¥428,000~538,000(4090)。
ローカルLLM向けベストGPUはハードウェアオプションと現在の市場価格をさらに詳しく説明しています。
•⚠️ 警告: NVIDIAは2026年にRTX 4090の生産を終了しました。中古価格は¥380,000~490,000まで上昇しており、5年以内にClaude Proに対して回収できない可能性があります。
•💡 プロのコツ: Dual RTX 4070s(中古約¥105,000)はRTX 4090単体の60~70%の速度でLlama 3.3 70Bを実行でき、コストは約4分の1です — 2026年時点で最も経済的な選択肢です。
Claude ProとローカルLLMのプライバシーモデルはどう異なる?
Claude Pro(Anthropic): 会話は将来のClaudeモデル学習に使用されません(2026年現在、Anthropicの明示的プライバシーポリシー)。 ただし、クエリはセキュリティ監視とデバッグのためAnthropicサーバーに記録されます。Anthropicは米国ベースで、米国法の対象です。
ローカルLLM: すべてのデータはマシンに残ります。クラウドログなし、サードパーティ可視性なし。医療(HIPAA)、金融(PCI-DSS)、法務(弁護士-クライアント特権)ワークフローに適しています。2026年4月時点で、Llama 3.3は完全なオープンソース(Anthropicデータ収集なし)です。
•📌 重要ポイント: Anthropicはチャット履歴で学習しませんが、会話はセキュリティ監視のため米国サーバーに記録されます。
•🛡️ コンプライアンス: HIPAA、PCI-DSS、または弁護士-クライアント特権ワークフローでは、ローカルLLMのみ準拠 — サードパーティサーバーはデータにアクセスしません。
Claude Sonnet 5とLlama 3.3 70Bの品質はどう比較される?
Claude Sonnet 5(Anthropic、2026年):Anthropicのベンチマークデータによるとリーズニング、ニュアンス、指示追従において最先端。 MMLU(言語理解)スコア 97%。複雑な分析、コピーライティング、コードレビューで優秀。MMULスコア: 97%。コンテキストウィンドウ: 200Kトークン。画像理解: ネイティブ。ファインチューニング: 利用不可。オフライン: いいえ。レート制限: はい。
Llama 3.3 70B(Meta、2024年4月): MMULスコア 96%。優秀な推論、ベンチマークでClaudeに近い。コーディング性能が優れている(+2% HumanEval)。創造的/ナレーティブタスクでやや弱い。MMULスコア: 96%。HumanEval: Claude比+2%。コンテキストウィンドウ: 128Kトークン。画像理解: アダプター経由のみ。ファインチューニング: 完全(LoRA、完全)。オフライン: はい。レート制限: なし。
現実的なタスク(要約、Q&A、データ抽出、コーディング)の80%で、Llama 3.3 70BとClaude Sonnet 5は同等の出力を生成します。エッジケース(微妙な物語分析、ドメイン特有の創造的執筆)では、Claudeが若干優位です。ローカルLLMに必要なVRAMは70Bモデル実行のハードウェア要件をカバーしています。
📍 一文で説明
Llama 3.3 70Bは現実タスク80%でClaude Sonnet 5に並びますが、Claudeは微妙な推論と創造的執筆エッジケースで優位です。

•💡 プロのコツ: HumanEvalコーディングベンチマークでは、Llama 3.3 70Bは2026年4月のテストでClaude Sonnet 5を約2ポイント上回りました(EvalPlusリーダーボード;結果はベンチマークバージョンとタスク分布によって異なります)。
各モデルはどのくらい長いドキュメントを処理できる?
Claude Pro 200Kトークン: 約150,000語(3冊相当)。 完全なコードベース、法務契約、研究論文を1クエリで処理できます。
Llama 3.3 70B 128Kトークン: 約96,000語。ほとんどのドキュメントで依然優秀; 非常に大きなコードベースまたは500+ページ契約はこの制限を超えます。
2026年4月時点: ドキュメント処理ワークフロー(RAG、一括要約、契約レビュー)では、Claude Proの200Kウィンドウは有り得る利点です。Llama 3.3 128Kはビジネスドキュメントの~95%に十分です。
•📌 重要ポイント: どちらのコンテキストウィンドウも巨大です。非常に大きなコードベースまたは500+ページ契約のみがLlamaの128K制限を触れます。
5年間の総所有コストは?
Claude Pro: ¥3,200 × 60ヶ月 = ¥192,000合計。
ローカルLlama 3.3 70B(中古dual RTX 4070s): ¥105,000 + 電気5年 ¥48,000 = ¥153,000合計。NVIDIAがRTX 4090を生産終了して以降、推奨されるルートです。
ローカルLlama 3.3 70B(中古RTX 4090): ¥380,000~490,000 + ¥48,000電気代 = ¥428,000~538,000合計。
損益分岐点: dual RTX 4070sで約44ヶ月(約3.7年)。中古RTX 4090は現在の価格では5年枠内で回収できません。
💬 簡潔に説明
5年で、dual RTX 4070sは合計約¥153,000かかり、Claude Proの¥192,000より安くなります。中古RTX 4090は現在¥380,000~490,000(NVIDIAが2026年に生産終了)で、Claude Proに対して5年で回収できなくなりました。

•💡 プロのコツ: 4070を350Wに制限すると電気代40%節約でき、スピード低下は~10%のみ — dual 4070sの5年ローカルコストを¥140,000以下に引き下げます。
コスト・プライバシーFAQ
•🔍 ご存知でしたか?: Claude ProはChatGPT Plusと同じ月¥3,200で価格設定されていますが、10倍大きいコンテキストウィンドウ(200K対16Kトークン)を提供します。
Claude Proをオフラインで使用できますか?
いいえ。Claude Proはアクティブなインターネット接続とAnthropicサーバーが必要です。ローカルLlama 3.3は完全にオフラインで動作します。
AnthropicはClaude Proの会話を学習に使用しますか?
いいえ(2026年4月現在)。Anthropicは明示的にチャット履歴で学習しません。会話はセキュリティ/デバッグのため記録されますが、モデル改善には使用されません。
Llama 3.3 70Bは本当に無料で使用できますか?
はい。Llama 3.3はMetaコミュニティライセンスの下、オープンソースです。GPUを所有すれば、推論コストは¥0(電気代のみ)。モデル更新は無料です。
Claude ProとローカルLlamaを異なるようにファインチューニングできますか?
Claude Pro: 2026年4月現在、ファインチューニング利用不可。ローカルLlama 3.3: 完全ファインチューニングサポート(LoRA、完全パラメータチューニング)。ローカルがカスタマイズで勝ちます。
ローカルGPUが故障したら?
交換まで(dual RTX 4070sで約¥105,000、中古RTX 4090で約¥380,000~490,000)計算能力を失います。Claude Proは優雅に劣化します(レート制限)。ローカルは冗長性計画が必要です(バックアップGPU、クラウドフェイルオーバー)。
Llama 3.3はClaude Proのような画像を処理できますか?
ネイティブマルチモーダル: いいえ(2026年4月現在)。オープンソース視覚モデル(CLIP、LLaVA)と統合できますが、Claudeほど流暢ではありません。
Claude ProはLlama 3.3より特定のタスクで優れていますか?
はい。Claude Sonnet 5は微妙な物語分析、曖昧な背景での複雑なマルチステップ推論、創造的執筆エッジケースで優秀です。HumanEvalコーディングベンチマークでは、Llama 3.3 70Bは2026年4月のテストでClaudeを約2ポイント上回りました(EvalPlusリーダーボード;結果はベンチマークバージョンとタスク分布によって異なります)。
Claude ProからローカルLLMへワークフロー喪失せず移行できますか?
はい。ほとんどClaude Pro使用ケース(Q&A、要約、コーディング)はOllamaまたはLM Studio経由でLlama 3.3 70Bに直接転送可能です。移行: Ollama install、llama3.1:70b download、API統合をclaude.aiからlocalhost:11434に更新。データはClaude Proに閉じ込められません。
Claude ProとローカルLLMを比較するときの一般的な誤り
- 月額コストが見えるからClaude Proが安いと考える。5年以上では、dual RTX 4070sは追いつき安くなりますが、中古RTX 4090は現在の価格では追いつきません。
- 中古RTX 4090が依然として安い選択肢だと仮定する。NVIDIAは2026年に生産を終了し、中古市場価格は¥380,000~490,000まで上昇しました。dual RTX 4070s(合計¥100,000~120,000)の方が経済的です。
- Llama 3.3がClaude Proのような画像理解と一致すると予想する。ネイティブマルチモーダルなし; CLIPアダプター使用。
- Claude Proの200Kコンテキスト利点を忘れる。単一クエリドキュメント処理ではClaudeが勝ちます。平均的なQ&AではLlama 3.3で十分。
- インフラストラクチャオーバーヘッドを考慮しない。Llama 3.3 70B実行は専門知識が必要です(CUDA、PyTorch、Docker)。Claude Proはターンキーです。
関連資料
参考資料
- Anthropic Claude Pro価格・プライバシーポリシー — Anthropic、2026年4月
- Meta Llama 3.3 70Bモデルカード — Meta、2024年4月
- オープンLLMリーダーボード — MMULおよびHumanEvalベンチマーク — Hugging Face、2026年4月