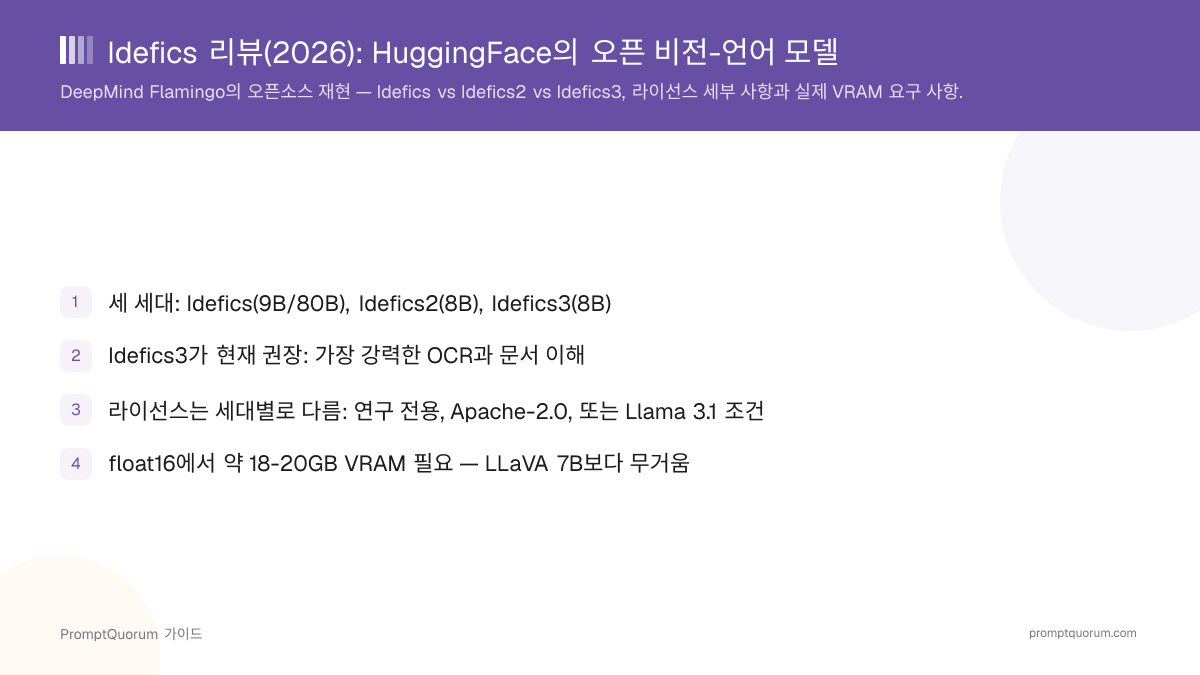
역사: HuggingFace M4와 Flamingo 재현
원조 Idefics의 모델 카드는 이를 "DeepMind가 개발한 폐쇄형 비전-언어 모델인 Flamingo의 오픈 액세스 재현물"이라고 명시적으로 설명한다. 2023년 HuggingFace M4 팀이 9B와 80B 두 가지 크기로 출시했으며, 비전 인코더와 LLaMA(1) 언어 모델 베이스를 결합했다.
원조 Idefics는 단일한 관대한 라이선스가 아니라 혼합된 라이선스를 가진다. 비전 인코더와 새로 학습된 연결 파라미터는 MIT 라이선스로 공개되지만, LLaMA(1) 언어 모델 베이스는 LLaMA에 대한 Meta의 원래 연구 전용, 비상업적 라이선스 준수를 요구한다. 이 때문에 스택 일부에 MIT 태그가 붙어 있음에도 원조 Idefics는 대부분의 경우 상업적 사용에 적합하지 않다.
2024년 4월경 출시된 Idefics2(8B)는 LLaMA(1) 베이스를 Mistral-7B-v0.1로 교체하고 SigLIP 비전 인코더와 결합했다. 두 부모 모델이 모두 Apache-2.0이므로 Idefics2 자체의 모델 카드는 전체 모델이 Apache-2.0이라고 명시한다 — 원조 Idefics의 라이선스 문제를 해결한 것이다. HuggingFace 자체 설명에 따르면 Idefics2는 약 10분의 1 크기로 Idefics-80B와 동등한 성능을 내며, OCR과 문서 이해가 눈에 띄게 개선되었다.
2024년 8월 22일 출시된 Idefics3(8B)는 SigLIP 비전 인코더를 유지하되 언어 베이스를 Meta-Llama-3.1-8B-Instruct로 전환했다. 자체 모델 카드는 특히 문서 이해, OCR, 시각적 추론에서 Idefics2 대비 상당한 개선을 보여준다. 이는 Hugging Face Transformers 4.46 버전에서 추가되었다.
Idefics는 DeepMind의 Flamingo를 재현한 것인가?
그렇다. 원조 Idefics의 모델 카드는 이를 "DeepMind가 개발한 폐쇄형 비전-언어 모델인 Flamingo의 오픈 액세스 재현물"이라고 명시적으로 설명한다. Idefics2와 Idefics3는 같은 계보 위에서 독립적으로 아키텍처를 설계한 HuggingFace M4의 후속 세대다.
Idefics vs Idefics2 vs Idefics3: 실제로 무엇이 바뀌었나
세 세대는 서로 다른 기반 아키텍처를 가진 별개의 모델이지, 점진적으로 버전이 올라가는 하나의 모델이 아니다. 각 모델 자체의 HuggingFace 카드를 기준으로 확인한 실제 차이는 다음과 같다.
Idefics(9B/80B)
- 출시:
- 2023년
- 베이스:
- LLaMA(1) + 자체 비전 인코더
- 비고:
- LLaMA(1)에서 물려받은 연구 전용 라이선스 제한; 대체로 낡은 버전
Idefics2(8B)
- 출시:
- 2024년 4월
- 베이스:
- Mistral-7B-v0.1 + SigLIP
- 비고:
- 완전히 Apache-2.0; 10분의 1 크기로 Idefics-80B와 동등
Idefics3(8B)
- 출시:
- 2024년 8월 22일
- 베이스:
- Llama-3.1-8B-Instruct + SigLIP
- 비고:
- 셋 중 최고의 OCR/문서 이해; Llama 3.1 라이선스 조건 적용
PromptQuorum은 본 리뷰 작성 시점 기준 공개적으로 확인된 "Idefics4"를 찾지 못했다. Idefics3가 가장 최신 세대이며 대부분의 작업에서 현재 권장 사항이다.
라이선스 세부 사항: 단순한 Apache-2.0이 아니다
PromptQuorum의 디렉터리 목록은 Idefics의 라이선스를 "Apache 2.0"으로 표시한다 — 이는 모델 저장소와 코드 자체에는 정확하지만, 실질적인 라이선스 상황에는 불완전하다. LLaVA의 Apache-2.0 코드 라이선스가 모든 베이스 모델 체크포인트에 자동으로 확장되지 않는 것과 비슷하다.
Idefics2가 가장 명확한 사례다. 언어 베이스인 Mistral-7B-v0.1과 비전 인코더인 SigLIP 모두 Apache-2.0이므로, 전체 모델 스택이 추가 조건 없이 진정으로 Apache-2.0이다.
Idefics3는 더 세부적이다. 자체 HuggingFace 저장소는 Apache-2.0으로 태그되어 있지만, 언어 베이스인 Meta-Llama-3.1-8B-Instruct는 Meta의 Llama 3.1 커뮤니티 라이선스 하에 공개된다 — 이는 수용 가능한 사용 정책과, 다운스트림 제품이 월간 활성 사용자 7억 명을 초과할 경우 Meta로부터 별도의 라이선스가 필요하다는 조항을 포함한다. Idefics3를 상업적으로 대규모 배포하는 누구든 Idefics3 저장소의 Apache-2.0 태그만이 아니라 Meta의 Llama 3.1 라이선스 조건을 직접 읽어야 한다.
원조 Idefics가 가장 제한적이다. 그 LLaMA(1) 베이스는 Meta의 원래 연구 전용, 비상업적 라이선스를 가지며, 이는 비전 인코더와 연결 가중치가 별도로 MIT 라이선스임에도 불구하고 전체 9B/80B 모델의 상업적 사용을 법적으로 잘해야 불명확하게, 최악의 경우 불가능하게 만든다.
Idefics는 상업적으로 무료로 사용할 수 있는가?
세대에 따라 다르다. Idefics2는 추가 제한 없이 완전히 Apache-2.0이다. Idefics3 자체 저장소는 Apache-2.0으로 태그되어 있지만, Llama-3.1-8B-Instruct 베이스는 월간 활성 사용자 7억 명 초과 시 별도 라이선스 요건을 포함한 Meta의 Llama 3.1 커뮤니티 라이선스 조건을 가진다. 원조 Idefics는 LLaMA(1) 베이스로부터 연구 전용, 비상업적 제한을 가진다.
실제 사용 예시: Transformers 라이브러리
Idefics3는 Hugging Face Transformers의 AutoModelForVision2Seq와 AutoProcessor 클래스를 통해 사용되며, Transformers의 Idefics3 모델 문서에 문서화되어 있다. Transformers 4.46 이상 버전이 필요하다.
- 오늘날 Ollama나 llama.cpp 경로는 존재하지 않는다. Idefics는 GGUF 기반 실행 도구가 아니라 Transformers(또는 Text Generation Inference 같은 호환 추론 서버)를 통해 실행된다.
- 이미지 해상도 매개변수를 줄이면 GPU 메모리 사용량을 낮출 수 있다. Idefics2/3의 모델 카드는 처리되는 이미지 서브패치 수를 줄이는 것(Idefics3 문서에서
N으로 지칭)을 정확도와 VRAM을 맞바꾸는 방법으로 문서화하고 있다.
# transformers >= 4.46 필요 (Hugging Face의 Idefics3 모델 문서 기준)
# pip install transformers pillow torch

from transformers import AutoProcessor, AutoModelForVision2Seq
from PIL import Image
import torch

model_id = "HuggingFaceM4/Idefics3-8B-Llama3"

processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForVision2Seq.from_pretrained(
    model_id,
    torch_dtype=torch.float16,
).to("cuda")

image = Image.open("photo.jpg")

messages = [
    {
        "role": "user",
        "content": [
            {"type": "image"},
            {"type": "text", "text": "What is in this image?"},
        ],
    },
]
prompt = processor.apply_chat_template(messages, add_generation_prompt=True)
inputs = processor(text=prompt, images=[image], return_tensors="pt").to("cuda")

generated_ids = model.generate(**inputs, max_new_tokens=200)
generated_text = processor.batch_decode(generated_ids, skip_special_tokens=True)
print(generated_text[0])
VRAM 및 하드웨어 요구 사항
Idefics2와 Idefics3는 비슷한 규모의 LLaVA나 MiniCPM-V 체크포인트보다 눈에 띄게 무거운데, 이는 주로 이미지 해상도를 처리하는 방식 때문이다. 이 수치들은 Idefics2 자체의 모델 카드에서 직접 가져온 것으로, VRAM 범위를 명시적으로 문서화하고 있다. Idefics3(동일한 8B 파라미터 수와 동일한 비전 인코더)도 비슷할 것으로 예상되지만, PromptQuorum은 Idefics3에 특화된 동일한 수준의 상세한 VRAM 표는 찾지 못했다.
구성 | 대략적인 VRAM | 비고 |
|---|---|---|
| float16 + flash-attention | 약 18-20GB | Idefics2 모델 카드에 표준 구성으로 문서화됨 |
| 최적화 없음 | 피크 시 최대 약 55GB | Idefics2 모델 카드의 비최적화 추론 상한선 |
| 공격적인 양자화 | 약 6-7GB | Idefics2 모델 카드에 문서화된 하한선; 정확도 저하를 예상해야 함 |
| LLaVA 7B(비교용) | 약 6-8GB | PromptQuorum의 LLaVA 리뷰 참고 |
📌참고: PromptQuorum은 이 글을 위해 자체 하드웨어 테스트를 진행하지 않았다; 이 수치는 Idefics2의 공개된 모델 카드에서 가져온 것이다. Idefics는 비슷한 능력 등급에서 LLaVA 7B나 MiniCPM-V보다 실제로 더 무겁다 — 리소스가 제한된 배포를 위해 선택하기 전에 사용 가능한 VRAM에 대해 스스로 정직해야 한다.
Idefics가 적합하지 않은 경우
Idefics3는 유능한 오픈 비전-언어 모델이지만, 다음과 같은 상황에는 잘못된 선택이다:
- 리소스가 제한된 로컬 환경. 표준 float16 구성에서 약 18-20GB VRAM이 필요한 Idefics2/3는 LLaVA 7B(약 6-8GB)나 MiniCPM-V(약 5.5GB)보다 눈에 띄게 많은 GPU 메모리가 필요하다. 하드웨어 예산이 VRAM 8GB 이하의 소비자용 GPU 한 대라면, 공격적인 양자화와 정확도 저하를 받아들이지 않는 한 Idefics는 현실적인 선택지가 아니다.
- 실시간 또는 저지연 애플리케이션. 입력마다 여러 이미지 서브패치를 처리하는 8B 파라미터 비전-언어 모델은 가능한 한 빠른 응답 시간을 위해 만들어진 것이 아니다. 지연 시간이 우선순위라면 Moondream(1.8B) 같은 더 작은 모델이 능력은 떨어지지만 더 빠르게 응답한다.
- Ollama나 llama.cpp에 바로 연결하는 워크플로우. Idefics는 현재 Ollama 라이브러리에 패키징되어 있지 않으며, GGUF 변환에는 Ollama 자체 GitHub에서 추적되는 미해결 호환성 문제가 있다. 워크플로우가 특별히 Ollama에 의존한다면, 오늘 실제로 pull 가능한 모델에 대해서는 PromptQuorum의 Ollama 비전 모델 가이드를 참고하라.
- 버전 전반에 걸쳐 단일하고 균일한 라이선스를 가정하는 것. "Idefics"를 단일 라이선스를 가진 단일 제품으로 취급하는 것은 실수다 — 배포하려는 것이 어떤 세대인지 확인하고, 특히 대규모 사용 시 Idefics3의 Llama 3.1 커뮤니티 라이선스 의무 사항 등 해당 모델의 구체적인 라이선스 조건을 읽어야 한다.
대안 및 경쟁 제품
LLaVA
- 가장 적합한 용도:
- Ollama 및 llama.cpp 패키징을 포함한 더 넓은 도구 지원; 7B에서 더 가벼운 VRAM 사용량
- 라이선스:
- Apache-2.0(코드); 체크포인트는 베이스 모델에 따라 다름
LLaVA 관련 문서 (9개)
- LLaVA Review: The Research Model That Started Local Vision AI업데이트 2026년 9월 6일
- Best Local Vision Models 2026: Gemma 4, Qwen3-VL, LLaVA & Ollama Multimodal Setup업데이트 2026년 10월 23일
- MLX vs Ollama vs llama.cpp on Mac 2026: Which Framework for Apple Silicon LLMs?업데이트 2026년 10월 20일
- Multimodal Local LLMs: Vision, Audio, and Text Processing업데이트 2026년 10월 20일
- Ollama Vision Models: How to Actually Run Image Models Locally업데이트 2026년 10월 20일
- LLaMA-Factory Review: Fine-Tune 100+ LLMs via Web UI업데이트 2026년 10월 19일
- Local Image, Video & Vision Tools Compared (2026): Generation, Vision and OCR업데이트 2026년 9월 20일
- MLC Chat Review: The Mobile App Built on MLC LLM, Assessed Honestly업데이트 2026년 9월 7일
- LLM Farm Review: Open-Source GGUF App, Off the App Store업데이트 2026년 9월 6일
표시되지 않은 10개 더보기
Ollama의 비전 모델
- 가장 적합한 용도:
ollama pull/ollama run을 통한 가장 간단한 로컬 설정; 본 리뷰 작성 시점 기준 Idefics는 여기 포함되지 않음- 라이선스:
- 모델에 따라 다름
MLC Chat
- 가장 적합한 용도:
- 여러 플랫폼에 걸친 온디바이스 배포; 본 리뷰 작성 시점 기준 주로 텍스트 중심 — 비전 작업에 의존하기 전에 최신 비전 지원 상태를 확인하라
- 라이선스:
- Apache-2.0
MLC Chat 관련 문서 (6개)
- MLC Chat Review: The Mobile App Built on MLC LLM, Assessed Honestly업데이트 2026년 9월 7일
- Local LLM App Alternatives in 2026: Options to LM Studio, Ollama, Open WebUI and PocketPal AI업데이트 2026년 10월 31일
- Best Local AI Apps for iPhone in 2026 (Run LLMs Without WiFi)업데이트 2026년 10월 30일
- Best Local LLM Apps for Android in 2026: 6 Apps Compared on Real Phones업데이트 2026년 10월 26일
- Best Mobile LLM Models for Phones in 2026: Phi-4 Mini vs Gemma 3 vs SmolLM업데이트 2026년 10월 19일
- Mobile Local LLMs 2026: iPhone 16 Pro, iPad M4 & Snapdragon X업데이트 2026년 8월 28일
기타 언급:
- Running Local AI on the Galaxy S26: On-Device AI Explained (2026)업데이트 2026년 10월 19일
- RunAnywhere Review: On-Device AI SDK for LLM, STT, TTS, and VAD업데이트 2026년 9월 12일
- Galaxy vs iPhone On-Device AI: Samsung Galaxy AI vs Apple Intelligence (2026)업데이트 2026년 8월 29일
클라우드 VLM API(GPT-4o, Claude, Gemini 비전)
- 가장 적합한 용도:
- 이 규모의 로컬 모델보다 멀티모달 성능이 더 높은 경우가 많음, 로컬 하드웨어나 설정 불필요, 다만 프롬프트와 이미지가 제공업체로 전송됨
- 라이선스:
- 독점(유료 API)
자주 묻는 질문
Idefics란 무엇인가?
Idefics는 HuggingFace M4 팀이 만든 오픈 비전-언어 모델 계열로, DeepMind의 Flamingo를 명시적으로 오픈소스 재현한 것으로 설계되었다. 세 세대로 존재한다: 원조 Idefics(2023년, 9B/80B), Idefics2(2024년 4월, 8B), Idefics3(2024년 8월, 8B).
Idefics, Idefics2, Idefics3 중 어떤 버전을 사용해야 하는가?
오늘날 대부분의 작업에는 Idefics3를 사용하라 — 셋 중 가장 강력한 OCR과 문서 이해 능력을 가진다. Llama 파생 조건이 없는 완전한 Apache-2.0 스택이 특별히 필요하다면 Idefics2가 여전히 유효하다. 원조 Idefics는 대체로 낡은 버전이며 연구 전용 라이선스 제한을 가진다.
Idefics는 완전한 오픈소스이며 상업적으로 무료로 사용할 수 있는가?
세대에 따라 다르다. Idefics2는 완전히 Apache-2.0이다. Idefics3의 저장소는 Apache-2.0으로 태그되어 있지만, Llama-3.1-8B-Instruct 베이스는 월간 활성 사용자 7억 명 초과 시의 의무 사항을 포함한 Meta의 Llama 3.1 커뮤니티 라이선스 조건을 가진다. 원조 Idefics는 LLaMA(1) 베이스로부터 연구 전용, 비상업적 제한을 가진다.
Idefics에는 얼마나 많은 VRAM이 필요한가?
Idefics2(그리고 동일한 8B 파라미터 수와 동일한 비전 인코더를 가진 것으로 추정되는 Idefics3)는 Idefics2 모델 카드에 문서화된 표준 flash-attention 포함 float16 구성에서 약 18-20GB의 VRAM이 필요하며, 공격적인 양자화와 정확도 저하를 받아들이면 6-7GB 정도로도 가능하다. 이는 LLaVA 7B나 MiniCPM-V보다 눈에 띄게 무겁다.
Idefics를 Ollama를 통해 실행할 수 있는가?
본 리뷰 작성 시점 기준으로는 불가능하다. Idefics는 현재 Ollama의 모델 라이브러리에 패키징되어 있지 않으며, GGUF 변환에는 Ollama 자체 GitHub 저장소에서 추적되는 미해결 호환성 문제가 있다. Idefics는 대신 Hugging Face Transformers를 통해 실행된다.
Idefics는 DeepMind의 Flamingo를 기반으로 하는가?
Idefics는 자체 모델 카드에서 "DeepMind가 개발한 폐쇄형 비전-언어 모델인 Flamingo의 오픈 액세스 재현물"이라고 명시적으로 설명되어 있다. Idefics2와 Idefics3는 동일한 HuggingFace M4 팀이 독립적으로 아키텍처를 설계한 후속작이다.
결론
Idefics는 진정으로 유용한 오픈 비전-언어 모델 계열이며, 특히 Idefics3는 약 18-20GB의 VRAM 사용량이 감당 가능한 경우 문서 중심의 OCR과 다중 이미지 추론 작업에서 좋은 성능을 보인다. 다만 더 가벼운 로컬 비전 모델을 그대로 대체할 수는 없다: LLaVA 7B나 MiniCPM-V보다 눈에 띄게 많은 GPU 메모리가 필요하고, 본 리뷰 작성 시점 기준 Ollama나 llama.cpp 패키징이 없으며, 라이선스 상황도 세대별로 실제로 다르다 — Idefics2의 깔끔한 Apache-2.0 스택은 Idefics3의 Llama 3.1 커뮤니티 라이선스 의무 사항과는 법적으로 다른 제안이다. GPU 메모리에 여유가 있고 문서 이해와 OCR 품질을 원한다면 Idefics3를 선택하고, 순수한 Apache-2.0 스택이 중요하다면 특별히 Idefics2를 선택하며, 더 가벼운 로컬 하드웨어나 Ollama 기반 워크플로우에는 PromptQuorum의 LLaVA 리뷰를 통해 LLaVA를, 또는 Ollama 비전 모델 가이드의 모델 중 하나를 선택하라.
출처
- Idefics-80B 모델 카드 — Flamingo 재현 명시, 라이선스 구조, 모델 크기.
- Idefics2-8b 모델 카드 — 베이스 모델, Apache-2.0 라이선스, 문서화된 VRAM 범위.
- Idefics3-8B-Llama3 모델 카드 — 베이스 모델, 라이선스 태그, 출시 세부 사항.
- Idefics3 Transformers 문서 — 사용 예시, 최소 Transformers 버전.
- Meta Llama 3.1 커뮤니티 라이선스 — Idefics3의 언어 베이스가 물려받는 라이선스 조건.
- Ollama GitHub 이슈 #2183 및 이슈 #3677 — Idefics가 현재 Ollama 라이브러리에 패키징되어 있지 않음을 확인하는 미해결 기능 요청.