Points clés
- Version testée : 2.2.0, telle qu'affichée sur la fiche App Store.
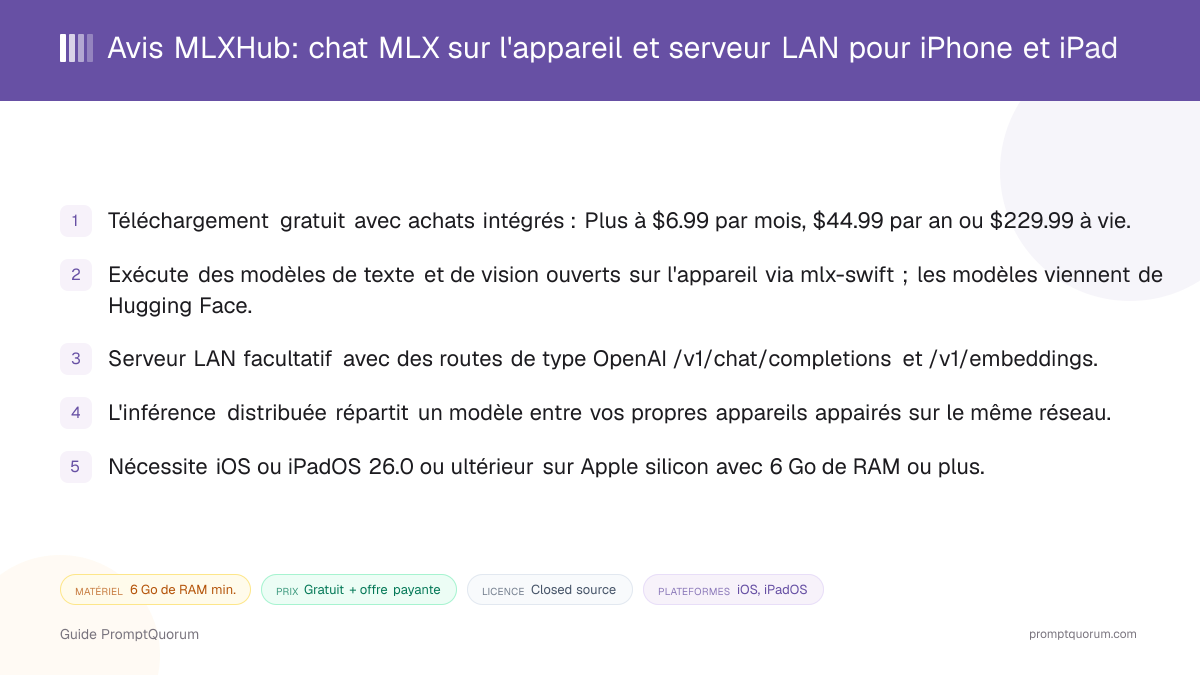
- Prix : téléchargement gratuit ; MLXHub Plus est listé à $6.99 par mois, $44.99 par an et $229.99 à vie.
- Plateforme : iOS et iPadOS 26.0 ou ultérieur ; le site officiel demande Apple silicon et 6 Go de RAM ou plus.
- Points forts : serveur LAN, répartition de modèle entre appareils, outils et compétences, miroirs Hugging Face.
- Ouverture : code source fermé ; aucun dépôt public n'a été trouvé.
📍 En une phrase
MLXHub, du développeur Juan Colilla, est une application iPhone et iPad freemium qui exécute des modèles ouverts hors ligne grâce au framework MLX d'Apple, les sert à votre réseau et peut répartir un modèle sur plusieurs de vos appareils.
💬 En termes simples
Voyez-la comme un exécuteur de modèles que vous gardez dans la poche : le chat fonctionne sans internet une fois un modèle téléchargé, et le même appareil peut servir de petit serveur d'IA privé pour d'autres applications à la maison.
Obtenir MLXHub
MLXHub est distribuée par l'Apple App Store. Le téléchargement pèse 73 Mo et l'application se télécharge gratuitement, avec des achats intégrés.
Cet avis est un complément au répertoire des logiciels LLM locaux de PromptQuorum, qui recense MLXHub aux côtés d'autres outils d'IA locale mobiles et de bureau.
Canal | Obtenir |
|---|---|
| Apple App Store | MLXHub: Local AI & LLM Server sur l'App Store |
| Site officiel | mlxhub.app |
| Politique de confidentialité | Politique de confidentialité de MLXHub |
Aucun dépôt de code source public n'a été trouvé. Il n'existe pas de version Android ; la fiche ne couvre que les plateformes Apple.
MLXHub en bref
Attribut | MLXHub |
|---|---|
| Plateforme | iOS, iPadOS (26.0+) |
| Prix | Gratuit, achats intégrés |
| Licence | Code source fermé |
| Fonctionne hors ligne | Oui, une fois un modèle téléchargé |
| Téléchargement de modèles | Oui, depuis Hugging Face |
| Entrée d'images | Oui, modèles vision-langage |
| Serveur d'API local | Oui, compatible OpenAI sur votre LAN |
| Entrée / sortie vocale | Non indiqué dans la fiche |
Les attributs suivent la comparaison des applications de chat mobiles utilisée dans le répertoire des logiciels LLM locaux. Ils proviennent de la fiche App Store et du site officiel, qui ne couvrent pas toutes les fonctionnalités.
Ce qu'est MLXHub
MLXHub est d'abord un exécuteur de modèles sur l'appareil, et ensuite seulement un client de chat. La fiche (citations traduites de l'anglais) met en avant un « chat privé hors ligne et des outils » et dit qu'elle permet d'« exécuter des modèles plus gros pris en charge et de servir le chat et les embeddings sur votre réseau local ». Le site officiel indique qu'elle est développée nativement en Swift sur mlx-swift, le framework MLX d'Apple pour Apple silicon.
Elle est publiée par Juan Colilla, avec la mention de copyright « DreamFoundries EU ». Ne la confondez pas avec mlxhub.ai, une application distincte réservée à macOS, d'un autre développeur, qui porte le même nom.
Cet avis s'appuie uniquement sur la fiche App Store et le site officiel. Il n'inclut pas de tests pratiques ; la vitesse, la stabilité et la qualité des réponses ne sont donc pas évaluées ici.
Comment commencer
La mise en route consiste à installer l'application depuis l'App Store, puis à télécharger un modèle depuis Hugging Face. La fiche ne documente pas le premier lancement ; les étapes ci-dessous suivent donc ce qu'indiquent la fiche et le site.
- 1Vérifier l'appareil et le système
Why it matters: La fiche exige iOS ou iPadOS 26.0 ou ultérieur, et le site officiel demande un appareil Apple silicon avec 6 Go de RAM ou plus. - 2Installer MLXHub
Why it matters: Obtenez-la sur l'[App Store](https://apps.apple.com/us/app/mlxhub-local-ai-llm-server/id6766485144) ; le téléchargement pèse 73 Mo. - 3Télécharger un modèle
Why it matters: Choisissez un modèle ouvert dans le catalogue Hugging Face intégré. L'application indique s'il tient en mémoire, mais les métadonnées de Hugging Face sont parfois incohérentes. - 4Discuter, puis activer éventuellement le serveur LAN
Why it matters: Une fois un modèle téléchargé, le chat fonctionne sans connexion. Le serveur LAN est facultatif et permet à d'autres applications de votre Wi-Fi d'utiliser les modèles chargés.
Fonctionnalités
L'atout de MLXHub, c'est l'étendue de ce qui entoure l'exécuteur de modèles. Tout ce qui suit provient de la fiche App Store et du site officiel.
- Modèles. Télécharge des modèles ouverts de texte et de vision-langage depuis Hugging Face ; la fiche cite Qwen3.6 35B-A3B, Bonsai 2 27B et des modèles Gemma. Les conversations texte seul ne chargent les composants de vision qu'en cas de besoin, pour économiser la mémoire.
- Mémoire et compétences. Un système de mémoire conserve des faits issus des conversations, et vous pouvez créer des compétences personnalisées réutilisables.
- Outils natifs. Des outils prédéfinis accèdent aux frameworks Apple tels que Calendrier, Rappels, Santé, Photos et la médiathèque musicale ; la fiche ne détaille pas ce que fait chaque outil.
- Vitesse et adéquation. Le cache KV accélère les conversations à plusieurs tours, et un test de charge de la RAM évalue la marge mémoire de votre appareil avant de charger un modèle.
- Changement de modèle et miroirs. Passez d'un modèle de texte à un modèle de vision en pleine conversation, et utilisez un miroir Hugging Face communautaire quand Hugging Face est bloqué.
- Diffusion de gros modèles. La fiche mentionne le streaming d'experts depuis la NAND pour les modèles plus gros comme Qwen3.6 35B-A3B, sans plus de détails.
- Langues. L'interface est disponible en anglais et dans 11 autres langues.
Serveur LAN et inférence distribuée
Le serveur LAN transforme votre appareil en petit point d'accès compatible OpenAI. La fiche nomme les routes /v1/chat/completions et /v1/embeddings. Selon le site officiel, il sert aussi une page de chat légère que toute personne sur le même Wi-Fi peut ouvrir dans un navigateur pour dialoguer avec les modèles chargés, et il n'écoute que sur les interfaces locales, sans redirection de port.
L'inférence distribuée met en commun plusieurs de vos propres appareils. Un appareil héberge et les autres le rejoignent, chacun prenant une tranche des couches du modèle, de sorte qu'un modèle qu'aucun ne peut contenir seul peut se charger. Le site indique que les appareils sont appairés et le trafic chiffré, et que rien ne quitte le réseau. Le débit sur Wi-Fi n'est pas publié ; attendez-vous donc à un fonctionnement plus lent que sur un seul appareil capable de contenir le modèle.
Configuration requise
MLXHub exige iOS ou iPadOS 26.0 ou ultérieur, un appareil Apple silicon et 6 Go de RAM ou plus. Le site officiel recommande une puce A17 Pro ou M1, ou plus récente. La fiche App Store indique aussi une disponibilité pour macOS 26.0 (Apple M1 ou ultérieur) et visionOS 26.0 pour la même application, sans décrire de version de bureau distincte.
La RAM est la vraie limite. Apple impose des limites de mémoire par application plus strictes sur l'iPhone que sur l'iPad ; les modèles plus gros tiennent donc plus souvent sur un iPad. Le site prévient qu'un modèle qui ne tient pas peut parfois être téléchargé quand même, et que l'application tente d'en empêcher le chargement avant qu'iOS ne ferme l'application, sans garantie.
Tarifs et confidentialité
MLXHub se télécharge gratuitement, avec MLXHub Plus listé à $6.99 par mois, $44.99 par an et un achat à vie à $229.99. Ni la fiche ni le site n'indiquent quelles fonctionnalités Plus débloque ; vérifiez donc l'écran d'achat dans l'application avant de compter sur une fonctionnalité. Les modèles se téléchargent gratuitement depuis Hugging Face, sans frais par token.
Le site officiel indique que l'inférence se fait entièrement sur l'appareil, qu'il n'y a pas de compte et que rien ne vous identifie. Il précise aussi que, depuis la version 2.0.0, l'application envoie des données d'analyse et de diagnostic anonymes, couvrant les fonctionnalités utilisées, la classe d'appareil et le chargement réussi ou non d'un modèle, et que vous pouvez les désactiver dans les Réglages.
L'application est à code source fermé et cet avis n'a pas inspecté le trafic réseau ; les affirmations de confidentialité sont donc celles du développeur. Si vous activez le serveur LAN, les données qui y transitent sont aussi privées que votre réseau Wi-Fi.
Compromis : avantages vs. limites
Inférence MLX hors ligne
- Ce que cela signifie en usage réel:
- Discutez avec des modèles ouverts sans connexion, avec le framework d'Apple.
- Limite / réserve:
- Exige iOS 26 et 6 Go de RAM ; les limites mémoire de l'iPhone plafonnent la taille des modèles.
Serveur LAN
- Ce que cela signifie en usage réel:
- D'autres applications et navigateurs de votre Wi-Fi peuvent utiliser les modèles chargés.
- Limite / réserve:
- L'appareil doit rester allumé et connecté au réseau ; aucun chiffre de débit n'est publié.
Répartition entre appareils
- Ce que cela signifie en usage réel:
- Chargez un modèle qu'aucun de vos appareils ne peut contenir seul.
- Limite / réserve:
- La vitesse sur Wi-Fi n'est pas documentée et il faut plusieurs appareils compatibles.
Outils, mémoire et compétences
- Ce que cela signifie en usage réel:
- Accédez à Calendrier, Rappels et Santé depuis un chat.
- Limite / réserve:
- La fiche ne détaille pas ce que fait chaque outil.
Gratuite pour commencer
- Ce que cela signifie en usage réel:
- Pas de frais par token ; les modèles sont gratuits sur Hugging Face.
- Limite / réserve:
- Plus coûte jusqu'à $229.99 à vie, et ce qu'il débloque n'est pas indiqué.
MLXHub vs. alternatives
MLXHub
- Plateformes:
- iOS, iPadOS
- Prix et licence:
- Freemium, code source fermé
- Source des modèles:
- Hugging Face (MLX)
- Différence clé:
- Serveur LAN et répartition de modèle entre appareils ; pas open source
Locally AI
- Plateformes:
- iOS, Mac
- Prix et licence:
- Freemium, code source fermé
- Source des modèles:
- Catalogue de modèles intégré
- Différence clé:
- Chat sur l'appareil plus simple ; aucun serveur LAN listé
Articles sur Locally AI (4)
- Locally AI Review: Private Offline LLMs on iPhone, iPad and MacMis à jour 4 septembre 2026
- Oscilla Review: Free On-Device AI Chat for iPhoneMis à jour 4 octobre 2026
- Local Chat Apps & Assistants Compared (2026): Desktop, Mobile, Self-Hosted, Assistants and RoleplayMis à jour 20 septembre 2026
- Best Local LLM Apps for iPhone in 2026 (Run AI Without WiFi)Mis à jour 1 septembre 2026
Également mentionné dans :
- Tina Review: iPhone Client for Ollama, llama.cpp and ComfyUIMis à jour 4 octobre 2026
- Private LLM Review: On-Device AI Chat for iPhone, iPad, and MacMis à jour 5 septembre 2026
Private Mind
- Plateformes:
- iOS, Android
- Prix et licence:
- Gratuit, MIT
- Source des modèles:
- Téléchargements Hugging Face
- Différence clé:
- Open source et aussi sur Android ; aucun serveur LAN listé
Articles sur Private Mind (1)
- Private Mind Review: Open-Source Offline AI Chat for iPhone and AndroidMis à jour 3 octobre 2026
Également mentionné dans :
- Local AI: Offline Chat & Image Review: Free Android App with Stable Diffusion and Prompt ToolkitsMis à jour 9 octobre 2026
- TokForge Review: Offline Android AI Chat with Roleplay and Image GenerationMis à jour 9 octobre 2026
- LLM Hub Review: On-Device AI Suite for Android and iPhoneMis à jour 3 octobre 2026
Oscilla
- Plateformes:
- iOS
- Prix et licence:
- Gratuit, code source fermé
- Source des modèles:
- 40+ modèles intégrés
- Différence clé:
- Catalogue fixe plus large ; moteur non nommé
Articles sur Oscilla (1)
- Oscilla Review: Free On-Device AI Chat for iPhoneMis à jour 4 octobre 2026
PocketPal AI
- Plateformes:
- iOS, Android
- Prix et licence:
- Gratuit, MIT
- Source des modèles:
- Modèles GGUF
- Différence clé:
- Open source, basé sur llama.cpp, multiplateforme
Articles sur PocketPal AI (10)
- PocketPal AI Review: Free, Open-Source On-Device ChatMis à jour 5 septembre 2026
- PAIOS Review: Offline Gemini Nano Chat for AndroidMis à jour 5 octobre 2026
- Oscilla Review: Free On-Device AI Chat for iPhoneMis à jour 4 octobre 2026
- Local Chat Apps & Assistants Compared (2026): Desktop, Mobile, Self-Hosted, Assistants and RoleplayMis à jour 20 septembre 2026
- OlliteRT Review: Turn an Android Phone Into a Local LLM ServerMis à jour 19 septembre 2026
- AI on Device Review: A $4.99 Apple Intelligence-Only AppMis à jour 12 septembre 2026
- Google AI Edge Gallery Review: Gemma 4 On-Device Chat for iPhoneMis à jour 12 septembre 2026
- Noema Review: Multi-Format Local AI for iPhone, iPad, and MacMis à jour 12 septembre 2026
- AnythingLLM Mobile Review: On-Device Chat + RAGMis à jour 6 septembre 2026
- Chapper Review: AI & LM Studio Client for iPhone, iPad, and MacMis à jour 6 septembre 2026
+20 autres non affichés
Les détails de plateforme, de prix et de fonctionnalités des applications tierces changent fréquemment. Vérifiez les spécificités actuelles sur la fiche de chaque application avant de décider.
Qui devrait utiliser MLXHub
- Les propriétaires d'iPad et d'iPhone récents qui veulent les plus gros modèles que leur appareil peut contenir. MLX, le streaming et la mise en commun d'appareils visent tous cette limite.
- Les bricoleurs qui veulent un serveur d'IA de poche. Le point d'accès LAN compatible OpenAI permet à des scripts et à d'autres applications de votre réseau d'utiliser l'appareil.
- Les personnes qui possèdent plusieurs appareils Apple. La répartition entre appareils est la fonctionnalité que la plupart des alternatives ne listent pas.
Qui ne devrait pas utiliser MLXHub
- Toute personne qui a besoin d'open source. Le code n'est pas public ; Private Mind et PocketPal AI sont open source.
- Les utilisateurs d'Android. Seules les plateformes Apple sont listées ; PocketPal AI et Private Mind fonctionnent tous deux sur Android.
- Les appareils sous iOS 26 ou avec moins de 6 Go de RAM. La fiche et le site fixent ces seuils.
- Ceux qui veulent une liste de fonctionnalités explicite pour l'offre payante. Ce que MLXHub Plus débloque n'est pas documenté ; essayez d'abord la version gratuite.
Questions fréquentes
MLXHub est-elle gratuite ?
Elle se télécharge gratuitement, avec des achats intégrés : MLXHub Plus à $6.99 par mois, $44.99 par an ou $229.99 à vie, comme indiqué sur la fiche App Store.
Qui développe MLXHub ?
Juan Colilla, avec la mention de copyright « DreamFoundries EU ». L'application mlxhub.ai est un produit différent, réservé à macOS.
MLXHub envoie-t-elle mes conversations quelque part ?
Le site indique que l'inférence se fait entièrement sur l'appareil. Des données d'usage et de diagnostic anonymes sont envoyées depuis la version 2.0.0 et peuvent être désactivées dans les Réglages.
MLXHub fonctionne-t-elle sur Android ?
Non. La fiche ne couvre que l'iPhone, l'iPad et, selon le store, la compatibilité avec les Mac Apple M1 et l'Apple Vision Pro.
Quels modèles puis-je exécuter ?
Des modèles ouverts de texte et de vision au format MLX depuis Hugging Face. La fiche cite Qwen3.6 35B-A3B, Bonsai 2 27B et des modèles Gemma.
Verdict
Sur le papier, MLXHub convient bien à qui possède un iPad ou un iPhone récent et veut un chat MLX hors ligne, avec la possibilité d'utiliser l'appareil comme point d'accès local ou de mettre plusieurs appareils en commun pour un modèle plus gros.
Les réserves tiennent à la transparence et à la jeunesse du projet : le code est fermé, les fonctionnalités Plus ne sont pas documentées, la vitesse de la répartition entre appareils n'est pas publiée, et la fiche n'affichait que sept notes au moment de l'avis.
Si vous voulez de l'open source, commencez par Private Mind. Si vous voulez le serveur LAN ou la répartition entre appareils, essayez d'abord la version gratuite de MLXHub.
Sources
- MLXHub: Local AI & LLM Server sur l'App Store — version, prix, configuration requise, fonctionnalités et développeur.
- Site officiel de MLXHub — descriptions des fonctionnalités, configuration requise et FAQ, y compris la déclaration sur les données d'analyse.
- Politique de confidentialité de MLXHub — page de politique liée depuis le site officiel.